Анализ ключевых слов и семантики конкурентов


Собственное семантическое ядро редко охватывает все запросы, по которым сайт способен получать целевой поисковый трафик. Часть тем находится через Keyword Planner, подсказки Google и Search Console, но заметный пласт семантики можно обнаружить только после изучения сайтов, которые уже занимают позиции в нужной нише.
Анализ ключевых слов конкурентов показывает, какие запросы приводят пользователей на другие сайты, какие URL получают органическую видимость и какие темы отсутствуют в вашей структуре. После очистки и кластеризации этих данных можно найти новые посадочные страницы, расширить существующий контент и точнее расставить приоритеты в SEO.
Что такое анализ ключевых слов конкурентов?
Анализ ключевых слов сайта конкурента начинается со сбора запросов, по которым его домен или отдельные страницы появляются в органической выдаче. SEO-сервисы связывают поисковые запросы с URL, позициями, частотностью, примерным трафиком и другими метриками, после чего данные можно сравнить со своим сайтом.
Внутри SEO-команд такую работу иногда называют «анализ ключевиков конкурентов», хотя задача значительно шире простой выгрузки списка фраз. Нужно понять, почему конкретная страница получает видимость, к какому интенту относится запрос, какие темы объединены на одном URL и какие элементы структуры помогают сайту охватывать семантику.
Какие данные можно получить из семантики конкурентов?
Семантика конкурентов показывает гораздо больше, чем перечень фраз из поисковой базы. При анализе домена можно увидеть связь между запросами, страницами и видимостью, а затем определить направления, которые имеют смысл проверять для собственного проекта.
Обычно в рабочую выгрузку включают следующие данные:
- поисковый запрос, URL и текущую позицию страницы в выбранном регионе;
- частотность запросов, динамику спроса и возможную сезонность темы;
- расчётный поисковый трафик и общую видимость сайта по группе фраз;
- страницы конкурентов, которые собирают большое количество связанных запросов;
- коммерческие запросы, информационные запросы и смешанные группы интентов;
- пересечение семантики между несколькими доменами и упущенные запросы собственного сайта.
После выгрузки данные всё равно требуют ручной проверки. Метрики сторонних сервисов рассчитываются по собственным базам, поэтому точные показатели трафика чужого домена известны только его владельцу.
Чем анализ семантики отличается от копирования чужих ключей?
Ключевые слова сайта конкурента нельзя автоматически переносить в собственное семантическое ядро. Один домен может продавать больше товаров, работать в других городах, продвигать дополнительные услуги или иметь большой блог, который вашему проекту не нужен.
Каждую группу запросов проверяют по бизнесу, региону, языку и поисковому интенту. Если конкурент получает трафик по товару, которого у вас нет, такая фраза остаётся аналитическим сигналом и не превращается в задачу для контента.
Отдельно оценивают брендовые запросы. Чужие названия компаний часто занимают заметную долю выгрузки и искажают картину, поэтому их обычно выделяют в отдельный сегмент или удаляют перед кластеризацией.
Ответы на ваши вопросы
Как узнать ключевые слова конкурентов?
Самый быстрый способ – ввести домен конкурента в SEO-сервис и открыть отчёт по органическим запросам. В нём обычно доступны запрос, позиция, частотность, URL и расчётная видимость.
Для более точного результата нужно выбрать нужный регион и язык, а затем удалить брендовые и нерелевантные фразы. Полученную выгрузку лучше сравнивать ещё с несколькими прямыми конкурентами.
Как определить ключевые слова сайта конкурента?
Можно анализировать весь домен или конкретный URL. Доменный отчёт подходит для поиска крупных тематических кластеров, а анализ отдельной страницы удобен при сравнении конкретной услуги, категории или статьи.
После получения данных запросы сортируют по позициям, частотности и страницам. Затем проверяют их интент и оставляют только те группы, которые соответствуют вашему бизнесу.
Как найти конкурентов по ключевым словам?
Введите несколько основных запросов в Google и зафиксируйте домены, которые регулярно повторяются в выдаче. Проверять нужно одинаковый регион, язык и тип устройства, если он имеет значение для проекта.
Дополнительно можно использовать SEO-сервис, который найдёт сайты по пересечению органической семантики. Итоговый список всё равно стоит проверить вручную, чтобы удалить агрегаторы и ресурсы другого типа.
Как собрать семантику конкурентов?
Сначала выбирают несколько релевантных доменов, затем выгружают их поисковые запросы и объединяют данные в одной таблице. После этого удаляют дубли, бренды, неподходящие регионы и запросы другого интента.
Очищенную базу кластеризуют и сопоставляют с существующими URL. Новые группы становятся кандидатами на отдельные посадочные страницы или материалы блога.
Что такое парсинг ключевых слов конкурентов?
Парсинг означает автоматизированный сбор запросов, по которым конкурентные домены или страницы присутствуют в поисковых базах. Вместе с фразами обычно получают позиции, URL, частотность и другие доступные метрики.
Такой способ удобен при работе с тысячами запросов. После автоматического сбора всё равно требуется ручная фильтрация, потому что база содержит нерелевантные и неоднозначные фразы.
Как узнать ключевые слова конкурентов в Директе?
Для этого используют сервисы анализа платной рекламы, которые сохраняют объявления, посадочные страницы и рекламные запросы. Такие данные помогают понять, какие коммерческие темы конкуренты поддерживают рекламным бюджетом.
Для проектов, работающих с Google, аналогичные данные изучают по Google Ads и PPC-сервисам. Рекламную семантику лучше хранить отдельно от органического SEO-ядра.
Нужно ли добавлять все ключевые слова конкурентов в своё ядро?
Нет, значительная часть выгрузки может не соответствовать вашему сайту. Чужие бренды, отсутствующие товары, другой регион и неподходящий интент обычно исключают до кластеризации.
Каждый спорный кластер лучше проверить в поисковой выдаче. Если запрос невозможно связать с полезной страницей и реальным предложением бизнеса, добавлять его в ядро нет смысла.
Как найти ключевые слова, по которым конкуренты ранжируются, а мой сайт нет?
Используйте отчёт Keyword Gap или Content Gap и сравните свой домен с несколькими конкурентами. Сервис покажет запросы, где другие сайты получают позиции, а ваш домен отсутствует или находится значительно ниже.
После выгрузки проверьте приоритетные группы вручную. Сначала оценивают коммерческую ценность и интент, затем решают, дорабатывать существующий URL или создавать новую страницу.
Зачем анализировать ключевые слова конкурентов?
Анализ ключевых запросов конкурентов помогает увидеть спрос с точки зрения уже существующей поисковой выдачи. Если несколько сильных сайтов создают отдельные страницы под одну тему и получают по ним видимость, этот паттерн стоит проверить для собственного проекта.
Основная польза появляется после сопоставления чужой семантики со своей структурой. В результате становятся видны запросы без подходящих страниц, слабые URL, недостаточно раскрытые темы и кластеры, которые раньше не попадали в семантическое ядро.
Найти упущенные поисковые запросы
Keyword gap показывает фразы, по которым один или несколько конкурентов присутствуют в поиске, а ваш домен не получает заметной видимости. Такой отчёт хорошо работает как первый фильтр перед детальным анализом новых направлений.
Упущенный запрос ещё не означает, что под него нужно создавать отдельный URL. Сначала проверяют поисковую выдачу, тип ранжирующихся страниц и поисковый интент, после чего запрос добавляют к существующему кластеру или выделяют в новую группу.
Особенно полезны фразы, которые встречаются сразу у нескольких прямых SEO-конкурентов. Повторяемость снижает вероятность того, что перед вами случайная тема, характерная только для одного сайта.
Расширить семантическое ядро
Сбор семантики конкурентов хорошо дополняет классическую работу с маркерными запросами и поисковыми подсказками. Через чужие домены часто находятся разговорные формулировки, узкие товарные признаки, региональные варианты и длинные запросы, которые сложно придумать вручную.
После объединения нескольких выгрузок удаляют дубли, нерелевантные фразы и запросы с неподходящим интентом. Оставшуюся семантику связывают с существующими URL или отправляют на кластеризацию для поиска новых посадочных страниц.
Такой подход особенно полезен в больших нишах. Чем шире ассортимент или перечень услуг, тем выше вероятность пропустить отдельные группы спроса при сборе семантики только от исходных маркеров.
Найти идеи для новых страниц
У конкурентов можно увидеть типы посадочных, которые отсутствуют в вашей структуре. Это могут быть категории, подкатегории, страницы отдельных услуг, географические страницы, фильтры, сравнения, инструкции или статьи под информационный спрос.
Перед созданием URL проверяют, существует ли отдельный интент в Google. Если по группе запросов выдача стабильно показывает самостоятельные страницы конкурентов, появляется основание рассмотреть отдельную посадочную на своём сайте.
Для интернет-магазина таким сигналом могут быть подкатегории по назначению товара. Для услуг часто обнаруживаются страницы отдельных процедур, задач клиента, городов или типов работ.
Понять структуру сайтов из TOP выдачи
Анализ конкурентов по ключевым словам помогает восстановить логику структуры, даже если меню сайта показывает её только частично. Связка «запрос – URL – кластер» показывает, какие темы конкуренты объединяют, а какие разводят по отдельным страницам.
Полезно смотреть не только на количество URL. Нужно сравнивать вложенность, хлебные крошки, внутренние ссылки и повторяющиеся элементы навигации, чтобы понять роль каждой страницы внутри раздела.
Такая работа особенно полезна перед расширением каталога или раздела услуг. Сначала появляется карта спроса, затем структура сайта получает страницы под подтверждённые поисковые интенты.
Найти темы для контента
Информационные страницы конкурентов показывают вопросы, которые пользователи задают до покупки или обращения за услугой. Если такие материалы стабильно получают видимость, их можно включить в собственный контент-план после проверки релевантности.
Стоит оценивать не только название статьи. Нужно посмотреть, какие H2 и H3 используются, какие вопросы раскрываются в FAQ, какие коммерческие страницы получают внутренние ссылки из материала.
Хороший контентный кластер помогает закрывать информационный спрос и передавать внутренний вес страницам услуг. Для этого темы блога связывают с коммерческими URL логичными ссылками, без искусственного повторения анкоров.
Как определить настоящих SEO-конкурентов?
Бизнес-конкуренты и SEO-конкуренты часто пересекаются только частично. Компания может работать в той же нише, но почти не присутствовать в органической выдаче, тогда как информационный портал или крупный маркетплейс будет занимать позиции по сотням нужных запросов.
Для анализа семантики нужны сайты, которые регулярно встречаются в Google по целевым кластерам. Их состав может отличаться для коммерческих, информационных и локальных запросов, поэтому один универсальный список конкурентов редко подходит для всего проекта.
Поиск конкурентов через Google
Начните с нескольких маркерных запросов, которые точно описывают основные товары, услуги или информационные темы. Проверяйте выдачу в нужном регионе и языке, иначе список доменов получится искажённым.
Записывайте сайты, которые повторяются в результатах по разным запросам. Затем разделите их по типу: прямые компании, маркетплейсы, каталоги, информационные ресурсы и сервисы.
После первичного сбора стоит проверить:
- сколько целевых запросов пересекается с каждым доменом;
- какие типы страниц чаще всего конкурируют с вашими URL;
- насколько совпадают товары, услуги, регион и целевая аудитория;
- присутствует ли сайт в выдаче стабильно по нескольким связанным кластерам.
После такой проверки остаётся рабочая группа доменов для дальнейшего анализа. Обычно несколько релевантных конкурентов дают более полезную картину, чем десятки случайных сайтов из одной выдачи.
Поиск конкурентов по ключевым словам через SEO-сервисы
SEO-платформы могут автоматически находить домены с большим пересечением семантики. Для этого достаточно ввести свой сайт, отдельный URL или маркерный запрос и выбрать нужную поисковую базу.
Поиск конкурентов по ключевым словам через сервис удобен для крупных проектов, где ручная проверка сотен запросов занимает слишком много времени. После автоматического списка всё равно нужно удалить сайты другого типа, агрегаторы и ресурсы с неподходящим коммерческим предложением.
Анализ конкурентов по ключевым словам становится точнее, когда автоматический отчёт сравнивают с реальной SERP. База сервиса показывает масштаб пересечения, а Google помогает проверить фактический интент и тип страниц.
Почему нельзя анализировать только одного конкурента?
Один сайт может иметь сильную структуру в коммерческом разделе и слабый блог, другой – хорошо собирать информационный трафик, но почти не развивать категории. Если взять только один домен, его особенности легко принять за общий стандарт ниши.
Сравнение нескольких сайтов показывает повторяющиеся решения. Когда три или четыре конкурента используют похожую структуру, создают отдельные страницы под один кластер и получают по ним позиции, такой паттерн заслуживает отдельной проверки.
Также несколько источников уменьшают зависимость от случайных запросов. Объединённая выборка лучше показывает темы, которые регулярно встречаются в нише и могут приносить целевой органический трафик.
Как провести анализ ключевых слов сайта конкурента?
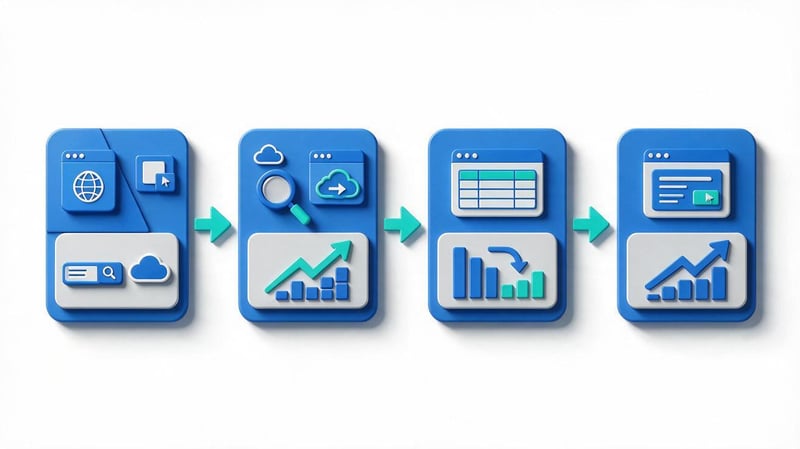
Анализ ключевых слов сайта конкурента удобнее выполнять по этапам, чтобы не получить огромную таблицу без понятной цели. Сначала выбирают объект анализа, затем выгружают запросы, ищут разрыв с собственным сайтом и только после этого переходят к страницам и структуре.
Такой порядок экономит время на очистке. Вместо работы со всей базой домена можно быстро определить группы с реальным потенциалом и сосредоточиться на них.
Шаг 1. Введите домен или URL конкурента
Для общего анализа используют домен. Такой отчёт показывает семантику всего сайта и подходит для поиска новых разделов, крупных кластеров и страниц-лидеров.
Отдельный URL нужен, когда сравниваются конкретные посадочные. Например, собственная страница услуги находится на второй странице Google, а конкурент стабильно занимает верхние позиции по тому же набору запросов.
Анализ сайта конкурента на ключевые слова лучше начинать с домена, а затем углубляться в приоритетные URL. Так видна общая структура спроса и одновременно сохраняется возможность детально разобрать конкретные страницы.
Шаг 2. Выгрузите ключевые слова сайта конкурента
В рабочую таблицу стоит включить запрос, URL, позицию, частотность, регион, поисковую систему и доступную оценку трафика. При наличии дополнительных данных полезно сохранить CPC, динамику позиций и элементы поисковой выдачи.
Если задача состоит в том, чтобы определить ключевые слова сайта конкурента для одного раздела, заранее фильтруйте URL. Такой подход сокращает количество мусора и облегчает последующую кластеризацию.
После экспорта не спешите удалять низкочастотные фразы. Они часто уточняют интент, показывают дополнительные свойства продукта и помогают понять, почему несколько похожих запросов ведут на разные страницы.
Шаг 3. Найдите запросы, которых нет на вашем сайте
Следующий этап – сравнение семантики двух или нескольких доменов. Keyword gap делит запросы на общие, упущенные и уникальные, после чего каждую группу можно анализировать отдельно.
Запрос «узнать ключевые запросы конкурентов» обычно подразумевает именно такую задачу. Пользователю нужен список тем, где конкурент уже получает видимость, а собственный сайт пока отсутствует или занимает слабые позиции.
Работать с найденными группами удобно по приоритету:
| Группа запросов | Относительный приоритет |
|---|---|
| Упущенные коммерческие запросы | 100% |
| Слабые существующие страницы | 80% |
| Новые информационные кластеры | 60% |
| Уникальные темы одного конкурента | 30% |
Проценты показывают относительный приоритет групп при первичной обработке, а не прогноз трафика или конверсии. Конкретный порядок зависит от целей проекта, состояния текущих страниц и коммерческой ценности найденной семантики.
Общие запросы
Общие запросы показывают зоны прямой конкуренции. Если оба сайта ранжируются по одной группе, можно сравнить позиции, типы страниц, полноту контента, мета-теги и внутреннюю перелинковку.
Особое внимание стоит уделить запросам, где ваш URL уже находится рядом с первой страницей. Иногда рост можно получить через доработку существующего материала без создания нового документа.
Такие группы также полезны для проверки каннибализации. Если несколько собственных страниц конкурируют между собой по одинаковому интенту, структуру и внутренние сигналы стоит пересмотреть.
Упущенные запросы
Упущенные запросы – самая интересная часть конкурентного анализа. Они показывают темы, где спрос уже подтверждён выдачей, но собственный сайт пока не имеет заметной страницы или видимости.
Сначала проверяют релевантность бизнеса, затем SERP и только после этого решают, нужен новый URL или доработка существующего. Отдельная страница оправдана, когда поисковый интент и состав результатов заметно отличаются.
Высокая частотность сама по себе не делает запрос приоритетным. Узкая коммерческая фраза с меньшим спросом иногда приносит больше пользы, если точно соответствует услуге и находится близко к покупке.
Уникальные запросы одного конкурента
Уникальные запросы могут показывать интересные направления, но требуют самой осторожной проверки. Часто туда попадают брендовые фразы, старые страницы, нерелевантные товары или темы из крупного блога.
Сначала определите, связан ли запрос с вашим предложением. Затем посмотрите выдачу и убедитесь, что тип страницы соответствует структуре проекта.
Если тема встречается только у одного конкурента и не подтверждается другими доменами, её лучше оставить в отдельном списке для дополнительного анализа. Это снижает риск создавать страницы под случайный спрос.
Шаг 4. Проанализируйте страницы-лидеры конкурента
После работы с запросами переходите к URL, которые получают максимальную видимость по релевантным группам. Такие страницы показывают, какие темы конкуренту удалось объединить и какие элементы контента поддерживают ранжирование.
Для каждой страницы стоит проверить Title, H1, структуру H2–H3, объём полезного материала, таблицы, FAQ, внутренние ссылки и тип контента. Отдельно смотрят, какие разделы ссылаются на этот URL и куда он передаёт внутренний вес.
Мета-теги сами по себе не объясняют высокие позиции. Их нужно анализировать вместе с интентом, структурой страницы, качеством раскрытия темы и общей архитектурой сайта.
Как собрать семантику конкурентов?
Сбор семантики конкурентов лучше проводить по нескольким релевантным доменам. Один источник показывает только часть спроса, а объединённая база помогает увидеть повторяющиеся кластеры и сравнить разные подходы к структуре.
Перед началом задайте границы анализа: регион, язык, тип страниц и нужные разделы. Эти ограничения заметно сокращают объём последующей ручной очистки.
Объедините семантику нескольких сайтов
Выгрузки разных конкурентов сводят в одну таблицу и сохраняют источник каждого запроса. Затем одинаковые фразы объединяют, а для каждой строки считают количество доменов, где она встречается.
Чем больше релевантных конкурентов ранжируется по запросу, тем полезнее проверить его вручную. Повторяемость показывает устойчивый интерес в нише, хотя окончательное решение всё равно зависит от интента.
Удобно добавить отдельные колонки для собственного URL, текущей позиции и статуса. Так таблица сразу показывает, где страница существует, где требует доработки и где нужно рассмотреть новый документ.
Проведите парсинг ключевых слов конкурентов
Парсинг ключевых слов конкурентов нужен при большом объёме данных, когда ручной сбор занимает слишком много времени. Специализированные сервисы получают запросы из собственных баз и связывают их с доменами, URL и позициями.
Парсер ключевых слов конкурентов особенно полезен для крупных каталогов и широких тематик. Он помогает собрать тысячи фраз, но качество итогового ядра всё равно зависит от фильтрации и проверки человеком.
Подбор ключевых слов конкурентов стоит вести отдельными группами. Коммерческие страницы, блог, категории и географические разделы лучше анализировать раздельно, чтобы запросы разного интента не смешивались в одном массиве.
Какие данные выгружать?
Минимальная таблица должна содержать запрос, частотность, позицию, URL, источник и регион. Для сложных проектов добавляют поисковую систему, дату проверки, CPC и предполагаемый тип интента.
Полезно также сохранить признаки SERP, если сервис их предоставляет. Карты, изображения, видео, товарные блоки или расширенные ответы могут влиять на ожидаемый CTR и формат будущей страницы.
После выгрузки исходные данные лучше сохранить отдельно. Рабочую копию можно фильтровать и менять без риска потерять первоначальную информацию, если позже понадобится повторный анализ.
Очистите собранные запросы
Сначала удаляют технические дубли и приводят данные к единому формату. Затем фильтруют чужие бренды, неподходящие регионы, отсутствующие товары, нерелевантные услуги и очевидный информационный шум.
Фильтрация семантики требует ручного просмотра неоднозначных фраз. Короткий запрос может иметь несколько значений, поэтому решение по нему лучше принимать после просмотра поисковой выдачи.
После очистки желательно оставить причину удаления в отдельной колонке. Такой подход полезен при повторной проверке ядра и помогает избежать ситуации, когда одна и та же нерелевантная группа снова попадает в работу через другую выгрузку.
Проверьте интент
Поисковый интент показывает, какой результат пользователь ожидает получить после ввода запроса. Для базовой классификации достаточно разделять информационные, коммерческие, транзакционные и навигационные группы.
Лучший источник проверки – реальная поисковая выдача. Если Google показывает статьи, не стоит автоматически отправлять запрос на страницу услуги только из-за присутствия коммерческого слова.
Интент пользователя также помогает разделять близкие формулировки. Два запроса могут содержать одинаковый товар, но один вести на категорию, а другой – на инструкцию или сравнение.
Как кластеризовать семантику конкурентов?
После очистки остаётся набор запросов, который нужно распределить по будущим и существующим страницам. Кластеризация запросов снижает риск каннибализации и помогает понять, сколько URL действительно требуется для покрытия спроса.
Группы запросов формируют с учётом смысла, интента и состава выдачи. Частотность используется как дополнительная метрика, но она не определяет архитектуру сама по себе.
Группировка запросов по интенту
Сначала запросы разделяют по ожидаемому типу страницы. Фразы с явным намерением заказать услугу обычно направляют в коммерческий кластер, а вопросы и инструкции – в информационный.
Внутри каждого типа дополнительно проверяют смысловые различия. Например, запрос о цене услуги и запрос о технологии выполнения могут относиться к одной посадочной, если выдача показывает одни и те же страницы.
Если результаты заметно различаются, группы лучше развести. Такое решение снижает риск создавать перегруженную страницу, которая пытается одновременно отвечать на несколько независимых потребностей.
Группировка по пересечению поисковой выдачи
SERP-based clustering сравнивает URL, которые ранжируются по разным запросам. Чем больше совпадающих страниц встречается в TOP, тем выше вероятность общего интента.
Метод хорошо работает для спорных фраз, где смысловая близость не даёт однозначного ответа. Поисковая выдача показывает, как Google уже интерпретирует запросы и какие типы документов считает релевантными.
Автоматическую кластеризацию желательно проверять вручную на приоритетных группах. Алгоритм ускоряет работу, но коммерческая логика сайта, ассортимент и реальные услуги остаются отдельными ограничениями.
Как понять, что нужен отдельный URL?
Отдельную посадочную страницу стоит рассматривать, когда запросы имеют самостоятельный интент и поисковая выдача показывает другой набор документов. Дополнительным аргументом служат конкуренты, которые стабильно ранжируют отдельные URL по этой группе.
Новая страница также должна иметь реальный предмет. Если компания не предлагает отдельную услугу или товарную группу, создавать документ только ради ключа бессмысленно.
Когда интент совпадает, запросы лучше объединять на одном URL. Такой подход помогает концентрировать релевантность и внутренний вес вместо создания нескольких слабых страниц с почти одинаковым содержанием.
Как узнать ключевые слова конкурентов в Директе?
Запрос «как узнать ключевые слова конкурентов в директе» относится к анализу платной рекламы. Здесь изучают рекламные фразы, объявления, посадочные страницы и коммерческие формулировки, которые компании используют для привлечения платного трафика.
Данные PPC нельзя напрямую смешивать с органическими позициями. Рекламодатель способен покупать переходы по запросу, по которому его сайт почти не имеет SEO-видимости, поэтому такие фразы анализируют как отдельный источник.
Для проектов, ориентированных на Google, аналогичную задачу решают через Google Ads и сервисы конкурентной PPC-аналитики. Полезно смотреть повторяющиеся объявления, офферы, страницы входа и категории запросов, которые конкуренты используют регулярно.
Рекламная семантика может подсказать коммерческие формулировки с сильным спросом. После этого запрос проверяют в органической выдаче и решают, подходит ли он для SEO-страницы или остаётся только в контекстной рекламе.
Какие инструменты использовать для анализа семантики конкурентов?
Для анализа можно использовать несколько сервисов, потому что их базы, интерфейсы и расчётные метрики отличаются. Один инструмент удобнее для keyword gap, другой быстрее показывает страницы-лидеры, а третий полезен для проверки спроса и сезонности.
Нет необходимости собирать подписки на все платформы одновременно. Для большинства задач достаточно одного основного SEO-сервиса, Google Search Console для собственного сайта и дополнительного источника частотности или трендов.
| Инструмент | Анализ домена | Keyword Gap | Анализ URL | Частотность | PPC-данные | Экспорт |
|---|---|---|---|---|---|---|
| Serpstat | Да | Да | Да | Да | Да | Да |
| SE Ranking | Да | Да | Да | Да | Да | Да |
| Ahrefs | Да | Да | Да | Да | Частично | Да |
| Semrush | Да | Да | Да | Да | Да | Да |
| Google Keyword Planner | Нет | Нет | Ограниченно | Да | Да | Да |
| Google Search Console | Только свой сайт | Нет | Да | Собственные показы | Нет | Да |
| Google Trends | Нет | Нет | Нет | Относительный тренд | Нет | Ограниченно |
Функции и ограничения тарифов периодически меняются, поэтому перед запуском большого анализа стоит проверить актуальные возможности выбранного сервиса. Для SEO чаще всего нужны отчёты по органическим запросам, конкурентам, URL и пересечению доменов.
Google Keyword Planner полезен для дополнительной проверки спроса, а Google Trends помогает оценить сезонность. Search Console используется для собственного проекта и показывает реальные показы, клики и позиции по запросам, где сайт уже присутствует в Google.
Как использовать семантику конкурентов для SEO
После сбора и кластеризации начинается самая полезная часть работы – перевод таблицы в конкретные изменения сайта. Каждая группа должна получить понятный статус: существующая страница, доработка, новая посадочная, статья или отказ от использования.
Без такого этапа даже хорошая выгрузка остаётся набором данных. SEO-задача появляется только после привязки семантики к структуре, контенту и внутренним ссылкам.
Ведущий SEO-специалист — Геннадий
Я никогда не переношу семантику конкурента в своё ядро целиком. Большая выгрузка почти всегда содержит чужие бренды, нерелевантные направления, другой интент и запросы под страницы, которых у проекта вообще не должно быть. Сначала я сравниваю несколько конкурентов, нахожу пересечения и упущенные запросы, затем проверяю выдачу и только после этого кластеризую семантику. Ценность конкурентного анализа для меня определяется количеством полезных точек роста, которые удалось превратить в конкретные страницы и задачи.
Расширение структуры сайта
Новый кластер сначала сопоставляют с существующей архитектурой. Если подходящего URL нет и SERP подтверждает отдельный интент, запросы становятся основанием для создания посадочной страницы.
Для большого сайта удобно вести карту «кластер – URL – тип страницы – статус». Она помогает разработчику, SEO-специалисту и копирайтеру работать с одной структурой без дублирования задач.
После публикации новую страницу включают во внутреннюю перелинковку и sitemap. Также проверяют canonical, индексируемость, хлебные крошки и ссылки из родительского раздела.
Оптимизация существующих страниц
Если подходящий URL уже существует, сначала оценивают его текущую семантику через Google Search Console и сторонний сервис. Затем добавляют упущенные подтемы, корректируют структуру заголовков и проверяют мета-теги.
Не нужно механически вставлять каждую найденную фразу в текст. Страница должна раскрывать тему нормальным языком, а словоформы и связанные термины распределяются естественно.
Иногда проблема находится вне контента. Слабая внутренняя ссылка, глубокая вложенность или неправильный canonical могут ограничивать видимость даже у хорошо написанной страницы.
Создание контент-плана
Информационные запросы конкурентов удобно собирать отдельно от коммерческого ядра. После кластеризации они превращаются в темы статей, инструкций, сравнений и ответов на вопросы пользователей.
Контент-план лучше строить вокруг тематических групп, связанных с услугами или категориями сайта. Тогда публикации работают как часть общей структуры и поддерживают коммерческие посадочные внутренними ссылками.
Перед созданием материала стоит проверить топовые страницы конкурентов и SERP. Такая проверка показывает ожидаемый формат контента, глубину раскрытия темы и вопросы, которые пользователи уже видят в выдаче.
Внутренняя перелинковка
Новые страницы должны получать ссылки из тематически близких разделов. Анкор выбирают по смыслу предложения, без постоянного повторения одной точной ключевой фразы.
Информационный материал может ссылаться на услугу, категорию или связанный гайд. Коммерческая страница, в свою очередь, может вести на подробную инструкцию, если она помогает пользователю принять решение.
Хорошая внутренняя перелинковка сокращает глубину важных URL и помогает поисковому роботу быстрее находить новые документы. Одновременно пользователю проще переходить между связанными этапами выбора.
Какие запросы конкурентов не нужно добавлять в своё семантическое ядро?
Часть выгрузки следует удалить ещё до кластеризации. Объём таблицы не является показателем качества, поэтому несколько тысяч нерелевантных фраз только увеличивают время дальнейшей работы.
Сначала исключают запросы, которые не соответствуют реальному предложению сайта. Затем проверяют географию, язык и интент, чтобы ядро не включало страницы, которые бизнес не сможет нормально обслуживать.
Чаще всего удаляют:
- чужие бренды, если проект не создаёт страницы сравнений или официально не работает с этими марками;
- отсутствующие товары, процедуры и услуги, которые компания не планирует предлагать;
- запросы другого региона, если география бизнеса ограничена конкретным рынком;
- навигационные фразы, связанные с чужими компаниями и личными кабинетами;
- темы с другим поисковым интентом, которые невозможно логично закрыть существующим форматом сайта;
- слишком широкие информационные запросы без связи с продуктом или экспертностью компании.
После очистки ядро обычно заметно сокращается. Оставшиеся запросы легче кластеризовать, оценивать по потенциалу и связывать с конкретными страницами.
Основные ошибки при анализе семантики конкурентов
Самая частая ошибка начинается с выгрузки большого домена без ограничений. В таблицу попадают десятки тысяч запросов, после чего команда тратит время на данные, которые изначально не соответствуют проекту.
Вторая проблема связана с отсутствием проверки поисковой выдачи. Автоматические отчёты ускоряют работу, но окончательное решение по структуре лучше принимать после просмотра реальных результатов Google.
К типичным ошибкам относятся:
- Копирование всей семантики одного домена без проверки релевантности бизнесу.
- Анализ только одного конкурента и перенос его структуры на собственный сайт.
- Смешивание регионов и языков в одной выгрузке без отдельных фильтров.
- Игнорирование интента при распределении ключей между страницами.
- Объединение SEO-запросов и данных платной рекламы в один отчёт.
- Создание нескольких URL под почти одинаковый поисковый спрос.
- Оценка потенциала только по частотности без проверки SERP и конверсии.
- Отказ от анализа внутренних ссылок и текущей структуры собственного сайта.
После исправления этих ошибок таблица становится короче, но полезнее. В ней остаются запросы, которые можно привязать к конкретному URL и реальной SEO-задаче.
Чек-лист анализа ключевых слов конкурентов
Работу удобно вести по одной последовательности, особенно если анализ повторяется для разных разделов большого сайта. Такой чек-лист помогает не пропустить очистку, проверку интента и сопоставление запросов с существующими страницами.
Базовый порядок выглядит так:
- Определите основные маркерные запросы для нужного раздела и региона.
- Найдите реальных SEO-конкурентов через Google и специализированные сервисы.
- Выгрузите органические запросы нескольких релевантных доменов.
- Объедините базы и сохраните источник каждого ключевого слова.
- Сравните данные со своим сайтом и найдите keyword gap.
- Удалите дубли, чужие бренды, мусор и неподходящие регионы.
- Проверьте частотность запросов и их поисковый интент.
- Выполните очистку семантического ядра перед кластеризацией.
- Разделите запросы на кластеры по смыслу и пересечению SERP.
- Сопоставьте кластеры с существующими посадочными страницами.
- Сформируйте список новых URL и задач на доработку контента.
- Настройте внутренние ссылки между новыми и существующими материалами.
После завершения чек-листа желательно сохранить исходную выгрузку и рабочую версию отдельно. Это упрощает повторный анализ через несколько месяцев и помогает увидеть новые точки роста без полного пересбора проекта.
Анализ ключевых слов конкурентов помогает увидеть спрос, который собственное семантическое ядро могло пропустить. Рабочий процесс состоит из выбора реальных SEO-конкурентов, выгрузки запросов, поиска разрывов, очистки данных, проверки интента и последующей кластеризации.
Главный результат такой работы – конкретный список действий по сайту. Одни кластеры усиливают существующие страницы, другие становятся новыми посадочными или материалами блога, а нерелевантные запросы удаляются ещё до подготовки контента.
Если нужно найти упущенную семантику, пересобрать структуру раздела или понять, какие страницы конкурентов забирают поисковый спрос, Seo-Gen проводит конкурентный анализ и переводит данные в готовые SEO-задачи для сайта.


