Аналіз ключових слів та семантики конкурентів


Власне семантичне ядро рідко охоплює всі запити, за якими сайт може отримувати цільовий пошуковий трафік. Частина тем знаходиться через Keyword Planner, підказки Google та Search Console, але помітний пласт семантики можна виявити лише після вивчення сайтів, які вже займають позиції у потрібній ніші.
Аналіз ключових слів конкурентів показує, які запити наводять користувачів на інші сайти, які URL-адреси отримують органічну видимість і які теми відсутні у вашій структурі. Після очищення та кластеризації цих даних можна знайти нові посадкові сторінки, розширити існуючий контент та точніше розставити пріоритети у SEO.
Що таке аналіз ключових слів конкурентів?
Аналіз ключових слів сайту конкурента починається зі збору запитів, за якими його домен або окремі сторінки з'являються в органічній видачі. SEO-сервіси пов'язують пошукові запити з URL, позиціями, частотністю, приблизним трафіком та іншими метриками, після чого дані можна порівняти зі своїм сайтом.
Усередині SEO-команд таку роботу іноді називають «аналіз ключовиків конкурентів», хоча завдання значно ширше за просте вивантаження списку фраз. Потрібно зрозуміти, чому конкретна сторінка отримує видимість, до якого інтенту належить запит, які теми об'єднані на одній URL і які елементи структури допомагають сайту охоплювати семантику.
Які дані можна отримати із семантики конкурентів?
Семантика конкурентів показує набагато більше, ніж перелік фраз із пошукової бази. При аналізі домену можна побачити зв'язок між запитами, сторінками та видимістю, а потім визначити напрямки, які мають сенс перевіряти для власного проєкту.
Зазвичай у робоче вивантаження включають такі дані:
- пошуковий запит, URL та поточну позицію сторінки у вибраному регіоні;
- частотність запитів, динаміку попиту та можливу сезонність теми;
- розрахунковий пошуковий трафік та загальну видимість сайту за групою фраз;
- сторінки конкурентів, які збирають велику кількість пов'язаних запитів;
- комерційні запити, інформаційні запити та змішані групи інтентів;
- перетин семантики між кількома доменами та втрачені запити власного сайту.
Після вивантаження дані все одно вимагають ручної перевірки. Метрики сторонніх сервісів розраховуються власними базами, тому точні показники трафіку чужого домену відомі лише його власнику.
Чим аналіз семантики відрізняється від копіювання чужих ключів?
Ключові слова сайту конкурента не можна автоматично переносити у власне семантичне ядро. Один домен може продавати більше товарів, працювати в інших містах, просувати додаткові послуги або мати великий блог, який вашому проєкту не потрібний.
Кожну групу запитів перевіряють по бізнесу, регіону, мові та пошуковому інтенту. Якщо конкурент отримує трафік товару, якого у вас немає, така фраза залишається аналітичним сигналом і не перетворюється на завдання для контенту.
Окремо оцінюють брендові запити. Чужі назви компаній часто займають помітну частку вивантаження та спотворюють картину, тому їх зазвичай виділяють в окремий сегмент або видаляють перед кластеризацією.
Відповіді на ваші запитання
Як дізнатися ключові слова конкурентів?
Найшвидший спосіб – ввести домен конкурента у SEO-сервіс та відкрити звіт за органічними запитами. У ньому зазвичай доступні запит, позиція, частотність, URL та розрахункова видимість.
Для більш точного результату потрібно вибрати потрібний регіон та мову, а потім видалити брендові та нерелевантні фрази. Отримане вивантаження краще порівнювати ще з кількома прямими конкурентами.
Як визначити ключові слова сайту конкурента?
Можна аналізувати весь домен або конкретну URL-адресу. Доменний звіт підходить для пошуку великих тематичних кластерів, а аналіз окремої сторінки зручний при порівнянні конкретної послуги, категорії чи статті.
Після отримання даних запити сортують за позиціями, частотністю та сторінками. Потім перевіряють їхній інтент і залишають лише ті групи, які відповідають вашому бізнесу.
Як знайти конкурентів за ключовими словами?
Введіть кілька основних запитів у Google та зафіксуйте домени, які регулярно повторюються у видачі. Перевіряти потрібно однаковий регіон, мову та тип пристрою, якщо він має значення для проєкту.
Додатково можна використовувати SEO-сервіс, який знайде сайти за перетином органічної семантики. Підсумковий список все одно варто перевірити вручну, щоб видалити агрегатори та ресурси іншого типу.
Як зібрати семантику конкурентів?
Спочатку вибирають кілька релевантних доменів, потім вивантажують пошукові запити і об'єднують дані в одній таблиці. Після цього видаляють дублі, бренди, невідповідні регіони та запити іншого інтенту.
Очищену базу кластеризують та зіставляють із існуючими URL-адресами. Нові групи стають кандидатами на окремі сторінки або матеріали блогу.
Що таке парсинг ключових слів конкурентів?
Парсинг означає автоматизований збір запитів, за якими конкурентні домени чи сторінки є у пошукових базах. Разом із фразами зазвичай отримують позиції, URL, частотність та інші доступні метрики.
Такий спосіб зручний при роботі з тисячами запитів. Після автоматичного збору все одно потрібна ручна фільтрація, тому що база містить нерелевантні та неоднозначні фрази.
Як дізнатися ключові слова конкурентів у Директі?
Для цього використовують сервіси аналізу платної реклами, які зберігають оголошення, посадкові сторінки та рекламні запити. Такі дані допомагають зрозуміти, які комерційні теми конкуренти підтримують рекламним бюджетом.
Для проєктів, що працюють з Google, аналогічні дані вивчають у Google Ads та PPC-сервісах. Рекламну семантику краще зберігати окремо від органічного SEO-ядра.
Чи потрібно додавати всі ключові слова конкурентів у своє ядро?
Ні, значна частина вивантаження може не відповідати вашому сайту. Чужі бренди, відсутні товари, інший регіон та невідповідний інтент зазвичай виключають до кластеризації.
Кожен спірний кластер краще перевірити у пошуковій видачі. Якщо запит неможливо пов'язати з корисною сторінкою та реальною пропозицією бізнесу, додавати його до ядра немає сенсу.
Як знайти ключові слова, за якими конкуренти ранжуються, а мій сайт — ні?
Використовуйте звіт Keyword Gap або Content Gap та порівняйте свій домен із кількома конкурентами. Сервіс покаже запити, де інші сайти займають позиції, а ваш домен відсутній або знаходиться значно нижче.
Після вивантаження перевірте пріоритетні групи вручну. Спочатку оцінюють комерційну цінність та інтент, потім вирішують доопрацьовувати існуючу URL або створювати нову сторінку.
Навіщо аналізувати ключові слова конкурентів?
Аналіз ключових запитів конкурентів допомагає побачити попит із погляду вже існуючої пошукової видачі. Якщо кілька сильних сайтів створюють окремі сторінки під одну тему і отримують видимість, цей патерн варто перевірити для власного проєкту.
Основна користь виникає після зіставлення чужої семантики зі своєю структурою. В результаті стають видні запити без відповідних сторінок, слабкі URL-адреси, недостатньо розкриті теми і кластери, які раніше не потрапляли в семантичне ядро.
Знайти втрачені пошукові запити
Keyword gap показує фрази, за якими один або кілька конкурентів присутні в пошуку, а ваш домен не отримує помітної видимості. Такий звіт добре працює як перший фільтр перед детальним аналізом нових напрямків.
Втрачений запит ще не означає, що під нього потрібно створювати окрему URL-адресу. Спочатку перевіряють пошукову видачу, тип сторінок, що ранжуються, і пошуковий інтент, після чого запит додають до існуючого кластера або виділяють в нову групу.
Особливо корисні фрази, які зустрічаються одразу у кількох прямих SEO-конкурентів. Повторюваність знижує можливість того, що перед вами випадкова тема, характерна тільки для одного сайту.
Розширити семантичне ядро
Збір семантики конкурентів добре доповнює класичну роботу з маркерними запитами та пошуковими підказками. Через чужі домени часто знаходяться розмовні формулювання, вузькі товарні ознаки, регіональні варіанти та довгі запити, які складно вигадати вручну.
Після об'єднання кількох вивантажень видаляють дублі, нерелевантні фрази та запити з невідповідним інтентом. Семантику, що залишилася, пов'язують з існуючими URL або відправляють на кластеризацію для пошуку нових посадкових сторінок.
Такий підхід особливо корисний у великих нішах. Чим ширший асортимент чи перелік послуг, тим вища ймовірність пропустити окремі групи попиту під час збору семантики лише від вихідних маркерів.
Знайти ідеї для нових сторінок
У конкурентів можна побачити типи посадкових, які відсутні у вашій структурі. Це можуть бути категорії, підкатегорії, сторінки окремих послуг, географічні сторінки, фільтри, порівняння, інструкції чи статті під інформаційний попит.
Перед створенням URL перевіряють, чи існує окремий інтент у Google. Якщо по групі запитів видача стабільно показує самостійні сторінки конкурентів, з'являється підстава розглянути окрему посадкову на своєму сайті.
Для інтернет-магазину таким сигналом можуть бути підкатегорії за призначенням товару. Для послуг часто виявляються сторінки окремих процедур, завдань клієнта, міст чи типів робіт.
Зрозуміти структуру сайтів із TOP видачі
Аналіз конкурентів за ключовими словами допомагає відновити логіку структури, навіть якщо меню сайту показує її лише частково. Зв'язка «запит - URL - кластер» показує, які теми конкуренти об'єднують, а які розводять по окремих сторінках.
Корисно дивитися не лише на кількість URL. Потрібно порівнювати вкладеність, хлібні крихти, внутрішні посилання та елементи навігації, що повторюються, щоб зрозуміти роль кожної сторінки всередині розділу.
Така робота є особливо корисною перед розширенням каталогу або розділу послуг. Спершу з'являється карта попиту, потім структура сайту отримує сторінки під підтверджені пошукові інтенти.
Знайти теми для контенту
Інформаційні сторінки конкурентів показують питання, які користувачі ставлять перед покупкою або зверненням за послугою. Якщо такі матеріали стабільно отримують видимість, їх можна включити у власний контент-план після перевірки релевантності.
Варто оцінювати не лише назву статті. Потрібно подивитися, які H2 та H3 використовуються, які питання розкриваються у FAQ, які комерційні сторінки одержують внутрішні посилання з матеріалу.
Хороший контентний кластер допомагає закривати інформаційний попит та передавати внутрішню вагу сторінкам послуг. Для цього теми блогу пов'язують із комерційними URL-адресами логічними посиланнями, без штучного повторення анкорів.
Як визначити справжніх SEO-конкурентів?
Бізнес-конкуренти та SEO-конкуренти часто перетинаються лише частково. Компанія може працювати в тій же ніші, але майже не бути присутньою в органічній видачі, тоді як інформаційний портал або великий маркетплейс займатиме позиції за сотнями потрібних запитів.
Для аналізу семантики потрібні сайти, які регулярно зустрічаються в Google за цільовими кластерами. Їх склад може відрізнятись для комерційних, інформаційних та локальних запитів, тому один універсальний список конкурентів рідко підходить для всього проєкту.
Пошук конкурентів через Google
Почніть із кількох маркерних запитів, які точно описують основні товари, послуги чи інформаційні теми. Перевіряйте видачу в потрібному регіоні та мові, інакше список доменів буде викривленим.
Записуйте сайти, які повторюються в результатах на різні запити. Потім поділіть їх за типом: прямі компанії, маркетплейси, каталоги, інформаційні ресурси та сервіси.
Після первинного збору варто перевірити:
- скільки цільових запитів перетинається з кожним доменом;
- які типи сторінок найчастіше конкурують із вашими URL;
- наскільки збігаються товари, послуги, регіон та цільова аудиторія;
- чи є сайт у видачі стабільно за кількома зв'язаними кластерами.
Після такої перевірки залишається робоча група доменів для подальшого аналізу. Зазвичай кілька релевантних конкурентів дають кориснішу картину, ніж десятки випадкових сайтів з однієї видачі.
Пошук конкурентів за ключовими словами через SEO-сервіси
SEO-платформи можуть автоматично знаходити домени з великим перетином семантики. Для цього достатньо ввести свій сайт, окрему URL-адресу або маркерний запит і вибрати потрібну пошукову базу.
Пошук конкурентів за ключовими словами через сервіс зручний для великих проєктів, де ручна перевірка сотень запитів займає надто багато часу. Після автоматичного списку все одно потрібно видалити сайти іншого типу, агрегатори та ресурси з невідповідною комерційною пропозицією.
Аналіз конкурентів за ключовими словами стає точнішим, коли автоматичний звіт порівнюють із реальною SERP. База сервісу показує масштаб перетину, а Google допомагає перевірити фактичний інтент та тип сторінок.
Чому не можна аналізувати лише одного конкурента?
Один сайт може мати сильну структуру у комерційному розділі та слабкий блог, інший – добре збирати інформаційний трафік, але майже не розвивати категорії. Якщо взяти лише один домен, то його особливості легко прийняти за загальний стандарт ніші.
Порівняння декількох сайтів показує повторювані рішення. Коли три або чотири конкуренти використовують схожу структуру, створюють окремі сторінки під один кластер і отримують за ними позиції, такий патерн заслуговує на окрему перевірку.
Також кілька джерел зменшують залежність від випадкових запитів. Об'єднана вибірка краще показує теми, які регулярно зустрічаються в ніші та можуть приносити цільовий органічний трафік.
Як провести аналіз ключових слів сайту конкурента?
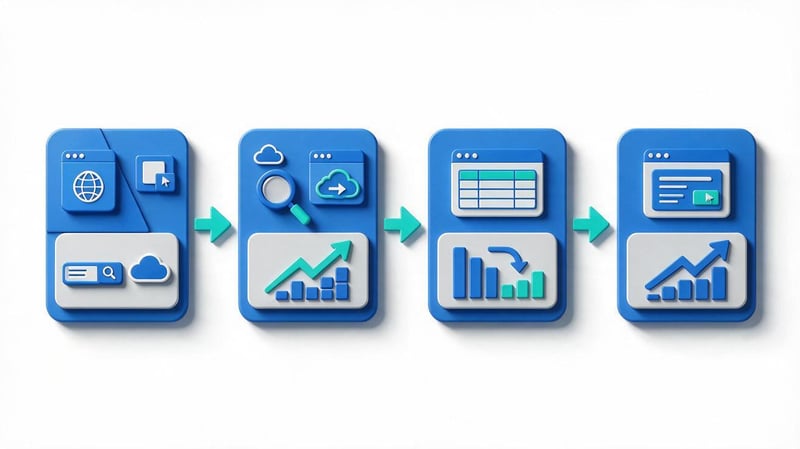
Аналіз ключових слів сайту конкурента зручніше виконувати за етапами, щоб не отримати величезну таблицю без зрозумілої мети. Спочатку вибирають об'єкт аналізу, потім вивантажують запити, шукають розрив із власним сайтом і лише після цього переходять до сторінок та структури.
Такий порядок заощаджує час на очищенні. Замість роботи з усією базою домену можна швидко визначити групи з реальним потенціалом та зосередитись на них.
Крок 1. Введіть домен або URL конкурента
Для загального аналізу використовують домен. Такий звіт показує семантику всього сайту та підходить для пошуку нових розділів, великих кластерів та сторінок-лідерів.
Окремий URL потрібний, коли порівнюються конкретні посадкові. Наприклад, власна сторінка послуги знаходиться на другій сторінці Google, а конкурент стабільно займає верхні позиції за тим же набором запитів.
Аналіз сайту конкурента на ключові слова краще починати з домену, а потім заглиблюватися у пріоритетні URL-адреси. Так помітна загальна структура попиту і одночасно зберігається можливість детально розібрати конкретні сторінки.
Крок 2. Вивантажте ключові слова сайту конкурента
До робочої таблиці варто включити запит, URL, позицію, частотність, регіон, пошукову систему та доступну оцінку трафіку. За наявності додаткових даних корисно зберегти CPC, динаміку позицій та елементи пошукової видачі.
Якщо завдання полягає в тому, щоб визначити ключові слова конкурентного сайту для одного розділу, заздалегідь фільтруйте URL. Такий підхід скорочує кількість сміття та полегшує подальшу кластеризацію.
Після експорту не поспішайте видаляти низькочастотні фрази. Вони часто уточнюють інтент, показують додаткові властивості продукту та допомагають зрозуміти, чому кілька схожих запитів ведуть на різні сторінки.
Крок 3. Знайдіть запити, яких немає на вашому сайті
Наступний етап – порівняння семантики двох чи кількох доменів. Keyword gap поділяє запити на загальні, втрачені та унікальні, після чого кожну групу можна аналізувати окремо.
Запит дізнатися ключові запити конкурентів зазвичай має на увазі саме таке завдання. Користувачеві потрібен список тем, де конкурент вже отримує видимість, а власний сайт поки що відсутній або займає слабкі позиції.
Працювати зі знайденими групами зручно за пріоритетом:
| Група запитів | Відносний пріоритет |
|---|---|
| Втрачені комерційні запити | 100% |
| Слабкі існуючі сторінки | 80% |
| Нові інформаційні кластери | 60% |
| Унікальні теми одного конкурента | 30% |
Відсотки показують відносний пріоритет груп під час первинної обробки, а не прогноз трафіку чи конверсії. Конкретний порядок залежить від цілей проєкту, стану поточних сторінок та комерційної цінності знайденої семантики.
Загальні запити
Загальні запити показують зони прямої конкуренції. Якщо обидва сайти ранжуються по одній групі, можна порівняти позиції, типи сторінок, повноту контенту, мета-теги та внутрішню перелінковку.
Особливу увагу варто приділити запитам, де ваш URL вже знаходиться поряд із першою сторінкою. Іноді зростання можна одержати через доопрацювання існуючого матеріалу без створення нового документа.
Такі групи також корисні для перевірки канібалізації. Якщо кілька власних сторінок конкурують між собою за однаковим інтентом, структуру та внутрішні сигнали варто переглянути.
Втрачені запити
Втрачені запити – найцікавіша частина конкурентного аналізу. Вони показують теми, де попит вже підтверджено видачею, але власний сайт поки що не має помітної сторінки чи видимості.
Спочатку перевіряють релевантність бізнесу, потім SERP і тільки після цього вирішують, чи потрібен новий URL або доопрацювання існуючого. Окрема сторінка виправдана, коли пошуковий інтент та склад результатів помітно відрізняються.
Висока частотність сама по собі не робить запит пріоритетним. Вузька комерційна фраза з меншим попитом іноді приносить більше користі, якщо точно відповідає послузі та знаходиться близько до покупки.
Унікальні запити одного конкурента
Унікальні запити можуть показувати цікаві напрямки, але потребують найобережнішої перевірки. Часто туди потрапляють брендові фрази, старі сторінки, нерелевантні товари чи теми великого блогу.
Спочатку визначте, чи пов'язаний запит із вашою пропозицією. Потім подивіться видачу та переконайтеся, що тип сторінки відповідає структурі проєкту.
Якщо тема зустрічається тільки в одного конкурента і не підтверджується іншими доменами, краще залишити в окремому списку для додаткового аналізу. Це знижує ризик створення сторінок під випадковий попит.
Крок 4. Проаналізуйте сторінки-лідери конкурента
Після роботи із запитами переходьте до URL, які отримують максимальну видимість за релевантними групами. Такі сторінки показують, які теми конкуренту вдалося об'єднати та які елементи контенту підтримують ранжування.
Для кожної сторінки варто перевірити Title, H1, структуру H2–H3, обсяг корисного матеріалу, таблиці, FAQ, внутрішні посилання та тип контенту. Окремо дивляться, які розділи посилаються на цю URL-адресу і куди вона передає внутрішню вагу.
Мета-теги самі по собі не пояснюють високі позиції. Їх потрібно аналізувати разом із інтентом, структурою сторінки, якістю розкриття теми та загальною архітектурою сайту.
Як зібрати семантику конкурентів?
Збір семантики конкурентів краще проводити з кількох релевантних доменів. Одне джерело показує лише частину попиту, а об'єднана база допомагає побачити повторювані кластери і порівняти різні підходи до структури.
Перед початком встановіть межі аналізу: регіон, мову, тип сторінок та потрібні розділи. Ці обмеження помітно скорочують обсяг наступного ручного очищення.
Об'єднайте семантику кількох сайтів
Вивантаження різних конкурентів зводять в одну таблицю і зберігають джерело кожного запиту. Потім однакові фрази об'єднують, а для кожного рядка рахують кількість доменів, де вона зустрічається.
Чим більше релевантних конкурентів ранжується на запит, тим корисніше перевірити його вручну. Повторюваність показує стійкий інтерес у ніші, хоча остаточне рішення однаково залежить від інтенту.
Зручно додати окремі стовпчики для власного URL, поточної позиції та статусу. Так таблиця відразу показує, де сторінка існує, де вимагає доопрацювання і де потрібно розглянути новий документ.
Проведіть парсинг ключових слів конкурентів
Парсинг ключових слів конкурентів потрібен при великому обсязі даних, коли ручний збір займає надто багато часу. Спеціалізовані сервіси отримують запити зі своїх баз і пов'язують їх із доменами, URL і позиціями.
Парсер ключових слів конкурентів особливо корисний для великих каталогів та широких тематик. Він допомагає зібрати тисячі фраз, але якість підсумкового ядра все одно залежить від фільтрації та перевірки людиною.
Добір ключових слів конкурентів варто проводити окремими групами. Комерційні сторінки, блог, категорії та географічні розділи краще аналізувати окремо, щоб запити різного інтенту не змішувалися в одному масиві.
Які дані вивантажувати?
Мінімальна таблиця повинна містити запит, частотність, позицію, URL, джерело та регіон. Для складних проєктів додають пошукову систему, дату перевірки, CPC та передбачуваний тип інтенту.
Корисно також зберегти ознаки SERP, якщо їх надає сервіс. Картки, зображення, відео, товарні блоки або розширені відповіді можуть впливати на очікуваний CTR та формат майбутньої сторінки.
Після вивантаження вихідні дані краще зберегти окремо. Робочу копію можна фільтрувати та змінювати без ризику втратити початкову інформацію, якщо пізніше знадобиться повторний аналіз.
Очистіть зібрані запити
Спочатку видаляють технічні дублі та наводять дані до єдиного формату. Потім фільтрують чужі бренди, невідповідні регіони, відсутні товари, нерелевантні послуги та очевидний інформаційний шум.
Фільтрування семантики потребує ручного перегляду неоднозначних фраз. Короткий запит може мати кілька значень, тому рішення щодо нього краще приймати після перегляду пошукової видачі.
Після очищення бажано залишити причину видалення в окремій колонці. Такий підхід корисний при повторній перевірці ядра і допомагає уникнути ситуації, коли одна й та сама нерелевантна група знову потрапляє в роботу через інше вивантаження.
Перевірте інтент
Пошуковий інтент показує, який результат користувач очікує отримати після введення запиту. Для базової класифікації достатньо поділяти інформаційні, комерційні, транзакційні та навігаційні групи.
Найкраще джерело перевірки – реальна пошукова видача. Якщо Google показує статті, не варто автоматично надсилати запит на сторінку послуги лише через наявність комерційного слова.
Інтент користувача також допомагає розділяти близькі формулювання. Два запити можуть містити однаковий товар, але один вести на категорію, а інший на інструкцію або порівняння.
Як кластеризувати семантику конкурентів?
Після очищення залишається набір запитів, який потрібно розподілити на майбутні та існуючі сторінки. Кластеризація запитів знижує ризик канібалізації і допомагає зрозуміти, скільки URL дійсно потрібно для покриття попиту.
Групи запитів формують з урахуванням змісту, інтенту та складу видачі. Частотність використовується як додаткова метрика, але вона сама по собі не визначає архітектуру.
Групування запитів за інтентом
Спочатку запити поділяють за очікуваним типом сторінки. Фрази з явним наміром замовити послугу зазвичай направляють до комерційного кластера, а запитання та інструкції – до інформаційного.
Усередині кожного типу додатково перевіряють смислові відмінності. Наприклад, запит про ціну послуги та запит про технологію виконання можуть стосуватися однієї посадкової, якщо видача показує одні й ті самі сторінки.
Якщо результати помітно відрізняються, групи краще розділити. Таке рішення знижує ризик створення перевантаженої сторінки, яка намагається одночасно відповідати на кілька незалежних потреб.
Групування за перетином пошукової видачі
SERP-based clustering порівнює URL, які ранжуються на різні запити. Чим більше сторінок, що збігаються, зустрічається в TOP, тим вище ймовірність загального інтенту.
Метод добре працює для спірних фраз, де смислова близькість не дає однозначної відповіді. Пошукова видача показує, як Google вже інтерпретує запити та які типи документів вважає релевантними.
Автоматичну кластеризацію бажано перевіряти вручну на пріоритетних групах. Алгоритм прискорює роботу, але комерційна логіка сайту, асортимент та реальні послуги залишаються окремими обмеженнями.
Як зрозуміти, що потрібна окрема URL-адреса?
Окрему посадкову сторінку слід розглядати, коли запити мають самостійний інтент та пошукова видача показує інший набір документів. Додатковим аргументом є конкуренти, які стабільно ранжують окремі URL по цій групі.
Нова сторінка також має мати реальний предмет. Якщо компанія не пропонує окрему послугу або товарну групу, створювати документ лише задля ключа безглуздо.
Коли інтент збігається, запити краще об'єднувати на одній URL. Такий підхід допомагає концентрувати релевантність та внутрішню вагу замість створення кількох слабких сторінок з майже однаковим змістом.
Як дізнатися ключові слова конкурентів у Директі?
Запит «як дізнатися ключові слова конкурентів у директі» відноситься до аналізу платної реклами. Тут вивчають рекламні фрази, оголошення, посадкові сторінки та комерційні формулювання, які компанії використовують для залучення платного трафіку.
Дані PPC не можна безпосередньо змішувати з органічними позиціями. Рекламодавець здатний купувати переходи на запит, за яким його сайт майже не має SEO-видимості, тому такі фрази аналізують як окреме джерело.
Для проєктів, орієнтованих на Google, аналогічне завдання вирішують через Google Ads та сервіси конкурентної PPC-аналітики. Корисно дивитися повторювані оголошення, оффери, сторінки входу та категорії запитів, які конкуренти використовують регулярно.
Рекламна семантика може підказати комерційні формулювання із сильним попитом. Після цього запит перевіряють в органічній видачі та вирішують, підходить він для SEO-сторінки або залишається тільки в контекстній рекламі.
Які інструменти використовувати для аналізу семантики конкурентів?
Для аналізу можна використовувати кілька сервісів, тому що їх бази, інтерфейси та розрахункові метрики відрізняються. Один інструмент зручніший для keyword gap, інший швидше показує сторінки-лідери, а третій корисний для перевірки попиту та сезонності.
Немає необхідності оформлювати передплати на всі платформи одночасно. Для більшості завдань достатньо одного основного SEO-сервісу, Google Search Console для власного сайту та додаткового джерела частотності чи трендів.
| Інструмент | Аналіз домену | Keyword Gap | Аналіз URL | Частотність | PPC-дані | Експорт |
|---|---|---|---|---|---|---|
| Serpstat | Так | Так | Так | Так | Так | Так |
| SE Ranking | Так | Так | Так | Так | Так | Так |
| Ahrefs | Так | Так | Так | Так | Частково | Так |
| Semrush | Так | Так | Так | Так | Так | Так |
| Google Keyword Planner | Ні | Ні | Обмежено | Так | Так | Так |
| Google Search Console | Лише свій сайт | Ні | Так | Власні покази | Ні | Так |
| Google Trends | Ні | Ні | Ні | Відносний тренд | Ні | Обмежено |
Функції та обмеження тарифів періодично змінюються, тому перед запуском великого аналізу варто перевірити актуальні можливості вибраного сервісу. Для SEO найчастіше потрібні звіти щодо органічних запитів, конкурентів, URL та перетину доменів.
Google Keyword Planner є корисним для додаткової перевірки попиту, а Google Trends допомагає оцінити сезонність. Search Console використовується для власного проєкту і показує реальні покази, кліки та позиції за запитами, де сайт вже є у Google.
Як використовувати семантику конкурентів для SEO
Після збору та кластеризації починається найкорисніша частина роботи – переведення таблиці в конкретні зміни сайту. Кожна група має отримати зрозумілий статус: існуюча сторінка, доопрацювання, нова посадкова, стаття або відмова від використання.
Без такого етапу навіть гарне вивантаження залишається набором даних. SEO-завдання з'являється тільки після прив'язки семантики до структури, контенту та внутрішніх посилань.
Провідний SEO-спеціаліст — Геннадій
Я ніколи не переношу семантику конкурента у своє ядро цілком. Велике вивантаження майже завжди містить чужі бренди, нерелевантні напрямки, інший інтент та запити під сторінки, яких у проєкту взагалі не повинно бути. Спочатку я порівнюю кілька конкурентів, знаходжу перетини та втрачені запити, потім перевіряю видачу і тільки після цього кластеризую семантику. Цінність конкурентного аналізу для мене визначається кількістю корисних точок зростання, які вдалося перетворити на конкретні сторінки та завдання.
Розширення структури сайту
Новий кластер спочатку порівнюють із існуючою архітектурою. Якщо відповідного URL немає і SERP підтверджує окремий інтент, запити стають основою для створення посадкової сторінки.
Для великого сайту зручно вести карту «кластер - URL - тип сторінки - статус». Вона допомагає розробнику, SEO-фахівцеві та копірайтеру працювати з однією структурою без дублювання завдань.
Після публікації нову сторінку включають у внутрішню перелінковку та sitemap. Також перевіряють canonical, індексованість, хлібні крихти та посилання з батьківського розділу.
Оптимізація існуючих сторінок
Якщо відповідний URL вже існує, спочатку оцінюють його поточну семантику через Google Search Console та сторонній сервіс. Потім додають втрачені підтеми, коригують структуру заголовків та перевіряють мета-теги.
Не потрібно механічно вставляти кожну знайдену фразу у текст. Сторінка має розкривати тему нормальною мовою, а словоформи та пов'язані терміни розподіляються природно.
Іноді проблема знаходиться поза контентом. Слабке внутрішнє посилання, глибока вкладеність або неправильний canonical можуть обмежувати видимість навіть у добре написаної сторінки.
Створення контент-плану
Інформаційні запити конкурентів зручно збирати окремо від комерційного ядра. Після кластеризації вони перетворюються на теми статей, інструкцій, порівнянь та відповідей на запитання користувачів.
Контент-план краще будувати навколо тематичних груп, пов'язаних із послугами чи категоріями сайту. Тоді публікації працюють як частина загальної структури та підтримують комерційні посадкові внутрішніми посиланнями.
Перед створенням матеріалу варто перевірити топові сторінки конкурентів та SERP. Така перевірка показує очікуваний формат контенту, глибину розкриття теми та питання, які користувачі вже бачать у видачі.
Внутрішня перелінковка
Нові сторінки мають отримувати посилання із тематично близьких розділів. Анкор вибирають за змістом речення, без постійного повторення однієї точної ключової фрази.
Інформаційний матеріал може посилатися на послугу, категорію чи пов'язаний гайд. Комерційна сторінка, у свою чергу, може вести на докладну інструкцію, якщо вона допомагає користувачеві прийняти рішення.
Хороша внутрішня перелінковка скорочує глибину важливих URL-адрес і допомагає пошуковому роботу швидше знаходити нові документи. Одночасно користувачеві простіше переходити між пов'язаними етапами вибору.
Які запити конкурентів не потрібно додавати до свого семантичного ядра?
Частину вивантаження слід видалити ще до кластеризації. Обсяг таблиці не є показником якості, тому кілька тисяч нерелевантних фраз лише збільшують час подальшої роботи.
Спочатку виключають запити, які не відповідають реальній пропозиції сайту. Потім перевіряють географію, мову та інтент, щоб ядро не включало сторінки, які бізнес не зможе нормально обслуговувати.
Найчастіше видаляють:
- чужі бренди, якщо проєкт не створює сторінок порівнянь або офіційно не працює з цими марками;
- відсутні товари, процедури та послуги, які компанія не планує пропонувати;
- запити іншого регіону, якщо географія бізнесу обмежена конкретним ринком;
- навігаційні фрази, пов'язані з чужими компаніями та особистими кабінетами;
- теми з іншим пошуковим інтентом, які неможливо логічно закрити існуючим форматом сайту;
- надто широкі інформаційні запити без зв'язку з продуктом чи експертністю компанії.
Після очищення ядро зазвичай помітно скорочується. Запити, що залишилися, легше кластеризувати, оцінювати за потенціалом і пов'язувати з конкретними сторінками.
Основні помилки під час аналізу семантики конкурентів
Найчастіша помилка починається з вивантаження великого домену без обмежень. У таблицю потрапляють десятки тисяч запитів, після чого команда витрачає час на дані, які від початку не відповідають проєкту.
Друга проблема пов'язана із відсутністю перевірки пошукової видачі. Автоматичні звіти прискорюють роботу, але остаточне рішення щодо структури краще приймати після перегляду реальних результатів Google.
До типових помилок належать:
- Копіювання всієї семантики одного домену без перевірки релевантності бізнесу.
- Аналіз лише одного конкурента та перенесення його структури на власний сайт.
- Змішування регіонів та мов в одному вивантаженні без окремих фільтрів.
- Ігнорування інтенту під час розподілу ключів між сторінками.
- Об'єднання SEO-запитів та даних платної реклами в один звіт.
- Створення декількох URL-адрес під майже однаковий пошуковий попит.
- Оцінка потенціалу лише за частотністю без перевірки SERP та конверсії.
- Відмова від аналізу внутрішніх посилань та поточної структури власного сайту.
Після виправлення цих помилок таблиця стає коротшою, але кориснішою. В ній залишаються запити, які можна прив'язати до конкретної URL-адреси та реальної SEO-задачі.
Чек-лист аналізу ключових слів конкурентів
Роботу зручно вести за однією послідовністю, особливо якщо аналіз повторюється для різних розділів великого сайту. Такий чек-лист допомагає не пропустити очищення, перевірку інтенту та зіставлення запитів із існуючими сторінками.
Базовий порядок виглядає так:
- Визначте основні маркерні запити для потрібного розділу та регіону.
- Знайдіть реальних SEO-конкурентів через Google та спеціалізовані сервіси.
- Вивантажте органічні запити кількох релевантних доменів.
- Об'єднайте бази та збережіть джерело кожного ключового слова.
- Порівняйте дані зі своїм сайтом та знайдіть keyword gap.
- Видаліть дублі, чужі бренди, сміття та невідповідні регіони.
- Перевірте частотність запитів та їх пошуковий інтент.
- Виконайте очищення семантичного ядра перед кластеризацією.
- Розділіть запити на кластери за змістом та перетином SERP.
- Зіставте кластери з існуючими посадковими сторінками.
- Сформуйте список нових URL та завдань на доробку контенту.
- Налаштуйте внутрішні посилання між новими та наявними матеріалами.
Після завершення чек-листа бажано зберегти вихідне вивантаження та робочу версію окремо. Це спрощує повторний аналіз через кілька місяців та допомагає побачити нові точки зростання без повного перезбору проєкту.
Аналіз ключових слів конкурентів допомагає побачити попит, який власне семантичне ядро могло пропустити. Робочий процес складається з вибору реальних SEO-конкурентів, вивантаження запитів, пошуку розривів, очищення даних, перевірки інтенту та подальшої кластеризації.
Головний результат такої роботи – конкретний список дій на сайті. Одні кластери посилюють існуючі сторінки, інші стають новими посадковими або матеріалами блогу, а нерелевантні запити видаляються ще до підготовки контенту.
Якщо потрібно знайти втрачену семантику, перезбирати структуру розділу або зрозуміти, які сторінки конкурентів забирають пошуковий попит, Seo-Gen проводить конкурентний аналіз та переводить дані у готові SEO-завдання для сайту.


