Найкращі сервіси для збирання семантичного ядра


Для збирання семантичного ядра вже необов'язково вручну перебирати сотні пошукових запитів. Спеціальні сервіси знаходять пов'язані ключові слова, аналізують конкурентів, допомагають перевірити частотність та підготувати список запитів для просування сайту. При цьому можливості інструментів помітно різняться, тому вибір підходящої програми залежить від конкретного завдання.
Одні сервіси працюють із пошуковими підказками Google, інші використовують власні бази ключових слів чи дані рекламних платформ. Окремі рішення призначені для масового парсингу, очищення семантики та кластеризації. Розберемо безкоштовні та платні інструменти, порівняємо їхні можливості та покажемо, як організувати автоматичний збір семантичного ядра без зайвої ручної роботи.
Навіщо потрібні сервіси для збору семантичного ядра?
Семантичне ядро є структурованим набором пошукових запитів, за якими користувачі можуть знаходити сторінки сайту. Його використовують при проєктуванні категорій, створенні посадкових сторінок, підготовці контенту та внутрішній перелінковці. Якісне ядро враховує реальні потреби аудиторії та особливості пошукової видачі.
Сервіси для збору семантичного ядра скорочують час отримання вихідних даних і допомагають виявити запити, які важко знайти вручну. При цьому програма для аналізу пошукових запитів може вирішувати одне або кілька завдань: пошук нових фраз, перевірку попиту, аналіз конкурентів, очищення списків та групування семантики.
Пошук та автоматичний підбір ключових слів
Автоматичний підбір ключових слів зазвичай починається з декількох маркерних запитів, які описують товари, послуги або основну тематику сайту. Наприклад, для інтернет-магазину меблів маркерами можуть стати «диван», «кутовий диван», «ліжко» та «обідній стіл». На їх основі програма знаходить додаткові формулювання, характеристики товарів та уточнення.
Автоматичний підбір ключових слів для сайту особливо корисний при роботі з великими каталогами. Вручну складно передбачити всі поєднання назви товару з матеріалом, розміром, кольором чи призначенням. Сервіс підбору ключових слів для сайту допомагає знайти такі комбінації та підготувати вихідний список для подальшого аналізу.
Окрему увагу приділяють long-tail запитам – довгим пошуковим фразам із конкретними уточненнями. Наприклад, «кутовий диван з ящиком для білизни» набагато точніше описує потребу покупця, ніж загальний запит «диван». Такі формулювання допомагають знаходити теми для товарних категорій, фільтрів та інформаційних матеріалів.
Аналіз частотності та пошукового попиту
Частотність показує, як часто користувачі шукають певну фразу у вибраній пошуковій системі. При аналізі слід враховувати країну, регіон, період та особливості джерела даних. Один сервіс може показувати оцінку середньомісячного попиту, інший – статистику показів реклами чи власну розрахункову метрику.
Сервіси для аналізу ключових слів допомагають порівнювати пошукові фрази за популярністю та вибирати пріоритетні напрямки. При цьому частотність не можна розглядати окремо від пошукового інтенту, конкурентності та цінності запиту для бізнесу. Популярна фраза не завжди приносить більше цільових відвідувачів, ніж кілька вузьких комерційних запитів.
Додатково перевіряють сезонність попиту та зміни інтересу користувачів. Наприклад, кількість запитів на кондиціонери зазвичай залежить від пори року, а попит на окремі моделі техніки може змінюватись після появи нових товарів. Для таких завдань використовують історичні дані, Google Trends та інші аналітичні джерела.
Аналіз ключових слів конкурентів
Аналіз конкурентів допомагає дізнатися, які запити вже приводять користувачів на сайти компаній із тієї ж ніші. Деякі SEO-платформи показують передбачувані ключові слова домену, позиції окремих URL-адрес і сторінки з найбільш помітною органічною видимістю. Ці відомості використовують під час розширення власного семантичного ядра.
Корисно порівнювати кілька конкурентів одночасно і виділяти тематичні групи, що перетинаються. Якщо певну категорію запитів використовують різні сайти, варто перевірити її попит та відповідність власним послугам. Також можна шукати теми, які конкуренти розкрили окремими сторінками.
При цьому сервіс підбору ключових слів із сайту конкурента не гарантує повного переліку його пошукового трафіку. Зовнішні платформи спираються на власні бази та розрахункові показники. Отримані запити необхідно додатково перевіряти, оскільки частина з них може стосуватися чужого асортименту, інших регіонів чи інформаційних тем.
Очищення та групування семантики
Після масового збору семантики у таблиці зазвичай з'являються дублікати, нерелевантні фрази та запити з різними пошуковими намірами. Перед створенням структури сайту список очищають, перевіряють показники та поділяють за тематичними напрямками. Для автоматичної обробки використовують фільтри, стоп-слова та інструменти кластеризації.
Групування ключових слів допомагає визначити, які запити можна просувати на одній сторінці, а для яких потрібні окремі URL-адреси. Наприклад, запити про вартість послуги логічно зіставляти з комерційною сторінкою, а питання самостійного виконання роботи часто вимагають інформаційного матеріалу.
Автоматична кластеризація прискорює первинне розподілення запитів, але результати необхідно перевірити вручну. Особливо уважно аналізують групи з різними інтентами, геозалежні запити і близькі формулювання, для яких Google показує суттєво різні результати пошуку.
Відповіді на ваші запитання
Які сервіси краще використовувати для збору семантичного ядра?
Вибір залежить від завдань проєкту та необхідного обсягу даних. Для пошуку нових ключових слів можна використовувати Google Keyword Planner, для аналізу власного пошукового трафіку – Google Search Console, а для дослідження конкурентів – Serpstat, Ahrefs або Semrush. Для масової обробки підходять спеціалізовані програми та парсери.
Якщо потрібно згрупувати вже зібрані запити, слід обрати окремий сервіс кластеризації. Наприклад, Seo-Gen допомагає виконати первинне групування за спільними словами та перевірити смислові відповідності. При виборі будь-якого інструменту потрібно враховувати регіон, мову, доступні функції та обмеження використання.
Чи можна автоматично зібрати семантичне ядро безкоштовно?
Так, окремі етапи збору семантики можна виконати за допомогою безкоштовних інструментів. Google Keyword Planner допомагає знаходити пошукові ідеї, Search Console показує запити чинного сайту, а Google Trends підходить для дослідження сезонності. Пошукові підказки можна також використовувати як джерело додаткових формулювань.
Обмеження з'являються при масовій обробці, отриманні окремих SEO-показників та роботі з великими списками. Крім того, автоматичний збір вимагає подальшого очищення та перевірки. Тому для невеликого проєкту безкоштовного набору може бути достатньо, а для великого сайту зручніше використовувати додаткові платні рішення.
Який сервіс є аналогом Яндекс Wordstat для Google?
Для пошуку ключових слів та оцінки попиту в Google найчастіше використовують Google Keyword Planner. Він надає пошукові ідеї та орієнтовні показники середньомісячного попиту. Додатково можна підключити Google Trends для аналізу сезонності та Search Console з метою вивчення запитів власного сайту.
Повного функціонального аналога Wordstat з ідентичною методикою розрахунку немає. Сторонні платформи, включаючи Serpstat та Ahrefs, використовують власні бази та показники. Тому при переході на новий інструмент слід враховувати відмінності в джерелах даних та не порівнювати частотність різних систем безпосередньо.
Чим замінити Key Collector?
Якщо потрібно масове збирання пошукових запитів, можна розглянути Rush Analytics та інші спеціалізовані сервіси автоматизації. Для дослідження конкурентів та аналізу частотності підходять Serpstat, Ahrefs та окремі інструменти Topvisor. Конкретний вибір залежить від необхідного набору операцій.
Перед заміною Key Collector бажано визначити, які функції використовувалися у попередньому робочому процесі. Це може бути парсинг підказок, робота з частотністю, очищення дублів, фільтрація чи групування семантики. Після цього простіше вибрати відповідну програму та уникнути зайвих витрат на непотрібні модулі.
Чим парсер ключових слів відрізняється від сервісу кластеризації?
Парсер ключових слів збирає пошукові фрази з певного джерела, наприклад, пошукових підказок або доступної бази запитів. Його основне завдання – отримати список можливих формулювань з обраної тематики. Після збору дані зазвичай вимагають перевірки частотності та видалення нерелевантних фраз.
Сервіс кластеризації працює з підготовленим списком запитів та допомагає розподілити їх за групами. Для цього можуть використовуватись спільні слова, смислова близькість або перетин результатів пошуку. Зазвичай обидва типи інструментів застосовують послідовно: спочатку збирають семантику, потім групують для майбутніх сторінок.
Чи можна зібрати ключові слова із сайту конкурента?
Так, деякі SEO-платформи дозволяють отримати ймовірні пошукові запити, за якими конкурентний домен або окрема сторінка присутня в Google. Для цього використовують інструменти аналізу органічної видимості та бази ключових слів. Результати допомагають виявити додаткові комерційні напрямки та теми для контенту.
При цьому дані стороннього сервісу можуть бути неповними, особливо для невеликих сайтів та вузьких запитів. Також потрібно відрізняти аналіз органічної семантики від простого вилучення тексту з HTML-сторінки. Отримані ключові слова слід перевірити за регіоном, частотністю та відповідністю власній пропозиції.
Чи потрібна ручна перевірка після автоматичної кластеризації?
Так, результати автоматичного групування необхідно перевіряти перед створенням структури сайту. Алгоритм може поєднати фрази з різними пошуковими намірами або поділити близькі запити на кілька груп. Особливо часто такі ситуації виникають під час роботи з неоднозначними словами та широкими тематичними напрямами.
Під час перевірки фахівець оцінює пошуковий інтент, склад видачі та відповідність запитів майбутній посадковій сторінці. Окремо переглядають незгруповані фрази та спірні кластери. Така перевірка допомагає знизити ризик сторінок, що дублюються, і помилок при розподілі семантики.
Як часто потрібно оновлювати семантичне ядро?
Частота оновлення залежить від тематики сайту та змін пошукового попиту. Для інтернет-магазинів з асортиментом, що постійно змінюється, семантику зазвичай переглядають частіше, ніж для невеликих корпоративних сайтів зі стабільним переліком послуг. Додатковим приводом для оновлення стає поява нових напрямків бізнесу.
Корисно періодично аналізувати дані Search Console, зміни позицій та нові запити конкурентів. Якщо з'являються додаткові тематичні групи або помітно змінюється сезонний попит, ядро доповнюють та коригують карту сторінок. При цьому повне перескладання не завжди потрібне, оскільки часто достатньо оновити окремі розділи.
Порівняння кращих сервісів та інструментів для збору семантики
На ринку представлені десятки програм та онлайн-платформ для роботи з пошуковими запитами. Одні розраховані на фахівців, котрі регулярно обробляють великі масиви даних, інші підходять власникам невеликих сайтів. Тому порівнювати сервіси зручніше за завданнями, джерелами інформації та обмеженнями використання.
Інструменти для збору семантичного ядра також відрізняються за моделлю оплати. Безкоштовні рішення зазвичай мають обмеження щодо функціональності або обсягу доступних даних. Професійні платформи пропонують додаткові звіти, масову обробку та інтеграцію, але їх використання може вимагати підписки або оплати окремих операцій.
| Сервіс | Основне призначення | Безкоштовний доступ | Робота з Google | Кластеризація |
|---|---|---|---|---|
| Seo-Gen Keyword Clustering Tool | Групування готового списку запитів | Умови використання наведені в інструменті | Видача перевіряється окремо | Так, за спільними словами та підказками |
| Google Keyword Planner | Підбір запитів та оцінка попиту | Через Google Ads за виконання умов доступу | Так | Немає повноцінної SEO-кластеризації |
| Google Search Console | Аналіз запитів власного сайту | Так | Так | Ні |
| Google Trends | Динаміка інтересу та сезонність | Так | Так | Ні |
| Serpstat | Семантика, конкуренти, SEO-аналіз | Обмежений доступ залежить від умов сервісу | Так | Так |
| Ahrefs | Ключові слова, конкуренти, посилання | Основні функції платні | Так | Немає окремої універсальної заміни SERP-кластеризатору |
| Semrush | Пошук ключових слів та аналіз конкурентів | Обмежений доступ | Так | Групування та робота зі списками |
| Keyword Tool | Збір пошукових підказок | Частина функцій доступна безкоштовно | Так | Ні |
| Ubersuggest | Ключові слова та SEO-аналіз | Обмежений доступ | Так | Немає повноцінної SEO-кластеризації |
| Key Collector | Масовий збір та обробка запитів | Платна програма | Залежить від підключених джерел | Групування та обробка |
| Rush Analytics | Парсинг та обробка семантики | Умови залежать від тарифу | Так, для підтримуваних завдань | Так |
| Topvisor | Ключові слова, позиції та групування | Оплата залежить від операцій | Так | Так |
| Bukvarix | Пошук запитів у готовій базі | Є обмежені можливості доступу | Перевіряти покриття бази | Ні |
| Keys.so | Аналіз конкурентів та їх семантики | Основні функції платні | Перевіряти доступні бази та регіони | Допоміжне групування |
У таблиці наведено основні сценарії застосування. Точний набір функцій залежить від чинного тарифу, регіонального покриття та доступних джерел даних. Перед покупкою підписки бажано перевірити інструмент на невеликій вибірці реальних запитів свого проєкту.
Якщо потрібний сервіс зі збирання семантичного ядра з нуля, спочатку вибирають джерело пошукових фраз. Коли список вже зібраний, підключають інструменти очищення та кластеризації. Для невеликого сайту кілька окремих безкоштовних рішень іноді виявляються зручнішими за велику універсальну платформу.
Безкоштовні інструменти для підбору ключових слів
Безкоштовні інструменти підбору ключових слів підходять для первинного дослідження тематики, перевірки окремих запитів та роботи з невеликими сайтами. Вони допомагають скласти список маркерів, оцінити інтерес аудиторії та виявити додаткові пошукові формулювання. Однак можливості масового збору та вивантаження даних у таких рішень різняться.
Для Google найчастіше використовують Keyword Planner, Search Console, Trends та пошукові підказки. Ці джерела корисно поєднувати, оскільки кожне показує окрему частину картини. При роботі з конкурентами або новим сайтом, для якого ще немає статистики, можуть знадобитися додаткові SEO-платформи.
Google Keyword Planner
Google Keyword Planner – безкоштовний інструмент у складі Google Ads, призначений для дослідження ключових слів та планування рекламних кампаній. Він допомагає знаходити пов'язані пошукові запити, оцінювати середньомісячний попит та порівнювати варіанти формулювань. Для SEO ці дані використовують при складанні стартового ядра та виборі пріоритетних тем.
Щоб підібрати ключові слова, користувач вводить кілька маркерів або вказує URL-адресу сторінки, пов'язаної з потрібною тематикою. Після вибору країни та мови сервіс показує доступні пошукові ідеї. Результати можна фільтрувати за частотністю, змістом запитів та іншими показниками.
Для українських проєктів особливе значення мають регіональні налаштування та мова запитів. Якщо сайт просувається українською та російською мовами, семантику бажано збирати та перевіряти окремо. Це допомагає виявити відмінності у формулюваннях та уникнути механічного перекладу ключових фраз.
Переваги Google Keyword Planner
Головна перевага планувальника – отримання пошукових ідей безпосередньо в рекламній системі Google. При дослідженні доступні тематичні формулювання та орієнтовні показники попиту. Інструмент допомагає швидко перевірити, які варіанти назв товарів чи послуг люди використовують у пошуку.
Для початку роботи достатньо підготувати кілька маркерних запитів та вказати потрібний регіон. Наприклад, компанія з ремонту квартир може порівняти попит на різні види ремонту, назви робіт та комерційні уточнення. Отримані фрази потім розподіляють між сторінками послуг та інформаційними матеріалами.
Ще одна перевага – можливість використовувати URL-адресу як відправну точку для підбору пошукових ідей. Це корисно під час вивчення окремої категорії товарів чи послуги. Однак такий підбір не слід сприймати як точний список органічних запитів, за якими ранжується обрана сторінка.
Обмеження Google Keyword Planner
Google Keyword Planner орієнтований на рекламні завдання, тому його показники не можна безпосередньо вважати прогнозом органічного трафіку. Середньомісячний обсяг запитів може відображатись у вигляді діапазонів, а доступна деталізація залежить від умов рекламного облікового запису. Для використання основних функцій також може знадобитися завершене налаштування Google Ads.
Планувальник не замінює повноцінний аналіз пошукової видачі і не показує всі причини, через які сторінки займають певні позиції. Він також не виконує розподіл готових запитів між посадковими сторінками на основі їх пошукового інтенту.
Тому програму для підбору ключових слів для сайту краще використовувати разом із конкурентним аналізом та подальшою кластеризацією. Для складних ніш потрібно додатково вивчати сторінки з результатів пошуку, оцінювати комерційний потенціал запитів та враховувати особливості видачі.
Google Search Console
Google Search Console допомагає вивчати реальні пошукові запити, за якими сторінки власного сайту отримували покази та кліки у Google. У звіті про ефективність доступні показники кліків, показів, CTR та середньої позиції. Дані можна аналізувати за окремими URL, країнами, пристроями та періодами.
Інструмент особливо корисний при розширенні семантики чинного сайту. Наприклад, стаття може отримувати покази за запитами, які відсутні в її початковому SEO-ТЗ. Такі фрази підказують, які питання варто розкрити докладніше та які пов'язані теми можна додати до контент-плану.
Потрібно враховувати, що Search Console приховує частину рідкісних запитів і обмежує кількість рядків, що відображаються. Крім того, сервіс показує інформацію про власний ресурс, доступ до якого підтверджено. Для повноцінного аналізу чужих доменів потрібні інші інструменти.
Google Trends
Google Trends показує зміну інтересу користувачів до пошукових тем та запитів за вибраний період. Сервіс допомагає вивчати сезонність, порівнювати кілька формулювань та знаходити пов'язані теми. Для контентних проєктів ці дані є корисними при виборі часу публікації матеріалів та плануванні сезонних сторінок.
Наприклад, попит на зимові шини, кондиціонери чи туристичні напрямки помітно змінюється протягом року. Google Trends допомагає побачити періоди зростання інтересу та порівняти динаміку по регіонах. При цьому графік відбиває відносну популярність, нормалізовану за шкалою від 0 до 100.
Значення 100 на графіку не означає сто пошукових запитів. Воно означає максимальну відносну популярність усередині вибраних параметрів порівняння. Для оцінки абсолютного обсягу попиту слід використовувати додаткові джерела, у тому числі Keyword Planner.
Пошукові підказки Google
Пошукові підказки з'являються, коли користувач починає вводити запит у рядок Google. Вони відображають можливі продовження фрази та допомагають знаходити довгі пошукові формулювання. Для збору семантики зручно використовувати поєднання маркерних запитів із назвами товарів, характеристиками та запитальними словами.
Наприклад, вводячи «купити велосипед», можна дослідити варіанти з уточненнями за призначенням, розміром, віком чи конкретною моделлю. Такий підхід допомагає виявляти запити, які не завжди очевидні при початковому аналізі тематики. Особливо корисні підказки під час підготовки FAQ та інформаційних матеріалів.
Для масової обробки є окремі інструменти збору семантики, які автоматизують отримання підказок. Однак наявність фрази в автодоповненні не підтверджує конкретну частотність. Після отримання списку запити потрібно очистити та перевірити у відповідній базі пошукових даних.
Платні сервіси для збору та аналізу ключових слів
Платні сервіси зазвичай вибирають, коли потрібно регулярно обробляти великі списки запитів, досліджувати конкурентів і отримувати додаткові SEO-показники. Такі платформи надають власні бази пошукових фраз, інструменти фільтрації та звіти про домени. Деякі також підтримують автоматизоване групування та експорт результатів.
Перед покупкою підписки бажано перевірити доступність даних для потрібного регіону. Велика міжнародна база не гарантує однаково докладне покриття всіх країн та мов. Для проєктів в Україні це питання є особливо важливим при дослідженні локальних комерційних запитів.
Serpstat
Serpstat – SEO-платформа для дослідження ключових слів, аналізу конкурентів та роботи з пошуковою видимістю сайтів. Сервіс допомагає знаходити пов'язані запити, порівнювати домени та вивчати сторінки, за якими конкуренти присутні у пошуковій видачі. Для масової роботи доступні додаткові інструменти для обробки семантики.
При виборі запитів можна враховувати пошуковий попит, конкурентність та інші доступні показники. Отримані фрази фільтрують за тематикою, після чого формують окремі списки для різних розділів сайту. Це зручно для інтернет-магазинів, корпоративних ресурсів та проєктів з великою кількістю послуг.
На окрему увагу заслуговує Serpstat кластеризація. Платформа використовує перетин результатів пошукової видачі, що допомагає групувати запити з урахуванням того, які сторінки Google показує за різними формулюваннями. Такий підхід корисний при плануванні структури та розподілі семантики.
Збір ключових слів у Serpstat
Робота починається з маркерного запиту чи аналізу домену, після чого фахівець отримує доступні варіанти пошукових фраз. У звітах можна досліджувати пов'язані формулювання, показники попиту та конкурентні сторінки. Окремі запити додають до робочого списку для подальшої обробки.
Наприклад, при дослідженні ніші стоматологічних послуг фахівець може зібрати запити щодо лікування карієсу, професійної гігієни та імплантації. Потім отримані фрази поділяють за напрямами, регіонами та типами потреб користувача. Це допомагає заздалегідь визначити, які сторінки будуть потрібні на сайті.
База ключових слів Serpstat залежить від вибраної країни та пошукової системи. Тому перед масовим вивантаженням слід перевірити доступні регіони та повноту даних за вузькою тематикою. Для нових послуг із невеликим пошуковим попитом можуть знадобитися додаткові джерела семантики.
Кластеризація ключових слів у Serpstat
Кластеризація семантичного ядра в Serpstat будується на аналізі перетинів URL у результатах пошуку. Користувач завантажує підготовлений список запитів, вибирає пошукову систему, країну та додаткові параметри. Потім сервіс порівнює видачу та розподіляє фрази за кластерами.
У налаштуваннях передбачені різні рівні сили зв'язку та типи кластерів. Більш суворі параметри зазвичай призводять до формування невеликих груп із високим ступенем подібності. М'які налаштування можуть поєднувати більше запитів, але потребують уважної перевірки підсумкової структури.
Після обробки фахівець переглядає склад груп, несортовані фрази та показники зв'язку. За потреби запити переносять між кластерами, а результати експортують для подальшої роботи. Це особливо корисно під час підготовки великих SEO-структур, де важливо узгодити семантику з пошуковою видачею.
Ahrefs Keywords Explorer
Ahrefs Keywords Explorer призначений для дослідження пошукових запитів та оцінки можливостей органічного просування. Сервіс показує ключові ідеї, розрахункову частотність, показники складності та додаткові відомості про результати пошуку. Його використовують при аналізі нових ніш, пошуку контентних тем та конкурентному дослідженні.
За допомогою Ahrefs можна вивчати запити, за якими видно окремих конкурентів, та порівнювати сторінки з пошукової видачі. При виборі ключів корисно брати до уваги тип документів у результатах Google. Якщо видача складається з карток товарів, інформаційна стаття може виявитися невідповідним форматом.
Показники Keyword Difficulty та Search Volume розраховуються за методикою платформи. Вони допомагають порівнювати запити всередині одного джерела даних, але не дають гарантованого прогнозу позицій чи трафіку. Для остаточного рішення потрібно враховувати якість конкуруючих сторінок, посилальний профіль і наміри користувачів.
Semrush
Semrush пропонує інструменти дослідження ключових слів, конкурентів та пошукової видачі. Один із основних модулів – Keyword Magic Tool, який допомагає розширювати маркерні запити та знаходити тематично пов'язані фрази. Результати можна фільтрувати за різними показниками та зберігати для подальшої роботи.
Платформа підходить для аналізу великих тематичних напрямків та міжнародних проєктів. Наприклад, компанія з кількома мовними версіями сайту може досліджувати різні ринки окремо, порівняти популярність пошукових формулювань та визначити додаткові теми для контенту.
Функції роботи зі списками допомагають організувати зібрані запити, однак автоматичне групування необхідно відрізняти від повноцінної кластеризації за перетином пошукової видачі. Перед вибором тарифу потрібно перевірити, які звіти доступні для конкретної країни та скільки операцій передбачено підпискою.
Keyword Tool
Keyword Tool спеціалізується на отриманні пошукових підказок та розширенні стартових запитів. Сервіс підходить для пошуку довгих формулювань, питань користувачів та додаткових варіантів назв товарів. Окрім Google, платформа підтримує різні пошукові майданчики залежно від вибраного режиму.
Для роботи достатньо вказати вихідне слово, мову та регіон, що підтримується. Після обробки користувач одержує список пов'язаних підказок, який можна використовувати для розширення семантики. Це зручно під час підготовки інформаційних матеріалів та пошуку вузьких товарних запитів.
Безкоштовний режим може показувати ключові ідеї без повного набору додаткових метрик. Доступ до частотності, конкурентних показників та масової обробки залежить від умов платного тарифу. Тому перед використанням Keyword Tool як основного джерела даних варто перевірити доступні ліміти та можливості експорту.
Ubersuggest
Ubersuggest використовують для пошуку ключових слів, вивчення пов'язаних формулювань та попереднього аналізу конкурентів. Сервіс пропонує інструменти дослідження пошукового попиту та окремі показники складності просування. Для власника невеликого сайту такий набір може бути достатнім на першому етапі роботи із семантикою.
Користувач вводить маркерний запит або вивчає доступну інформацію про домен, після чого відбирає релевантні фрази. Знайдені варіанти можна використовувати для підготовки посадкових сторінок, публікацій блогу та розширення існуючих розділів. Для складних проєктів результати бажано порівнювати з іншими джерелами.
Безкоштовний доступ має обмеження, а набір платних можливостей може змінюватися. Перед оплатою слід перевірити кількість доступних запитів, регіональне покриття та способи вивантаження. Особливо важливо переконатися, що сервіс надає достатньо даних по країні, де просувається сайт.
Програми та парсери ключових слів
Програми для збору семантичного ядра відрізняються від звичайних онлайн-сервісів способом роботи та можливостями автоматизації. Деякі встановлюються на комп'ютер, використовують підключені джерела та дозволяють виконувати послідовні операції над великими списками. Інші працюють через браузер та обробляють запити на стороні сервісу.
Парсер ключових слів призначений для отримання пошукових фраз із певних джерел. Це можуть бути підказки, рекламні інструменти, доступні бази або сторінки сайтів. Можливості конкретного парсера залежать від використовуваного джерела, обмежень доступу та налаштувань програми.
Key Collector
Key Collector – програма для збору ключових слів та обробки семантики, яка широко використовується у SEO-проєктах. Вона підтримує різні сценарії отримання пошукових фраз, роботу з показниками, фільтрацію та групування списків. Конкретні джерела та методи збору залежать від налаштувань та діючих інтеграцій.
Програма підходить фахівцям, яким необхідно регулярно опрацьовувати великі обсяги запитів. Наприклад, після масового збору можна виділити фрази з певними словами, видалити дублікати, застосувати мінус-слова та підготувати окремі групи для сторінок сайту.
Основна складність пов'язана з налаштуванням джерел, технічними обмеженнями та організацією робочого процесу. Частина сценаріїв історично орієнтована на сервіси Яндекса, тому для проєктів під Google слід заздалегідь перевірити сумісність потрібних джерел. Кей колектор аналог вибирають з урахуванням того, які операції потрібно зберегти.
Rush Analytics
Rush Analytics пропонує інструменти автоматизації окремих SEO-задач, включаючи збирання пошукових запитів та роботу з семантичним ядром. Сервіс орієнтований на масову обробку даних та підходить фахівцям, які регулярно досліджують великі тематичні напрямки. Доступні джерела та ліміти необхідно перевіряти за чинними умовами.
Один із сценаріїв використання – розширення вихідного списку запитів та подальша кластеризація. Після отримання семантики фахівець видаляє нерелевантні фрази, вибирає регіон та готує групи для майбутніх сторінок. Такий процес зручний під час створення структури великого каталогу чи сайту послуг.
Оцінюючи сервіс, необхідно враховувати вартість обробки, підтримувані пошукові системи та можливість вивантаження результатів. Якщо проєкт складається з кількох десятків запитів, складна автоматизація може бути надмірною. Для великих списків переваги пакетної обробки стають помітнішими.
Topvisor
Topvisor пропонує інструменти для роботи з ключовими словами, відстеження позицій та аналізу пошукової видачі. У системі можна зберігати семантику проєкту, досліджувати нові запити та працювати з доступними пошуковими показниками. Додаткові функції допомагають групувати ключі та зв'язувати їх із цільовими сторінками.
Сервіс зручний, коли збирання семантики пов'язане з регулярним моніторингом просування. Наприклад, після розподілу запитів між посадковими сторінками можна відстежувати зміни позицій і перевіряти, наскільки вибрані URL відповідають цільовим ключам.
Перед використанням Topvisor необхідно ознайомитись з моделлю оплати окремих операцій та доступністю потрібних джерел. Для масштабних проєктів витрати залежать від кількості запитів, перевірок та додаткових завдань. Тому вартість краще розраховувати за можливим обсягом роботи, а не лише за наявністю окремих функцій.
Безкоштовні парсери ключових слів
Безкоштовні парсери ключових слів підходять для отримання невеликих списків пошукових підказок та перевірки окремих напрямків. Зазвичай такі рішення мають обмеження щодо кількості операцій, швидкості обробки або доступних джерел. Деякі програми вимагають встановлення та додаткового налаштування, тоді як вебсервіси працюють безпосередньо у браузері.
При виборі безкоштовного інструменту потрібно перевірити, звідки він отримує дані та чи зберігає результати у зручному форматі. Якщо сервіс видає лише пошукові підказки, отримані фрази доведеться перевірити на частотність і релевантність. Також слід зважати на обмеження пошукових систем на автоматизовані звернення.
Парсер ключових слів безкоштовно може закрити невелике одноразове завдання, але для постійної масової роботи часто потрібні додаткові можливості. Особливо це стосується проєктів із кількома мовами, десятками категорій та регулярним оновленням товарного асортименту.
Чим онлайн-парсер відрізняється від програми на комп'ютері?
Онлайн-парсер ключових слів запускається у браузері, тому користувачеві зазвичай не потрібно інсталювати додаткове програмне забезпечення. Більшість операцій виконуються на стороні сервісу, а результати можна отримати через інтерфейс або експортувати до файлу. Такий формат зручний для разових досліджень та спільної роботи.
Локальна програма парсингу ключових слів встановлюється на комп'ютер і може використовувати підключені джерела, власні налаштування та додаткові модулі обробки. В окремих випадках користувач самостійно відповідає за конфігурацію доступу, обмеження запитів та збереження робочих даних.
Вибір залежить від вимог проєкту. Хмарні сервіси зручні при регулярній роботі з різних пристроїв, а локальні програми підходять фахівцям, яким потрібен певний набір налаштувань і повний контроль над процесом. В обох випадках варто перевірити безпеку даних, можливості експорту та умови використання джерел.
Чи можна безкоштовно зібрати велике семантичне ядро?
Велике семантичне ядро можна збирати поетапно, використовуючи безкоштовні джерела та ручну обробку даних. Спочатку готують маркерні запити, потім розширюють список через Google Keyword Planner та пошукові підказки. Для існуючого сайту додатково використовують дані Search Console.
Основна складність полягає у обробці отриманих фраз. При кількох тисячах запитів ручне очищення, перевірка частотності та групування займають значний час. Безкоштовні інструменти можуть обмежувати кількість операцій або не надавати необхідні показники.
Тому перед початком роботи корисно оцінити обсяг проєкту та доступні ресурси. Для невеликої ніші досить простого набору інструментів, а за масового збору платна автоматизація може скоротити час підготовки даних. Підсумкова якість ядра у будь-якому випадку вимагає перевірки спеціалістом.
Бази ключових слів та аналіз семантики конкурентів
Готова база ключових слів містить пошукові фрази, які сервіс зібрав із доступних джерел та зберіг для подальшого аналізу. Такі бази допомагають швидко отримати стартову семантику та вивчити тематичні напрямки. Їхня повнота залежить від регіону, часу оновлення та методики збору даних.
База ключових слів за тематиками особливо корисна під час запуску нового проєкту, коли власна пошукова статистика ще відсутня. Однак готові списки не можна використовувати без перевірки. У них трапляються застарілі запити, чужі бренди, невідповідні географічні уточнення і формулювання з різними пошуковими намірами.
Bukvarix та Keys.so
Bukvarix використовують для пошуку ключових запитів у готовій базі та розширення стартової семантики. Сервіс допомагає виявляти додаткові формулювання та отримувати вихідні дані для подальшої фільтрації. Його можливості необхідно оцінювати з урахуванням доступного регіонального покриття та актуальності бази.
Keys.so орієнтований на дослідження пошукової семантики та конкурентів. З його допомогою можна вивчати доступні дані за доменами і сторінками, знаходити запити, що перетинаються, і аналізувати структуру конкуруючих сайтів. Для SEO-фахівця такі звіти допомагають шукати відсутні тематичні групи.
У разі використання обох інструментів необхідно враховувати особливості джерел даних. Якщо проєкт просувається в українській видачі Google, недостатньо отримати великий перелік запитів із бази, орієнтованої переважно на інший ринок. Зібрану семантику слід додатково перевіряти по регіону та попиту.
Як зібрати ключові слова із сайту конкурента?
Для початку обирають сайти, які дійсно конкурують із проєктом за потрібними товарами, послугами чи інформаційними темами. Потім досліджують їх основні розділи та визначають сторінки, які відповідають цільовому пошуковому інтенту. Для аналізу використовують SEO-платформи з даними про видимість доменів та окремих URL-адрес.
Після вивантаження запитів корисно порівняти кілька конкурентних сторінок, видалити нерелевантні фрази та згрупувати перетини. Наприклад, якщо конкуруючі компанії мають окремі сторінки для певного виду послуги, варто вивчити пошуковий попит та умови власної пропозиції.
Парсер ключових слів із сайтів може виконувати інше завдання – витягувати слова, заголовки та текст безпосередньо з HTML-документа. Такі дані допомагають аналізувати зміст сторінки, але не показують її реальні позиції в Google. Для вивчення органічної семантики потрібні відповідні пошукові бази.
Як використовувати базу ключових слів за тематиками?
Роботу з тематичною базою починають із вибору категорії, що відповідає діяльності компанії. Потім отриманий список поділяють на комерційні та інформаційні запити, виключають невідповідні бренди та географічні уточнення. Після очищення перевіряють частотність і розподіляють фрази по смислових групах.
Наприклад, для магазину будівельних матеріалів база може містити запити про купівлю товарів, характеристики, способи застосування та порівняння виробників. Для каталогу підходять комерційні формулювання, а інструкції та поради краще розподілити між інформаційними матеріалами.
Не варто створювати окрему сторінку для кожної фрази з готової бази. Спочатку визначають пошуковий інтент та порівнюють видачу за близькими запитами. Це допомагає уникнути сторінок, що дублюються та внутрішньої конкуренції між URL одного сайту.
Чим замінити Яндекс Wordstat та Key Collector?
Під час роботи з пошуковою семантикою для Google фахівці часто шукають альтернативи інструментам, орієнтованим на Яндекс. Серед популярних запитів зустрічаються «аналог Wordstat», «аналог Yandex Wordstat» та «альтернатива Key Collector». При виборі заміни необхідно враховувати джерело даних та конкретне завдання, яке виконувала попередня програма.
Яндекс Wordstat показує статистику запитів Яндекса, тому його показники не можна безпосередньо переносити на Google. Аналогічні обмеження виникають при використанні парсерів та баз, які працюють переважно з російською пошуковою системою. Для українських проєктів основою дослідження зазвичай є дані Google і платформ з відповідним регіональним покриттям.
Який аналог Wordstat використовувати для Google?
Найбільш близький за призначенням варіант – Google Keyword Planner. Він допомагає підбирати пошукові фрази та оцінювати попит усередині рекламної системи Google. Для додаткового аналізу використовують Google Trends, що показує динаміку інтересу, та Google Search Console з даними про запити власного сайту.
Якщо потрібно вивчити семантику конкурентів або отримати розширену базу фраз, можна підключити Serpstat, Ahrefs або Semrush. Такі платформи надають додаткові SEO-показники та інструменти дослідження пошукової видачі.
При виборі аналога Вордстату потрібно враховувати відмінність методик розрахунку. Дані рекламних платформ, пошукової аналітики та сторонніх SEO-сервісів можуть помітно відрізнятися. Для порівняння запитів бажано використовувати одне основне джерело та перевіряти спірні показники окремо.
Які існують альтернативи Key Collector?
Альтернативу Key Collector вибирають виходячи зі звичного робочого процесу. Якщо програма використовувалася для масового парсингу та очищення запитів, слід розглянути Rush Analytics та інші спеціалізовані рішення. Для дослідження конкурентів та пошукових показників можуть підійти Serpstat чи Ahrefs.
При необхідності регулярно перевіряти позиції та працювати з семантикою одного проєкту можна розглянути Topvisor. Якщо потрібна проста програма для пошуку ключових слів, іноді достатньо Google Keyword Planner та окремого інструменту для групування результатів.
Повної заміни всіх функцій Key Collector в одному сервісі може не виявитися. Тому перед переходом корисно скласти список необхідних операцій: джерела запитів, частотність, фільтрація, стоп-слова, кластеризація та експорт. Такий підхід допомагає уникнути оплати функцій, що не використовуються.
Що вибрати для українського сайту?
Для українського сайту першорядне значення мають підтримка Google, відповідна регіональна база та коректна робота з українською та російською мовами. Пошукові формулювання у різних мовних версіях можуть відрізнятися, тому механічний переклад готового списку не замінює окреме дослідження семантики.
На першому етапі зручно використовувати Google Keyword Planner та Search Console, якщо сайт вже отримує пошукові покази. Для конкурентного дослідження можна підключити Serpstat або іншу платформу з відповідними даними по Україні. Google Trends стане в нагоді для перевірки сезонності та регіональних відмінностей.
Після збирання запитів бажано підготувати окремі групи для мовних версій сторінок. Це спростить створення коректної структури, мета-тегів та внутрішньої перелінковки. При необхідності кластери додатково перевіряють за видачею Google для цільового регіону.
Як автоматизувати збирання семантичного ядра сайту?
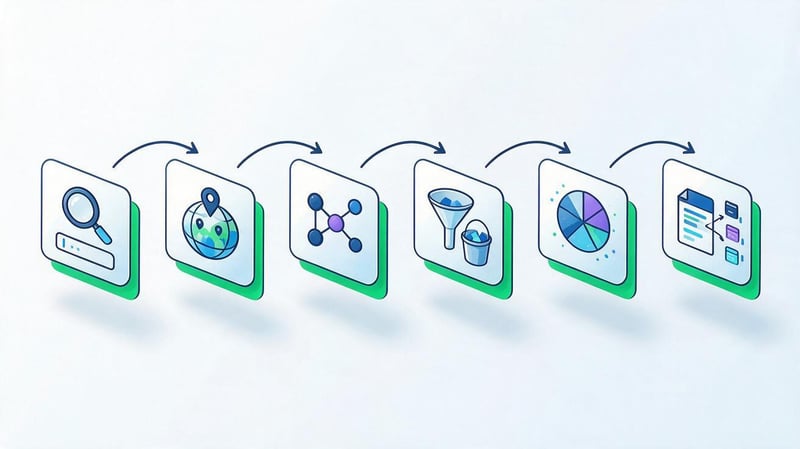
Автоматизація збору семантики починається із послідовного поділу роботи на окремі етапи. Спочатку визначають тематику та пошукові маркери, потім розширюють список запитів, перевіряють показники та видаляють нерелевантні фрази. Після цього виконують кластеризацію та розподіляють групи між сторінками сайту.
Автоматичний збір семантичного ядра допомагає зменшити кількість операцій, що повторюються, особливо при роботі з великими каталогами і багатосторінковими ресурсами. Однак якість кінцевої структури залежить від вихідних даних та правильної інтерпретації результатів. Розберемо практичну послідовність дій на прикладі комерційного сайту.
Чому автоматичну кластеризацію потрібно перевіряти вручну?
Автоматичні алгоритми порівнюють запити за певними ознаками, але той самий термін може використовуватися в різних пошукових ситуаціях. Наприклад, фрази «ремонт автомобіля ціна» та «ремонт автомобіля своїми руками» відносяться до спільної тематики, але передбачають різні типи сторінок. Їхнє механічне об'єднання може призвести до неправильної структури.
При ручній перевірці фахівець оцінює пошуковий інтент, склад видачі та відповідність запитів пропонованій послузі. Якщо Google показує за двома фразами переважно різні типи документів, для них може знадобитися окремий контент.
Також корисно перевіряти запити, які не потрапили до жодної групи. Серед них можуть виявитися вузькі комерційні напрямки чи самостійні інформаційні теми. Видаляти такі фрази без аналізу не слід, оскільки вони іноді допомагають виявити нові можливості просування.
Приклад розподілу запитів за URL
Розглянемо умовний приклад сайту стоматологічної клініки. Після збору та очищення семантики фахівець отримав кілька груп запитів про лікування карієсу, професійне чищення та вартість послуг. Кожну групу потрібно зіставити з відповідною сторінкою.
| Пошуковий запит | Інтент | Кластер | Рекомендована сторінка |
|---|---|---|---|
| лікування карієсу | Комерційний | Лікування карієсу | /services/caries/ |
| лікування карієсу ціна | Комерційний | Лікування карієсу | /services/caries/ |
| вартість лікування карієсу | Комерційний | Лікування карієсу | /services/caries/ |
| симптоми карієсу | Інформаційний | Симптоми карієсу | /blog/caries-symptoms/ |
| як лікують карієс | Інформаційний | Лікування карієсу – стаття | /blog/how-caries-is-treated/ |
| професійне чищення зубів | Комерційний | Гігієна зубів | /services/cleaning/ |
| чистка зубів ціна | Комерційний | Гігієна зубів | /services/cleaning/ |
| як часто робити чистку зубів | Інформаційний | Догляд за зубами | /blog/teeth-cleaning-frequency/ |
| імплантація зубів | Комерційний | Імплантація | /services/implants/ |
| імплантація зубів вартість | Комерційний | Імплантація | /services/implants/ |
Приклад показує попередній розподіл за інтентами. Остаточне рішення приймають після перевірки пошукової видачі, оскільки окремі інформаційні запити Google може пов'язувати з комерційними сторінками або матеріалами іншого формату.
У робочій таблиці також бажано зберігати частотність, пріоритет сторінки, мову та статус оптимізації. Така структура полегшує підготовку SEO-ТЗ, написання мета-тегів та планування внутрішньої перелінковки.
Крок 1. Визначити тематику та скласти список маркерних запитів
Для початку складають перелік основних товарів, послуг та тематичних напрямків компанії. Кожен напрямок описують кількома короткими запитами, які користувачі можуть вводити в Google. До списку включають поширені назви, професійні терміни та зрозумілі клієнтам формулювання.
Наприклад, для стоматологічної клініки маркерами можуть бути «лікування карієсу», «чистка зубів», «імплантація» та «установка брекетів». Окремо збирають назви процедур, види лікування та комерційні уточнення. Такий підхід допомагає не змішувати різні послуги ще до розширення семантики.
На цьому етапі не потрібно прагнути зібрати тисячі варіантів. Достатньо підготувати зрозумілі групи маркерних запитів та перевірити їхню відповідність реальним послугам бізнесу. Чим точніше вихідні категорії, тим менше часу знадобиться на видалення нерелевантних результатів.
Крок 2. Вибрати пошукову систему, мову та регіон
Перед масовим збором необхідно визначити, в якій пошуковій системі та на якому ринку просувається сайт. Для українського проєкту найчастіше обирають Google та відповідний регіон. При локальному просуванні додатково враховують місто чи область, якщо інструмент підтримує такі налаштування.
Мову запитів слід вибирати з урахуванням реальних користувачів та мовних версій сайту. Наприклад, російськомовні та україномовні формулювання однієї послуги можуть мати різну популярність. Тому зручніше збирати їх окремо, а потім зіставляти на етапі планування структури.
Регіональні налаштування особливо важливі для медичних послуг, ремонту, доставки та інших локальних напрямків. Один і той же запит може мати різну пошукову видачу у Києві, Дніпрі чи Львові. Під час подальшого розподілу семантики ці відмінності необхідно враховувати.
Крок 3. Автоматично підібрати додаткові ключові слова
Після підготовки маркерів запускають автоматичний підбір ключових слів через вибрані джерела. Для початкового дослідження можна використовувати Google Keyword Planner, пошукові підказки та доступні бази запитів. Додатково отримують семантику конкурентів та перевіряють пов'язані теми.
Наприклад, запит «лікування карієсу» може розширюватися формулюваннями про вартість, методи лікування, симптоми та відновлення зубів. Частина таких запитів відповідає комерційній сторінці послуги, а інші вимагають інформаційних матеріалів. На етапі збору їх можна зберегти у загальному списку з окремими позначками.
Програма для створення семантичного ядра має підтримувати зрозумілий експорт чи подальшу обробку результатів. Якщо інструмент не дозволяє зручно вивантажити фрази, робота з великим списком ускладнюється. Тому формат CSV, XLSX або інший сумісний спосіб передачі даних слід перевірити заздалегідь.
Крок 4. Перевірити частотність та очистити результати
Після об'єднання даних із різних джерел список очищають від дубльованих та нерелевантних запитів. На цьому етапі корисно перевірити частотність, регіон, мову та основні пошукові наміри. Фрази з невідповідними брендами, чужими містами та послугами, яких немає на сайті, виключають із робочого ядра.
При очищенні використовують мінус-слова, фільтри і перевірку словоформ, що повторюються. Однак, автоматичні правила слід застосовувати обережно, щоб не втратити корисні запити. Наприклад, слово «безкоштовно» може бути нерелевантним для комерційної послуги, але відповідати інформаційній статті.
Після обробки зручно зберегти окремий файл із вихідними даними та очищеною версією семантики. Це дозволить повернутися до видалених фраз за необхідності та порівняти результати різних джерел. Для великих проєктів корисно також фіксувати дату отримання показників.
Крок 5. Згрупувати семантику за допомогою Keyword Clustering Tool від Seo-Gen
Після очищення списку можна перейти до кластеризації ключових слів онлайн у Seo-Gen. Інструмент працює з підготовленими пошуковими фразами та допомагає розділити їх на групи за спільними словами. Додаткові підказки смислової близькості фахівець перевіряє перед остаточним поєднанням запитів.
Для початку достатньо підготувати список ключових слів із частотністю або без неї. Дані можна вставити безпосередньо в інтерфейс або завантажити файлом CSV, XLSX або TXT. Потім у разі потреби задають тематичні основи, редагують стоп-слова і додають словникові відповідності.
Послідовність роботи виглядає так:
- Підготувати вихідні дані. Видалити явні дублікати та зберегти пошукові фрази у зручному форматі, при необхідності додавши частотність.
- Завантажити семантику. Вставити ключі у поле інструмента або вибрати файл із підготовленим списком запитів.
- Налаштувати групування. Додати тематичні основи, перевірити стоп-слова та вказати словникові відповідності там, де це потрібно.
- Розібрати ядро. Запустити обробку та переглянути отримані групи, основні слова та окремі запити.
- Перевірити результати. Оцінити пошуковий інтент, вивчити спірні групи та за необхідності порівняти видачу Google.
- Вивантажити дані. Скопіювати результат або зберегти CSV для подальшого розподілу запитів між сторінками.
Інструмент зручний для первинного лексичного групування та підготовки семантики до ручної SEO-перевірки. Він не отримує пошукові запити з Google автоматично і не замінює окрему кластеризацію за перетином URL у видачі. Тому готові групи використовують як основу подальшої роботи із структурою сайту.
Крок 6. Розподілити кластери між сторінками сайту
Після перевірки кластерів виконують keyword mapping – зіставлення груп пошукових запитів із конкретними сторінками сайту. Для кожної групи визначають основний запит, пошуковий інтент та відповідний тип документа. Потім перевіряють, чи існує на сайті сторінка, яка вже закриває цю потребу.
Якщо релевантна URL-адреса існує, її включають до карти семантики і при необхідності оновлюють контент. Нову сторінку створюють, коли для окремого кластера відсутній відповідний документ. Такий підхід допомагає уникнути непотрібного збільшення кількості сторінок.
При розподілі враховують комерційні запити, інформаційні теми та геозалежні формулювання. Для інтернет-магазину це можуть бути категорії та картки товарів, для сайту послуг – окремі посадкові сторінки, а для блогу – статті, інструкції та тематичні добірки.
Як вибрати сервіс для збирання семантичного ядра?
Вибір сервісу залежить від розміру сайту, кількості запитів, бюджету та регулярності SEO-робіт. Невеликому проєкту зазвичай достатньо кількох джерел пошукових ідей та простого способу групування. Великому інтернет-магазину можуть знадобитися масові вивантаження, автоматизація та регулярне оновлення даних.
Також потрібно визначити, які операції спеціаліст виконує самостійно. Якщо потрібний лише автоматичний підбір ключових слів, немає необхідності оплачувати повний набір функцій технічного аудиту та посилального аналізу. Якщо ж компанія регулярно досліджує конкурентів та відстежує позиції, комплексна платформа може бути зручнішою.
Для невеликого сайту чи лендингу
Для невеликого сайту важливо зібрати запити, які максимально точно відповідають товарам або послугам компанії. Зазвичай досить обмеженого списку маркерів, перевірки попиту та аналізу кількох конкуруючих сторінок. Великий обсяг низькорелевантних фраз лише ускладнює подальшу роботу.
На першому етапі можна використовувати Google Keyword Planner та пошукові підказки, а за наявності статистики додати Search Console. Після очищення ключі зручно згрупувати вручну або за допомогою окремого онлайн-інструменту.
Особливу увагу слід приділити типу посадкової сторінки. Лендинг не завжди підходить для просування великої кількості різних послуг чи пошукових інтентів. Якщо зібрана семантика охоплює самостійні напрямки, може знадобитися розширення структури сайту.
Для інтернет-магазину
Інтернет-магазини зазвичай працюють з великою кількістю категорій, товарів та характеристик. Тому програма для збору семантичного ядра сайту повинна підтримувати масову обробку запитів та зручне вивантаження даних. Для великих каталогів важливі фільтри за брендами, розмірами, матеріалами та іншими товарними параметрами.
Спершу збирають маркери основних категорій, потім розширюють їх комерційними уточненнями. Після перевірки попиту визначають, які фільтри та підкатегорії мають самостійний пошуковий потенціал. При цьому створювати сторінку, що індексується, для кожного поєднання характеристик не потрібно.
Особливо корисна автоматизація при регулярному оновленні асортименту. Якщо в магазині з'являються нові бренди чи товарні групи, семантику потрібно доповнювати та зіставляти з існуючою структурою. Для цього зручні інструменти з підтримкою великих таблиць та повторної обробки даних.
Для блогу чи інформаційного сайту
Для інформаційного сайту особливе значення мають питання користувачів, тематично пов'язані запити та long-tail формулювання. Такі фрази допомагають складати контент-план та розкривати теми, які цікавлять аудиторію. Основним завданням стає розподіл запитів між майбутніми статтями.
Корисно дослідити пошукові підказки Google, Search Console та матеріали конкурентів. Потім запити групують за конкретними питаннями і перевіряють, чи можна розкрити кілька формулювань в одній публікації.
Не слід створювати окрему статтю під кожну близьку фразу. Наприклад, питання «як зібрати семантичне ядро» та «як скласти семантичне ядро сайту» часто можна розкрити одним матеріалом. Остаточне рішення залежить від реальної пошукової видачі та глибини вибраної теми.
Для SEO-агентства та великих проєктів
SEO-агентства регулярно працюють з кількома сайтами, різними регіонами та великими семантичними ядрами. Тому на перший план виходять масова обробка, історія проєктів, доступність API та можливість спільної роботи. Важливою є також передбачувана вартість регулярних операцій.
При виборі платформи корисно перевірити, як організовано експорт, зберігання даних та роботу з кількома мовними версіями. На окрему увагу заслуговують обмеження за кількістю запитів і частотою оновлення показників. Ці параметри можуть суттєво впливати на робочий процес.
Великим проєктам також потрібний контроль якості семантики після автоматичної обробки. Тому зручно зберігати вихідні вивантаження, очищені списки, результати кластеризації та карту розподілу запитів. Такий порядок допомагає відслідковувати зміни та повторно використовувати результати досліджень.
Які критерії враховувати перед оплатою сервісу?
Перед купівлею платного інструменту бажано протестувати його на реальних запитах свого проєкту. Для цього можна підготувати невеликий набір маркерів, кілька конкурентних доменів та перелік завдань. Потім порівняти отримані дані, зручність інтерфейсу та обмеження роботи.
Основні критерії вибору:
- Джерела даних. Перевірити, чи використовує сервіс Google, пошукові підказки, власні бази або інші джерела.
- Регіональне покриття. Переконатися, що доступні потрібні країни, міста та мовні версії.
- Обсяг обробки. Порівняти ліміти на кількість запитів, масові операції та вивантаження результатів.
- Кластеризація. Перевірити, який метод групування використовується і чи можна змінювати результати вручну.
- Експорт даних. Уточнити підтримку CSV, XLSX та інших форматів, потрібних для подальшої роботи.
- Вартість. Розрахувати витрати з урахуванням частоти використання, кількості проєктів та додаткових операцій.
- Зручність роботи. Оцінити фільтрацію, збереження списків, історію дій та можливості спільної обробки.
Після порівняння критеріїв стає зрозумілішим, чи потрібен комплексний сервіс семантичного ядра, чи достатньо кількох спеціалізованих рішень. Для разових завдань часто підходить простий набір інструментів, а постійна масова робота потребує більш розвиненої автоматизації.
Типові помилки автоматичного збирання семантики
Автоматичне створення семантичного ядра скорочує обсяг технічної роботи, але результат залежить від якості вихідних запитів та налаштування обробки. Навіть великий список пошукових фраз може бути марним, якщо він не відповідає тематиці сайту або реальним потребам користувачів.
Помилки найчастіше з'являються при виборі джерел, перевірці частотності та групуванні запитів. Їхні наслідки виявляються вже після створення сторінок, коли окремі URL-адреси починають конкурувати між собою або не відповідають пошуковій видачі. Тому контроль за якістю бажано проводити до розробки структури.
Використання лише одного джерела ключових слів
Одне джерело рідко охоплює всі пошукові формулювання, які можуть бути корисними для просування сайту. Google Keyword Planner показує пошукові ідеї за власною методикою, Search Console містить статистику вже існуючого ресурсу, а сторонні платформи використовують окремі бази даних.
Якщо обмежитися одним сервісом, частина запитів може бути непоміченою. Особливо це стосується вузьких комерційних формулювань, нових товарів та питань користувачів. Для розширення семантики корисно зіставляти кілька відповідних джерел.
При цьому кількість сервісів сама по собі не визначає якість результату. Важливо вибирати джерела, які дійсно доповнюють одне одного та надають релевантні дані. Після об'єднання списків обов'язково виконують очищення дублів.
Вибір запитів виключно за частотністю
Висока частотність показує наявність попиту, але не гарантує комерційну цінність конкретного запиту. Наприклад, інформаційна фраза може залучати багато відвідувачів, які не збираються купувати товар чи замовляти послугу. Тому в оцінці семантики необхідно враховувати інтент.
Для комерційних сторінок часто корисні більш конкретні запити з уточненнями щодо товару, послуги, ціни або місця розташування. Такі формулювання допомагають точніше визначити потребу користувача та підготувати відповідну посадкову сторінку.
Пріоритет запитів краще визначати з урахуванням попиту, конкурентності, відповідності бізнесу та поточної структури сайту. Окремо слід перевіряти сезонність та можливі зміни інтересу. Такий підхід допомагає планувати роботу без орієнтації виключно на найпопулярніші слова.
Об'єднання різних пошукових інтентів
Подібні за формулюванням запити можуть вимагати абсолютно різного змісту сторінки. Наприклад, «купити кондиціонер» передбачає вибір товару, а «як вибрати кондиціонер» частіше пов'язаний з пошуком інформації. Поєднання таких фраз в один комерційний кластер може погіршити релевантність сторінки.
При кластеризації важливо перевіряти склад видачі Google. Якщо за одними запитами переважно показуються категорії товарів, а за іншими – інструкції та огляди, групи краще поділити. Це допомагає точно визначити формат майбутнього контенту.
Особливо уважно слід аналізувати широкі та неоднозначні запити. Вони можуть стосуватися одразу до кількох напрямків бізнесу або різних етапів вибору товару. У таких випадках корисно вивчити реальні результати пошуку та уточнюючі слова.
Відмова від ручної перевірки кластерів
Сервіс кластеризації ключових слів може згрупувати фрази за спільними словами, смисловою близькістю або перетином пошукової видачі. Кожен метод має власні обмеження. Тому автоматичне розподілення слід розглядати як попередній результат, що вимагає перевірки.
Наприклад, близькі словоформи зазвичай легко поєднуються в одну групу, але однакова назва послуги може використовуватися в різних контекстах. Алгоритм не завжди коректно враховує всі комерційні особливості конкретного бізнесу.
Після обробки корисно переглядати граничні групи, окремі запити та потенційні дублі. Якщо кластер об'єднує кілька самостійних послуг, його потрібно розділити. Якщо близькі запити опинилися у різних групах, слід перевірити можливість їхнього об'єднання.
Використання застарілих баз або невідповідного регіону
Пошукові запити змінюються разом з асортиментом товарів, сезонністю та поведінкою користувачів. Тому старі бази можуть містити неактуальні формулювання або не відбивати появу нових послуг. Для динамічних ніш цей ризик особливо помітний.
Регіональні відмінності також впливають на якість семантики. Запит, популярний в одній країні, може практично не використовуватись в іншій. Під час просування локального бізнесу необхідно перевіряти відповідність вибраних даних цільовому регіону.
Для багатомовних сайтів корисно зберігати семантику окремо за мовами та регулярно переглядати основні групи. Це допомагає підтримувати актуальну структуру та своєчасно виявляти нові пошукові потреби.
Сервіси для збору семантичного ядра допомагають знаходити пошукові запити, аналізувати попит та готувати дані для SEO просування. Вибирати інструменти слід за конкретними завданнями: збирання фраз, дослідження конкурентів, перевірка частотності, очищення або кластеризація.
Для невеликих проєктів достатньо Google Keyword Planner та кількох допоміжних рішень. Великим сайтам можуть знадобитися платні платформи з масовою обробкою та розширеними звітами. В обох випадках зібрані запити необхідно перевірити за інтентом та розподілити між відповідними сторінками.
Вже зібрали ключові слова для сайту? Використовуйте Keyword Clustering Tool від Seo-Gen, щоб виконати первинне групування семантики, перевірити отримані кластери та підготувати запити до розподілу між сторінками.


