Аналіз та перевірка семантичного ядра сайту


Семантичне ядро рідко залишається актуальним надовго без перегляду. На сайті з'являються нові сторінки та послуги, пошуковий попит змінюється, частина запитів втрачає значення, а Google починає показувати за звичними ключами сторінки іншого типу. Навіть добре зібрана семантика через кілька місяців може містити зайві фрази, прогалини та неправильно розподілені кластери.
Аналіз семантики сайту допомагає побачити такі проблеми, перш ніж вони почнуть заважати просуванню. Під час перевірки запити порівнюють із пошуковою видачею, сторінками сайту, даними Google Search Console, частотністю та конкурентами. У результаті стає зрозуміло, які групи потрібно зберегти, які розширити, де потрібна нова посадкова сторінка та які URL конкурують між собою.
Що таке аналіз семантичного ядра сайту?
Аналіз семантичного ядра – це перевірка списку пошукових запитів, їхнього групування та розподілу між сторінками сайту. Фахівець оцінює релевантність ключів, їх інтент, частотність, географію, реальну видачу Google та відповідність існуючій структурі. Такий аналіз потрібний як новим проєктам, так і сайтам, які вже отримують органічний трафік.
Перевірка семантичного ядра сайту дає більш точну картину, ніж перегляд однієї таблиці з ключовими словами. Запит може виглядати відповідним за формулюванням, але видача покаже інший сценарій користувача. Наприклад, Google може ранжувати статті за фразою, яку власник сайту планував вести на комерційну сторінку послуги.
Чим аналіз семантичного ядра відрізняється від його збирання?
Збір семантики починається з пошуку потенційних запитів щодо товарів, послуг, проблем користувачів та тематики бізнесу. Для цього використовують маркерні запити, Google Keyword Planner, Serpstat, Ahrefs, Semrush, SE Ranking, пошукові підказки та семантику конкурентів. На цьому етапі список зазвичай виходить широким та містить фрази різної якості.
Аналіз семантичного ядра починається після отримання вихідного списку або проводиться повторно вже для працюючого проєкту. Запити перевіряють за пошуковим інтентом, частотністю, результатами пошуку, цільовою аудиторією та бізнес-релевантністю. Потім виконують групування ключових слів, URL Mapping і визначають, які сторінки підходять для кожного кластера.
Перевірити семантичне ядро також потрібно після його впровадження на сайт. Дані Google Search Console можуть показати, що реальні пошукові запити відрізняються від початкового прогнозу, а окремі сторінки одержують покази за несподіваними ключами. Ці відомості використовують для актуалізації семантики та коригування структури.
Що перевіряють під час аудиту семантики?
Аудит семантичного ядра сайту охоплює якість самих запитів та те, як вони використовуються у структурі проєкту. Перевірка починається з релевантності, але нею робота не закінчується, оскільки навіть відповідні ключі можуть бути неправильно об'єднані або прив'язані до невідповідних URL.
Зазвичай під час аудиту розглядають такі параметри:
- повноту ядра та наявність пропущених тематичних напрямів, які вже мають пошуковий попит;
- відповідність запитів товарам, послугам, географії та реальній цільовій аудиторії сайту;
- інформаційний інтент, комерційний інтент, транзакційні та навігаційні потреби користувачів;
- частотність запитів, сезонність попиту, long-tail запити та низькочастотні запити;
- наявність явних дублів, близьких словоформ та груп з однаковими результатами пошуку;
- якість кластеризації запитів та відповідність кожного кластера окремому пошуковому завданню;
- розподіл груп за існуючими URL-адресами та наявність сторінок, які ще потрібно створити;
- канібалізацію запитів, коли кілька документів одного домену конкурують за однакову семантику;
- позиції сайту, покази, кліки та CTR за даними Google Search Console;
- Content Gap та Keyword Gap щодо реальних пошукових конкурентів.
Після такої перевірки семантичне ядро стає робочою картою для SEO. Його можна використовувати при підготовці мета-тегів, контент-плану, структури сайту та внутрішньої перелінковки, не повертаючись щоразу до необробленого списку запитів.
Відповіді на ваші запитання
Що таке аналіз семантичного ядра?
Аналіз семантичного ядра – це перевірка запитів на релевантність, інтент, частотність, повноту та правильність групування. Додатково ключові слова порівнюють із існуючими сторінками, пошуковою видачею та фактичними даними про позиції.
Такий аналіз показує, які групи підходять сайту, де є прогалини та які URL вимагають доопрацювання. Після перевірки ядро можна використовувати для структури, контент-плану, мета-тегів та внутрішньої перелінковки.
Як перевірити семантичне ядро сайту?
Спочатку збирають існуючі запити та дані Google Search Console, потім перевіряють релевантність, частотність та пошуковий інтент. Після очищення проводять кластеризацію, розподіляють групи за URL-адресами і шукають канібалізацію або відсутні сторінки.
Додатково семантику порівнюють із конкурентами та поточною видачею Google. Така перевірка семантичного ядра сайту допомагає побачити помилки, які не можна виявити звичайним переглядом таблиці ключів.
Чи можна перевірити семантичне ядро сайту онлайн безкоштовно?
Перевірити семантичне ядро сайту онлайн безкоштовно можна частково через Google Search Console, Keyword Planner, Google Trends та ручний SERP-аналіз. Цього достатньо для невеликого проєкту чи первинної перевірки окремих кластерів.
Масовий аналіз конкурентів, історія позицій, Keyword Gap та автоматична кластеризація зазвичай зручніші у платних сервісах. При цьому платний інструмент не скасовує ручну перевірку інтенту та релевантності.
Які помилки можна знайти під час перевірки семантичного ядра?
Аудит допомагає знайти нерелевантні ключові слова, неправильний інтент, смислові дублі, пропущені запити та помилки кластеризації. Також можна виявити сторінки, які конкурують між собою або важливі групи без власної цільової URL-адреси.
Додаткова перевірка показує застарілі частоти, неправильну географію та інформаційні запити на комерційних сторінках. Чим більший проєкт, тим сильніше такі помилки впливають на структуру та подальшу оптимізацію.
Як перевірити, чи правильно кластеризовані запити?
Спочатку порівнюють зміст запитів, потім перевіряють перетин сторінок у пошуковій видачі. Якщо Google регулярно показує однаковий набір документів і намір збігається, ключі зазвичай можна просувати однією сторінкою.
Якщо видача помітно відрізняється чи один запит має комерційний інтент, а інший інформаційний, групу краще переглянути. Автоматичну кластеризацію бажано використовувати як основу, а спірні кластери перевіряти вручну.
Як зрозуміти, що для запиту потрібна окрема сторінка?
Окрема сторінка потрібна тоді, коли група запитів має самостійний інтент і у видачі нею ранжується окремий тип контенту. Додатково перевіряють, чи можна повноцінно розкрити тему на існуючому URL без змішування різних завдань користувача.
Якщо нова сторінка майже повністю повторюватиме вже існуючу, створювати її лише заради іншої словоформи не варто. Спочатку слід порівняти SERP та ймовірність канібалізації.
Як часто потрібно проводити аудит семантичного ядра?
Перевірку бажано проводити після суттєвих змін сайту, запуску нових послуг та помітної динаміки органічного трафіку. Для проєктів, що активно розвиваються, пріоритетні розділи можна переглядати кілька разів протягом року.
Великий сайт зручніше аналізувати за категоріями, не намагаючись щоразу повністю перезбирати десятки тисяч запитів. Періодичність залежить від швидкості зміни асортименту, попиту та пошукової видачі.
Чи можна використовувати ChatGPT для перевірки семантичного ядра?
ChatGPT можна використовувати для попередньої класифікації ключів, пошуку змістових зв'язків, варіантів групування та обробки великих текстових списків. Такий підхід прискорює підготовчий етап, особливо під час роботи з великою кількістю схожих формулювань.
Частотність, позиції, SERP та конкурентність потрібно підтверджувати реальними SEO-даними. Фінальне рішення щодо інтенту, кластеризації та цільових сторінок краще приймати після перевірки пошукової видачі та структури конкретного сайту.
Коли потрібно перевіряти семантичне ядро?
Перевірка семантичного ядра потрібна не за календарем, а в разі змін, які можуть вплинути на попит, структуру або ранжування. Для невеликого стабільного сайту перегляд може проводитися рідше, тоді як інтернет-магазин з асортиментом, що постійно змінюється, вимагає регулярного аналізу окремих категорій.
Є кілька ситуацій, коли перевірка є особливо корисною. До них відносяться запуск просування, зміна структури, поява нових послуг, помітне падіння органічного трафіку та тривала робота сайту без оновлення семантики. У кожному випадку глибина перевірки відрізнятиметься, але базова логіка залишається однаковою.
Перед початком SEO-просування
Перед оптимізацією бажано перевірити семантичне ядро сайту, навіть якщо його підготували раніше інші фахівці або підрядники. Помилка на цьому етапі швидко переноситься в Title, Description, H1, тексти, структуру категорій та внутрішні посилання, після чого виправляти її доводиться відразу на кількох рівнях.
Під час стартової перевірки визначають, які запити належать до бізнесу, які вимагають окремих сторінок та які групи краще виключити. Додатково аналізують пошукову видачу, оскільки однакові за змістом слова можуть вести користувачів до різних типів документів. Такий аудит знижує ризик створення посадкових сторінок без самостійного пошукового інтенту.
Після кількох місяців просування
Через кілька місяців з'являється достатньо фактичних даних, щоб порівняти прогноз із поведінкою сайту у пошуку. Google Search Console показує запити, які дійсно викликають покази, поточні позиції сайту, CTR та сторінки, вибрані Google для конкретних ключових фраз.
Якщо сторінка отримує покази за запитами, яких немає у початковому ядрі, їх слід додати та перевірити. Якщо один кластер постійно викликає покази різних URL-адрес, потрібно вивчити можливу канібалізацію. Аналіз семантики сайту на основі реальних даних зазвичай точніше за початкові припущення, зроблені до запуску просування.
Після зміни структури сайту
Нові категорії, фільтри, напрямки послуг та розділи змінюють розподіл пошукових запитів між сторінками. Старе URL Mapping після такого оновлення може втратити актуальність, тому семантичне ядро сайту перевіряють разом із структурою та внутрішніми посиланнями.
Особливу увагу приділяють сторінкам, які були об'єднані, перенесені або поділені на декілька нових URL-адрес. Потрібно переконатися, що кластери отримали нові цільові сторінки, старі адреси коректно опрацьовані, а близькі документи не претендують на однакові групи запитів. Така перевірка допомагає зберегти накопичену пошукову релевантність.
При падінні органічного трафіку
Падіння трафіку не завжди пов'язане із семантичним ядром, тому спочатку перевіряють період, сторінки та групи запитів, за якими сталося зниження. Якщо просідання зосереджено у певному розділі, аналіз ядра сайту допомагає побачити зміну інтенту, появу сильних конкурентів або втрату релевантності окремих URL.
Корисно порівняти стару та поточну пошукову видачу, позиції та реальні запити з Search Console. Іноді Google починає віддавати перевагу іншому формату сторінки, а іноді дві сторінки сайту поступово починають конкурувати між собою. Перевірка семантики дає напрямок для подальшого технічного та контентного аналізу.
При розширенні бізнесу
Нові послуги, товари, міста та мовні версії вимагають власної семантики навіть якщо на сайті вже існує велике ядро. Просте додавання нових слів до старого файлу створює ризик змішування різних інтентів та регіонів, особливо коли структура проєкту вже досить велика.
Для нового напряму спочатку збирають маркерні запити та оцінюють пошуковий попит, потім порівнюють семантику конкурентів та результати SERP. Після кластеризації нові групи пов'язують із існуючою архітектурою сайту. Якщо потрібної сторінки немає, її додають у план розвитку, а не розподіляють запити між випадковими URL-адресами.
Як перевірити семантичне ядро сайту покроково?
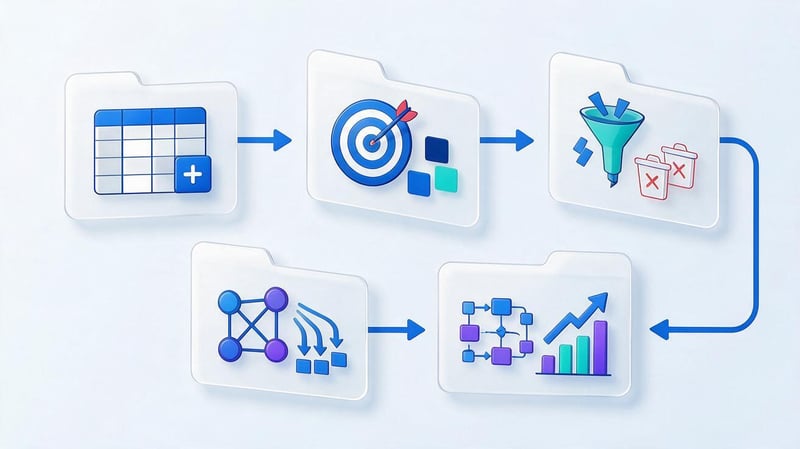
Перевірка семантичного ядра зручніше відбувається за послідовним алгоритмом, оскільки окремий перегляд частотності чи списку ключів не показує стан проєкту цілком. Починати слід з вихідних даних, потім переходити до інтенту, очищення, кластеризації та зіставлення груп із реальними сторінками.
Для працюючого сайту корисно вести аудит у загальній таблиці, де зберігаються запит, частотність, інтент, кластер, цільова сторінка, поточна позиція та необхідна дія. Такий формат допомагає не втратити знайдені проблеми та одразу перетворює аналіз на зрозумілий план подальшої SEO-роботи.
Крок 1. Зберіть поточне семантичне ядро
Спочатку зберіть усі запити, які вже використовуються у проєкті або пов'язані з існуючими сторінками. Якщо старе семантичне ядро збереглося у таблиці, його використовують як основу, проте обов'язково доповнюють фактичними даними. Працювати лише зі старим файлом ризиковано, оскільки в ньому немає запитів, які з'явилися після початку просування.
Для працюючого сайту джерелами стають Google Search Console, система моніторингу позицій, поточна структура, мета-теги та раніше підготовлені документи. Search Console особливо корисний для пошуку фраз, які вже дають покази та кліки. Запити можна вивантажити по кожній важливій сторінці та порівняти з тими кластерами, які спочатку планувалися.
Якщо семантика розкидана між кількома файлами, спочатку об'єднують її і зводять до єдиної структури. Для кожного ключа бажано зберегти джерело та поточну цільову URL-адресу. Після цього аналіз семантичного ядра проводиться без постійного перемикання між різними таблицями та сервісами.
Крок 2. Перевірте релевантність ключових слів
Кожен запит має відповідати реальним товарам, послугам, географії та можливостям бізнесу. Висока частотність не компенсує слабку релевантність, тому що відвідувач із невідповідною потребою рідко виконує цільову дію. Тому семантичний аналіз ключових слів починається з питання, чи конкретна сторінка може дати користувачеві очікувану відповідь.
Наприклад, локальна клініка в Києві може отримати великий список запитів щодо медичної послуги без прив'язки до міста. Проте фрази, які явно стосуються інших регіонів, вимагатимуть видалення або окремої регіональної стратегії. Аналогічно інтернет-магазину не потрібні запити за категоріями товарів, яких немає та не планується в асортименті.
Нерелевантні фрази краще позначати із зазначенням причини виключення, а не видаляти без сліду. Такий підхід стане у нагоді при повторному аудиті і не дозволить знову додати ті ж запити з іншого джерела. Після очищення ядро зазвичай стає меншим, зате подальша кластеризація проходить точніше.
Крок 3. Визначте пошуковий інтент
Пошуковий інтент показує, яку задачу користувач хоче вирішити після введення запиту. Одна людина шукає визначення терміну, інша порівнює варіанти, третя готова замовити послугу або купити товар. Якщо різні наміри об'єднати в одну групу, сторінка вийде розмитою і гірше відповідатиме видачі.
Інформаційні запити частіше ведуть до інструкцій, оглядів та статей, тоді як комерційні запити зазвичай вимагають сторінки послуги, категорії або продукту. Транзакційний інтент виражає готовність до дії, а навігаційний пов'язаний із пошуком конкретного бренду, компанії чи розділу. Межі між типами визначають за фактичним SERP.
Чому потрібно перевіряти інтент безпосередньо в Google?
Формулювання запиту дає попереднє уявлення про інтент, проте остаточне рішення краще приймати після аналізу пошукової видачі. Google вже зіставив запит із поведінкою користувачів та набором сторінок, які частіше відповідають їхнім очікуванням. Тому SERP допомагає бачити реальний формат конкурентного контенту.
Якщо на запит у першій десятці домінують статті, а компанія планує просувати коротку сторінку послуги, потрібно перевірити збіг наміру. Аналогічно, велика кількість категорій інтернет-магазинів у видачі говорить про комерційний характер запиту. При неоднозначній видачі запит можна додатково перевірити за близькими формулюваннями.
При аналізі дивляться не на один результат, а на загальний патерн. Враховують тип сторінок, заголовки, зміст, наявність карток товарів, інформаційних блоків та комерційних елементів. Такий SERP-аналіз допомагає точніше визначити цільову сторінку та уникнути випадкового групування.
Не можна об'єднувати різні інтенти лише через схожі слова
Лексична близькість запитів не гарантує однакового пошукового завдання. Наприклад, фрази «що таке SEO-аудит» та «замовити SEO-аудит» містять одне поняття, але ведуть користувача до різних етапів вибору. Першу логічно розкривати в інформаційному матеріалі, другу – на сторінці послуги.
Та ж проблема виникає при автоматичному групуванні великого ядра. Алгоритм може об'єднати запити через загальний набір слів, хоча у видачі за ними ранжуються різні типи документів. Тому результат кластеризації завжди корисно перевіряти ще раз по SERP, особливо для комерційно важливих груп.
Якщо два запити потребують різних сторінок, це відображають у карті релевантності. Для кожного кластера фіксують його інтент, цільовий URL та роль у структурі. Тоді контент-план та внутрішня перелінковка будуються на зрозумілій логіці, а не на збігу окремих слів.
Крок 4. Перевірте частотність та реальний попит
Частотність допомагає оцінити відносний попит, але не визначає цінність запиту самостійно. Низькочастотні запити часто точніше описують потребу користувача та можуть давати конверсійний трафік. Тому під час перевірки враховують частотність разом з інтентом, тематикою та комерційною цінністю.
Окремо перевіряють сезонність попиту. Деякі товари та послуги мають стабільний інтерес цілий рік, тоді як інші залежать від сезону, свят чи зовнішніх подій. Google Trends допомагає порівняти динаміку кількох формулювань та побачити періоди зростання, хоча цей сервіс не замінює дані про точну частотність.
Long-tail запити не слід видаляти лише через невеликі значення. Вони розширюють тематичне покриття та допомагають точніше розкривати окремі потреби користувачів. При цьому десятки майже ідентичних словоформ можна об'єднувати всередині одного кластера, якщо пошукова видача підтверджує загальний інтент.
Крок 5. Видаліть сміттєві та нерелевантні запити
Після перевірки попиту переходять до очищення ядра від фраз, які не повинні брати участь у подальшій оптимізації. До них відносяться невідповідні міста, чужі послуги, випадкові теми, некоректні значення та запити, які не пов'язані з цільовою аудиторією. Для комерційного проєкту також перевіряють інформаційні ключі, що помилково потрапили на сторінки продажу.
Окремо переглядають чужі бренди. Такі запити іноді корисні для порівняльного або інформаційного контенту, але не можна автоматично включати їх у комерційне ядро. Рішення приймають з урахуванням завдання сторінки, законодавства, реальної користі матеріалу та характеру видачі Google.
Після очищення необхідно знову перевірити розподіл груп. Видалення кількох запитів іноді змінює межі кластера або робить окрему сторінку непотрібною. Тому сміттєві ключі краще прибирати до остаточної URL-карти, а не після підготовки контенту.
Крок 6. Перевірте дублі та словоформи
У великих вивантаженнях часто зустрічаються однакові запити у різних регістрах, змінені закінчення, переставлені слова і дуже близькі фрази. Якщо ставитись до кожного формулювання як до окремої теми, структура сайту швидко розростається і з'являються сторінки з однаковим змістом.
Спочатку видаляють технічні дублі, потім порівнюють смислові варіанти. Запити «аналіз семантичного ядра сайту» та «семантичне ядро сайту аналіз» можуть відноситися до однієї сторінки, якщо SERP підтверджує намір, що збігається. Неприродні варіанти не потрібно буквально вставляти в текст для точного входження.
Під час роботи з формами слів орієнтуються на нормальну мову і результати пошуку. Google вміє пов'язувати багато словоформ і близькі конструкції, тому текст повинен залишатися читабельним. Семантичне ядро перевірити можна без штучного повторення фраз, які користувач сам ніколи не написав би у звичайному реченні.
Крок 7. Проведіть кластеризацію запитів
Кластеризація запитів групує ключі, які можна просувати на одній сторінці. Хороший кластер поєднує загальний інтент і близьку пошукову видачу, тому після групування стає зрозумілішою майбутня структура сайту. Для великих ядер автоматичні сервіси заощаджують час, проте фінальні групи потребують ручної перевірки.
Перед кластеризацією бажано прибрати сміття, дублі та явно нерелевантні фрази. Інакше алгоритм створюватиме групи навколо запитів, які пізніше все одно доведеться виключити. Після автоматичної обробки особливо уважно перевіряють комерційні кластери, тому що помилка в них впливає на посадкові сторінки та конверсію.
Hard-кластеризація
Hard-кластеризація використовує перетини URL у пошуковій видачі та застосовує суворіші умови об'єднання запитів. В одну групу потрапляють ключі, пов'язані через достатню кількість загальних результатів. Такий підхід часто підходить для структури, де потрібно чітко розділити самостійні сторінки.
Сувора кластеризація може створювати більше окремих груп, особливо у неоднозначній тематиці. Тому результат порівнюють із реальною архітектурою бізнесу та можливістю підготувати повноцінну сторінку для кожного кластера. Якщо дві групи відрізняються мінімально і SERP є нестабільним, рішення краще перевірити вручну.
Hard-підхід зручний там, де помилка об'єднання може призвести до змішування різних послуг чи товарних категорій. Він дає технічну основу, але не замінює оцінку пошукового інтенту. Фінальне рішення має враховувати зміст майбутньої сторінки та реальні потреби користувачів.
Soft-кластеризація
Soft-кластеризація допускає більш широкі зв'язки між запитами та формує групи при менш суворому збігу результатів видачі. Вона підходить для інформаційних матеріалів та тематичних блоків, де одна докладна сторінка здатна розкрити декілька близьких формулювань без втрати релевантності.
Після такого розподілу потрібно перевірити, чи не потрапили до одного кластера різні інтенти. Особливо часто це трапляється із запитами, де збігаються основні слова, але користувач очікує різні дії. Автоматичне рішення в подібних випадках краще використовувати як чорнове групування.
Вибір між hard-кластеризацією та soft-кластеризацією залежить від структури проєкту та завдання. На практиці методи можна поєднувати, а спірні групи розбирати вручну. Головний орієнтир залишається однаковим: одна сторінка має послідовно відповідати на загальний набір пошукових потреб.
Крок 8. Розподіліть кластери за URL
Після групування кожному значимому кластеру призначають цільову сторінку. Цей етап часто називають URL Mapping або складанням карти релевантності. У таблиці фіксують запити, інтент, поточний URL, необхідність доопрацювання та статус сторінки, щоб семантика безпосередньо пов'язувалась із структурою сайту.
Приклад робочої карти може мати такий вигляд:
| Кластер | Інтент | Цільова сторінка | Дія |
|---|---|---|---|
| аналіз семантичного ядра | інформаційний | /blog/analiz-semantiki/ | допрацювати |
| замовити збір семантики | комерційний | /services/semantic-core/ | оптимізувати |
| кластеризація запитів | інформаційний | /blog/klasterizaciya/ | створити матеріал |
| SEO-аудит сайту | комерційний | /services/seo-audit/ | залишити окремою |
Така таблиця показує, де вже є відповідна URL, а де потрібна нова сторінка. Вона також допомагає вчасно помітити ситуацію, коли одному кластеру призначено кілька документів. Після розподілу варто окремо перевірити внутрішні посилання, щоб анкори підтримували вибрану карту.
URL Mapping бажано зберігати разом із основною семантикою та оновлювати після змін структури. Тоді під час створення нових матеріалів видно, які теми вже закріплені за існуючими сторінками. Це знижує ризик дублювання контенту та випадкової канібалізації.
Крок 9. Знайдіть канібалізацію
Канібалізація виникає, коли кілька сторінок одного сайту конкурують за близькими або однаковими запитами без зрозумілого поділу інтенту. Google може періодично змінювати вибрану URL-адресу, а позиції стають нестабільними. Така ситуація особливо характерна для блогів з великою кількістю схожих статей та інтернет-магазинів з категоріями, що перетинаються.
Одну з ознак можна побачити в Google Search Console, якщо по одному запиту відображаються різні сторінки. Однак факт двох URL ще не підтверджує проблему, оскільки сторінки можуть відповідати на різні потреби. Потрібно порівняти позиції, видачу, зміст документів, внутрішні посилання та їх призначення у структурі.
Після підтвердження канібалізації вибирають потрібну дію: об'єднати контент, чіткіше розвести інтенти, переробити мета-теги, змінити внутрішню перелінковку або видалити непотрібний дубль з коректним редиректом. Рішення залежить від історії URL, посилань та поточного трафіку, тому універсальної схеми тут немає.
Крок 10. Знайдіть пропущену семантику
Навіть велике ядро рідко охоплює весь актуальний попит. Нові формулювання з'являються у пошукових підказках, Search Console та базах SEO-сервісів, а конкуренти поступово створюють сторінки за темами, яких раніше не було. Тому аналіз семантичного ядра сайту включає окремий пошук прогалин.
Для Content Gap порівнюють домен із кількома реальними конкурентами з органічної видачі. Ahrefs, Serpstat, Semrush та інші сервіси допомагають знайти ключі, за якими конкуренти вже ранжуються, а сайт, що перевіряється, поки відсутній. Не можна додавати отриманий список автоматично, оскільки частина запитів може не відповідати продукту.
Google Search Console показує інший тип прогалин. Іноді сторінка вже отримує покази на корисний запит, хоча цей ключ відсутній у вихідній таблиці. Такі фрази варто додати, перевірити SERP і вирішити, чи достатньо доопрацювати поточний документ чи потрібен самостійний матеріал.
Крок 11. Розставте пріоритети
Після перевірки зазвичай з'являється більше завдань, ніж можна впровадити одночасно. Тому кластери та сторінки розподіляють за пріоритетами з урахуванням потенційного результату та складності робіт. Починати зручно із запитів, які відповідають бізнесу, вже мають видимість та вимагають відносно невеликих змін.
Для оцінки можна враховувати кілька факторів:
- поточні позиції та обсяг показів за даними Google Search Console;
- відповідність запиту товарам, послугам та комерційним завданням компанії;
- пошуковий попит, сезонність та потенційна цінність органічного трафіку;
- наявність відповідної сторінки та обсяг необхідних змін;
- конкурентність видачі та якість документів, які вже перебувають у ТОПі;
- ризик канібалізації та вплив проблеми на інші сторінки розділу.
Після оцінки пріоритетів формується черговість застосування. Спочатку можна доопрацювати сторінки на позиціях 5–20, виправити очевидний перетин URL та закрити значні прогалини структури. Більш складні нові розділи переносять в окремий план контентних і технічних робіт.
Умовний графік пріоритетів може мати такий вигляд:
| Напрям | Пріоритет |
|---|---|
| Запити з позиціями 5–20 та відповідними URL-адресами | 100% |
| Підтверджена канібалізація важливих сторінок | 100% |
| Пропущені комерційні кластери | 80% |
| Нові інформаційні теми | 60% |
| Низькочастотні нерелевантні напрямки | 20% |
Такий графік використовується лише як приклад логіки, оскільки реальний пріоритет розраховується за даними конкретного сайту. Для одного проєкту головним фактором буде виторг категорії, для іншого – обсяг існуючої видимості або вартість створення нової сторінки.
Як перевірити семантичне ядро сайту онлайн?
Перевірка семантичного ядра сайту онлайн складається з кількох окремих завдань, тому що одного сервісу для повноцінного аудиту недостатньо. Одні інструменти пропонують реальні запити сайту, інші показують частотність, позиції, конкурентів або перетини видачі. Тому дані зазвичай збирають із кількох джерел.
Якщо завдання звучить як «перевірити семантичне ядро сайту онлайн», спочатку потрібно визначити, що саме потрібно перевірити. Для оцінки фактичної видимості підходить Google Search Console, для попиту – Keyword Planner, для конкурентного аналізу – SEO-сервіси. Кластеризацію та інтент додатково перевіряють по видачі.
Безкоштовна перевірка семантичного ядра
Аналіз семантичного ядра сайту онлайн безкоштовно можна провести частково, використовуючи дані Google та ручну роботу. Такий варіант підійде для невеликого проєкту чи первинної діагностики, коли потрібно зрозуміти основні помилки. Для великого інтернет-магазину ручна перевірка тисяч запитів швидко стає надто трудомісткою.
Безкоштовний набір може включати Search Console, Keyword Planner, Google Trends та звичайну пошукову видачу. Цього достатньо, щоб знайти реальні запити, оцінити частину попиту, перевірити сезонність та порівняти інтент. Для масового Keyword Gap, історії позицій та автоматичної кластеризації зазвичай зручніші спеціалізовані платформи.
Google Search Console
Google Search Console показує реальні запити, за якими сторінки сайту вже з'являлися у пошуку. У звітах доступні покази, кліки, CTR та середня позиція, а дані можна фільтрувати за сторінками, країнами, пристроями та періодами. Для працюючого проєкту це одне з найцінніших джерел семантики.
Особливо корисно шукати запити з великою кількістю показів та позиціями приблизно від п'ятої до двадцятої. Сторінка вже має певну релевантність, тому її можна перевірити на повноту розкриття теми, мета-теги та внутрішні посилання. Також варто шукати ключі, за якими Google показує несподівану URL-адресу.
Search Console не показує повний ринок та не замінює аналіз конкурентів. Сервіс відображає взаємодію Google саме з вашим сайтом, тому його дані краще поєднувати із зовнішніми базами ключових слів та ручним аналізом SERP.
Google Keyword Planner
Google Keyword Planner допомагає знаходити варіанти ключових слів та оцінювати пошуковий попит. Сервіс зручний для розширення маркерних запитів, порівняння формулювань та первинного аналізу нових напрямків. При перевірці старого ядра через нього можна побачити, які фрази втратили актуальність або більш затребувані варіанти.
Дані Keyword Planner створювалися насамперед для рекламних завдань, тому SEO-фахівцю потрібно враховувати особливості відображення діапазонів та групування запитів. Значення не слід сприймати як точний прогноз майбутнього органічного трафіку. Частотність використовується як один із критеріїв разом з інтентом та реальною видачею.
Для невеликого сайту Keyword Planner часто закриває базове завдання без додаткової оплати. Коли потрібен аналіз тисяч ключів, масова обробка конкурентів чи докладна історія попиту, зручніше підключати спеціалізовані сервіси.
Google Trends
Google Trends показує зміну інтересу до теми у часі та допомагає порівнювати кілька формулювань. Він корисний у нішах із вираженою сезонністю, де однакове середньомісячне значення може приховувати різке зростання попиту на конкретні місяці. Сервіс також допомагає побачити довгострокове зниження чи розвиток теми.
Дані Trends представлені у відносних значеннях, тому використовувати їх як точну частотність не можна. Натомість вони добре доповнюють Keyword Planner та статистику сайту. Під час аудиту семантики можна перевірити, чи пов'язаний спад показів із самою сторінкою чи інтерес до теми знизився на ринку.
Для сезонних категорій таку перевірку бажано робити до висновків про результат SEO. Порівняння кількох років допомагає відокремити звичайний сезонний цикл від реальної втрати видимості.
Платні сервіси аналізу семантики
Платні SEO-платформи прискорюють роботу з великими наборами даних та конкурентами. Serpstat, Ahrefs, Semrush і SE Ranking містять бази ключових слів, дані про позиції, пов'язані запити та домени з видачі. Набір функцій відрізняється, тому сервіс вибирають під конкретні завдання проєкту.
При аудиті через такі платформи зазвичай перевіряють:
- ключі, за якими домен та окремі сторінки вже знаходяться в органічній видачі;
- семантику конкурентів та групи запитів, які відсутні у сайту, що перевіряється;
- динаміку позицій за пріоритетними ключовими словами та розділами;
- варіанти пов'язаних запитів для розширення існуючих кластерів;
- пошукових конкурентів, які справді перетинаються із сайтом у SERP;
- запити та сторінки, здатні доповнити майбутній контент-план.
Отримані дані потрібно фільтрувати, оскільки база будь-якого стороннього сервісу містить похибки і не знає всіх обмежень конкретного бізнесу. Ключ з Ahrefs або Serpstat спочатку перевіряють на релевантність, потім зіставляють з SERP і тільки після цього додають в робоче ядро.
Вартість інструменту сама по собі не визначає якість аудиту. Один сервіс може дати більше вихідних даних, але рішення про структуру та розподіл кластерів все одно приймається після аналізу проєкту.
Чи можна автоматично перевірити семантичне ядро?
Автоматизація добре справляється з обробкою великих таблиць, видаленням технічних дублів, отриманням частотності та попередньої кластеризації. Деякі сервіси також визначають інтент, знаходять схожі ключові слова та порівнюють семантику кількох доменів. Це значно скорочує обсяг ручної роботи.
Повністю передавати рішення алгоритму ризиковано, тому що сервіс не знає всіх особливостей продукту, структури та планів бізнесу. Автоматична група може поєднати два напрями з різною комерційною логікою або запропонувати запит, який формально відноситься до тематики, але не відповідає послугам компанії.
AI можна використовувати для попередньої класифікації, пошуку синонімів та обробки великих списків. Потім фахівець перевіряє ключові групи з фактичних SEO-даних та пошукової видачі. Особливо уважно розбирають комерційні сторінки, регіональну семантику та спірні кластери.
Як аналізувати семантику вже працюючого сайту?
Діючий сайт дає дані, яких немає на етапі початкового збору ядра. Тому аудит краще починати з фактичних показів та сторінок, а потім підключати зовнішні бази та аналіз конкурентів. Такий порядок допомагає зосередитись на запитах, які Google вже пов'язує з доменом.
Семантичне ядро сайту перевірити корисно і на рівні всього проєкту, і в окремих розділах. Для великого магазину або порталу другий варіант зазвичай зручніший, тому що тисячі URL складно якісно розібрати за один прохід. Спочатку вибирають пріоритетний сегмент, потім повторюють методику для інших категорій.
Порівняйте ядро з Google Search Console
Вивантажте запити з Google Search Console за досить довгий період та зіставте їх із поточним семантичним ядром. Окремо позначте ключі, яких немає у робочій таблиці, але які вже одержують помітні покази. Вони можуть підказати нові підтеми або показати, що існуюча сторінка розкриває тему ширше за початковий план.
Корисно виділити запити з позиціями 5–20, високою кількістю показів та низькою CTR. Після цього перевіряють сніпет, відповідність сторінки інтенту та повноту контенту. Якщо URL підходить користувачеві, невелике доопрацювання може дати результат швидше, ніж створення повністю нового документа.
Також порівняйте сторінки, які вибирає Google за одним запитом. Якщо вони постійно змінюються, проведіть додаткову перевірку канібалізації та внутрішньої перелінковки. Іноді проблема вирішується чітким розподілом семантики між існуючими URL-адресами.
Порівняйте запити з існуючими сторінками
Для кожного пріоритетного кластера має бути визначена цільова сторінка, яка справді відповідає запитам. Якщо такої URL-адреси немає, групу відзначають для створення нової сторінки. Якщо підходящих документів кілька, потрібно зрозуміти, чи відрізняються їх інтенти чи виникло непотрібне перетинання.
Перевіряють Title, H1, зміст, внутрішні посилання та роль сторінки в архітектурі сайту. Іноді семантика розподілена правильно у старій таблиці, але після оновлення шаблонів чи контенту фактична сторінка перестає розкривати потрібну тему. Тому аудит ядра бажано проводити разом із базовим on-page аналізом.
Підсумок зручно фіксувати в колонках «залишити», «доопрацювати», «об'єднати», «створити» та «видалити». Тоді перевірка семантичного ядра перетворюється на список конкретних завдань для SEO-фахівця, розробника та копірайтера.
Порівняйте семантику з конкурентами
Для порівняння вибирають сайти, які регулярно перетинаються із проєктом у пошуковій видачі, а не лише відомих гравців ринку. Бізнес-конкурент та пошуковий конкурент можуть відрізнятися, оскільки інформаційний портал іноді займає позиції за тими ж запитами, що й комерційний сайт.
Через Keyword Gap або аналогічний звіт знаходять фрази, за якими конкуренти отримують видимість, а домен, що перевіряється, відсутній. Потім список очищають від чужих брендів, нерелевантних послуг і тем із невідповідним інтентом. Після цього ключі розподіляють по поточних або майбутніх сторінках.
Копіювати структуру конкурента повністю не слід, оскільки асортимент, географія і бізнес-модель можуть відрізнятися. Конкурентний аналіз необхідний для виявлення прогалин і патернів видачі, а остаточне рішення приймається з урахуванням свого проєкту.
Провідний SEO-спеціаліст — Геннадій
Під час аудиту я не оцінюю семантичне ядро за кількістю запитів. Спочатку перевіряю, чи кожен кластер відповідає пошуковому інтенту і чи є на сайті відповідна сторінка. Потім дивлюся, чи не конкурують декілька URL-адрес за однакові запити. У проєктах видалення нерелевантних ключів та нормальний перерозподіл груп часто дає більше користі, ніж механічне розширення файлу тисячами нових фраз.
Основні помилки під час перевірки семантичного ядра
Більшість проблем виникає не через брак SEO-сервісів, а через неправильну інтерпретацію даних. Можна зібрати десятки тисяч ключових слів та отримати незручне ядро, якщо не враховувати інтент, структуру та реальні можливості сайту. Тому якість перевірки залежить від послідовності рішень.
Особливо небезпечні помилки, які потім масштабуються на сотні сторінок. Неправильна кластеризація впливає на структуру, мета-теги та контент, а змішування інтентів призводить до появи документів без чіткого пошукового завдання. Такі проблеми краще виявити до масового впровадження.
Орієнтуватися лише на частотність
Високочастотний запит може залучати велику аудиторію, яка не відповідає продукту чи етапу купівлі. Якщо вибирати ключі лише за кількістю пошуків, комерційна сторінка швидко отримує широкий набір формулювань із різними очікуваннями користувачів.
Частотність слід розглядати разом з інтентом, поточними позиціями, конкуренцією та цінністю трафіку. Іноді кілька точних низькочастотних запитів дають бізнесу більше цільових звернень, аніж один широкий інформаційний ключ. Особливо помітна така різниця у складних послугах та B2B.
При аналізі також перевіряють сезонність та географію. Високе значення для всієї країни може практично не мати сенсу для локального бізнесу, який працює тільки в одному місті.
Не враховувати пошуковий інтент
Запити зі схожими словами можуть вимагати різних сторінок, тому їхнє механічне об'єднання часто створює проблему ще на етапі структури. Користувач, який хоче прочитати інструкцію, чекає на інший контент, ніж людина, яка вже вибирає підрядника або продукт.
Щоб перевірити інтент, дивляться типи документів у пошуковій видачі, їх зміст та комерційні елементи. Якщо SERP явно поділяє дві групи запитів, ядро краще побудувати з таким самим урахуванням завдання користувача. Лексична близькість у такому разі залишається другорядною ознакою.
Інтент слід переглядати при помітних змінах видачі. Google може з часом інакше інтерпретувати запит, особливо в тематиках, що швидко змінюються.
Створювати окрему сторінку під кожне формулювання
Спроба зробити окрему URL для кожної словоформи призводить до великої кількості майже однакових документів. Вони починають конкурувати між собою, одержують слабкий контент і ускладнюють внутрішню перелінковку. Для користувача така структура також виглядає надмірною.
Перед створенням сторінки порівнюють SERP кількох запитів та перевіряють, чи можна розкрити їх одним матеріалом. Якщо набір документів, що ранжуються, і інтент збігаються, фрази частіше відносяться до одного кластера. Різні закінчення та порядок слів самі по собі не вимагають нових URL.
Глибина структури має відповідати самостійності теми. Нова сторінка з'являється тоді, коли вона має окреме пошукове завдання і достатньо змісту для повноцінної відповіді.
Змішувати інформаційні та комерційні запити
Інформаційний матеріал допомагає розібратися у питанні, тоді як комерційна сторінка має давати умови, характеристики, вартість, переваги та можливість виконати цільову дію. Коли обидва сценарії без причини змішуються на одному URL, сторінка може гірше відповідати кожному з них.
Наприклад, запит «як перевірити семантичне ядро сайту» логічно розкривати у докладній інструкції. Фраза «замовити збирання семантичного ядра» орієнтована на вибір послуги та потребує іншої структури. Їх можна пов'язувати внутрішніми посиланнями, але необов'язково просувати однією сторінкою.
При сумнівах рішення приймають після SERP-аналізу. Якщо Google стабільно показує різні типи сторінок, це є сильним аргументом на користь поділу кластерів.
Не аналізувати фактичну видачу Google
Сервіси прискорюють збирання даних, але база ключових слів не показує весь контекст видачі. Пошукова сторінка допомагає побачити формат матеріалів, тип інтенту, конкурентів, додаткові елементи SERP та ступінь схожості між кількома запитами.
Ручна перевірка особливо потрібна для пріоритетних кластерів та спірних рішень. Немає необхідності відкривати видачу для кожної з десятків тисяч фраз, проте ключові групи, від яких залежить архітектура, варто подивитися окремо.
Також враховуйте регіон та мову пошуку. Видача за однаковою фразою може помітно відрізнятися між країнами та мовними версіями сайту, тому семантику не можна механічно переносити між локалями.
Не оновлювати семантику
Семантичне ядро фіксує стан попиту на певний момент, тому через кілька років без перевірки воно неминуче накопичує застарілі дані. Змінюються продукти, термінологія користувачів, конкуренти та структура пошукової видачі. На працюючому сайті додатково з'являється власна статистика.
Актуалізація семантики не означає повне перезбирання кожного місяця. Для стабільного проєкту достатньо регулярно переглядати пріоритетні розділи та проводити глибшу перевірку після значних змін. Частота залежить від масштабу сайту та швидкості змін у ніші.
Хороший орієнтир – аналізувати семантику при запуску нового напряму, після перебудови розділу та за помітної динаміки органічного трафіку.
Повністю довіряти AI або автоматичній кластеризації
AI зручно використовувати для попереднього розподілу великих списків, пошуку тематичних зв'язків і підготовки варіантів класифікації. Автоматична обробка скорочує час, особливо коли вихідна семантика містить десятки тисяч рядків.
Однак модель не бачить актуальну пошукову видачу без відповідних даних та може помилятися у бізнес-релевантності. Навіть коректно розпізнаний зміст запиту не гарантує, що Google поєднує його із сусідніми ключами на одній сторінці.
Фінальну кластеризацію бажано підтверджувати SERP, а частотність та позиції брати з профільних джерел. AI залишається допоміжним етапом аналізу, а не джерелом метрик.
Що має вийти після аудиту семантичного ядра?
Результатом аудиту стає робоча структура даних, якою можна планувати подальшу оптимізацію. У ній залишаються очищені ключові слова, інтенти, кластери, частотність, цільові URL-адреси та конкретні дії. Такий файл повинен бути зрозумілий людині, яка не брала участі в початковому зборі семантики.
Додатково формується список проблем та точок зростання. До нього входять пропущені сторінки, канібалізація, Content Gap, групи для розширення та запити, які вже знаходяться близько до ТОПу. Якщо аудит проводиться перед переробкою сайту, то карта використовується як основа майбутньої архітектури.
Типовий результат можна представити у таблиці:
| Проблема | Як виявити | Що зробити |
|---|---|---|
| Нерелевантні ключі | Перевірити бізнес та SERP | Виключити із робочого ядра |
| Різні інтенти у групі | Порівняти видачу Google | Розділити кластер |
| Декілька URL за одним кластером | Search Console та позиції | Перевірити канібалізацію |
| Немає сторінки під важливий попит | URL Mapping | Створити цільову URL |
| Пропущено запити | Content Gap та Search Console | Розширити ядро |
| Застарілі групи | Попит, SERP, структура | Оновити або видалити |
Після виправлень ядро можна пов'язати з контент-планом, мета-тегами та внутрішньою перелінковкою. Для нових сторінок заздалегідь визначають основний кластер і пов'язані теми, а для існуючих – обсяг необхідних змін.
Такий формат зручний і для контролю впровадження. SEO-фахівець бачить, що вже виправлено, копірайтер отримує конкретну семантику, а розробник розуміє, де потрібно створити, об'єднати чи перенаправити сторінку.
Як часто слід перевіряти семантичне ядро?
Єдиного інтервалу для всіх сайтів немає, оскільки швидкість змін залежить від ніші і масштабу проєкту. Невеликий корпоративний сайт зі стабільним набором послуг може обходитися плановим переглядом кілька разів на рік, тоді як маркетплейс або великий магазин потребує постійної роботи з окремими категоріями.
Перевірку бажано проводити після змін структури, запуску нових послуг, додавання регіонів та помітного падіння органічного трафіку. Ці події впливають на розподіл запитів і можуть швидко зробити стару карту релевантності неточною.
Для великих проєктів зручно перевіряти семантику частинами. Спочатку аналізують комерційно важливі категорії, потім інформаційні кластери та менш пріоритетні розділи. Такий підхід дозволяє впроваджувати виправлення відразу, не чекаючи закінчення аудиту всього домену.
Якщо сайт активно розвивається, корисно регулярно порівнювати ядро з Search Console та конкурентами. Це допомагає знаходити нові запити раніше, ніж прогалини стануть помітними в загальному трафіку.
Аналіз семантичного ядра допомагає перевірити, чи пошуковий попит відповідає реальній структурі сайту і чи правильно розподілені ключові запити між сторінками. Під час аудиту перевіряють інтент, частотність, кластери, позиції, конкурентів, Search Console, канібалізацію та пропущені теми.
Якісне ядро не зобов'язане містити максимальну кількість фраз. Для просування корисніше зрозуміла структура, де кожен значимий кластер пов'язаний з відповідним URL, а запити відповідають реальним товарам, послугам і завданням користувачів.
Якщо семантика збиралася давно, структура сайту змінилася або кілька сторінок конкурують за однаковими запитами, почніть з аудиту пріоритетного розділу. Seo-Gen проведе аналіз семантичного ядра сайту, знайде перетинання та пропущені кластери та підготує рекомендації для подальшої SEO-оптимізації.


