Индексация сайта в Google: проверка и ошибки Search Console


После публикации новой страницы она не появляется в поиске автоматически. Сначала Google должен обнаружить URL, просканировать его, обработать содержимое и решить, нужно ли добавлять документ в индекс. Между публикацией и появлением страницы в поиске может пройти разное время, поэтому сам факт отсутствия URL в выдаче еще не указывает на техническую ошибку.
Индексация сайта в Google требует разбирать конкретный статус страницы. Один URL может быть закрыт через noindex, другой возвращать 5xx, третий оказаться дублем, а четвертый уже находиться в индексе, но не иметь позиций по нужному запросу. Google Search Console помогает разделить эти ситуации и понять, на каком этапе возникла проблема.
Что такое индексация сайта в Google и как она работает?
Индекс Google можно представить как базу документов, которые поисковая система обработала и рассматривает для показа в поиске. До попадания туда URL проходит несколько этапов. Поэтому фразы «Google знает страницу», «Google просканировал страницу» и «страница индексируется» описывают разные состояния.
Типичная последовательность выглядит так:
обнаружение URL → crawl → получение HTML → рендеринг страницы → анализ содержимого → выбор canonical → indexing → возможное участие в поиске.
Страница может остановиться практически на любом этапе этой цепочки. Например, Google может знать URL из sitemap.xml, но пока не выполнить сканирование сайта. В другом случае Googlebot уже получил страницу, однако поисковая система решила пока не добавлять ее в индекс.
Как Google находит новые страницы?
Googlebot узнает об URL из внутренних и внешних ссылок, XML Sitemap, уже известных страниц сайта и других доступных источников. Хорошая внутренняя перелинковка помогает поисковому роботу находить новые документы и понимать их место в структуре сайта.
Если новая статья существует только по прямому адресу и ни одна индексируемая страница на нее не ссылается, обнаружение и повторное сканирование могут происходить медленнее. Такие URL часто называют orphan page. Для важных страниц лучше создавать нормальный путь от раздела, категории или другой тематически связанной страницы.
Sitemap тоже передает Google список URL, но присутствие страницы в файле не гарантирует индексирование. Карта сообщает поисковой системе, какие адреса владелец считает значимыми для обхода. Для регулярно обновляемого сайта полезен корректный <lastmod>, если дата действительно отражает существенное изменение документа.
Что происходит после обнаружения URL?
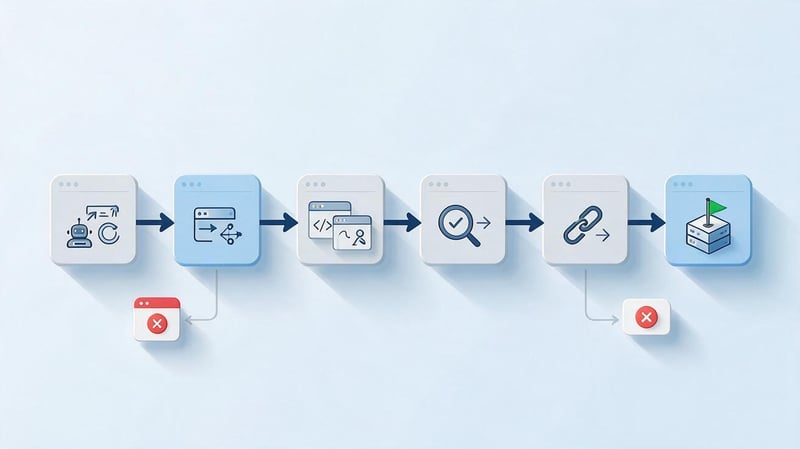
После обнаружения адрес попадает в систему планирования обхода. Google определяет, когда URL стоит запросить, получает серверный ответ и анализирует HTTP-код. Если доступ разрешен, поисковый робот загружает необходимые ресурсы и обрабатывает содержимое страницы.
Для страниц, где значимая часть содержимого создается через JavaScript, дополнительно имеет значение рендеринг. Если в исходном HTML почти ничего нет, а после выполнения скриптов основной текст не появляется или загружается с ошибкой, Google может увидеть страницу иначе, чем пользователь в браузере.
После обработки Google сравнивает документ с другими известными версиями. На этом этапе учитываются дубли страниц, редиректы и сигналы canonical. Затем поисковая система выбирает канонический URL и принимает решение об индексировании.
Чем сканирование отличается от индексирования?
Сканирование означает, что Googlebot запросил URL и получил от сервера определенный ответ. Индексирование происходит позже и означает, что Google добавил обработанный документ в свой поисковый индекс. Между этими действиями нет автоматической связи.
Поэтому статус «Просканирована, но пока не проиндексирована» не противоречит работе поисковой системы. Google уже получил URL, но пока не включил его в индекс. Причиной может быть состояние страницы, дублирование, качество содержимого или решение системы, точную внутреннюю причину которого Search Console не показывает.
Чем индексация отличается от ранжирования?
Если URL есть в индексе Google, это еще не означает, что пользователь увидит его по конкретному коммерческому или информационному запросу. После индексирования начинается отдельная задача – определить релевантность документа и его место среди других результатов.
Поэтому отсутствие позиции нельзя автоматически трактовать как ошибку индексирования. Сначала нужно проверить URL через URL Inspection и убедиться, что страница действительно находится в индексе. Если статус нормальный, анализ продолжают уже на уровне семантики, контента, внутренних и внешних сигналов.
Ответы на ваши вопросы
Как проверить, проиндексирован ли сайт в Google?
Для отдельной страницы используйте URL Inspection в Google Search Console. Инструмент показывает, есть ли URL в индексе Google, когда он сканировался и какой canonical выбрала поисковая система.
Оператор site: подходит для быстрой ориентировочной проверки домена, но не дает точного количества проиндексированных страниц. Для большого сайта общую динамику лучше смотреть в Page Indexing.
Как отправить сайт на индексацию Google?
Одну новую или обновленную страницу можно отправить через URL Inspection и кнопку Request Indexing. Перед отправкой проверьте live-версию и убедитесь, что Googlebot может получить содержимое.
Для большого количества URL используют Sitemap и внутреннюю перелинковку. Google рекомендует карту сайта вместо ручной отправки множества страниц.
Сколько времени занимает индексация страницы в Google?
Фиксированного срока нет, потому что Google самостоятельно планирует обход и обработку URL. Одна страница может быть обработана быстро, другая останется в ожидании дольше.
Request Indexing не дает гарантированного срока и не гарантирует попадание страницы в индекс. Если ожидание затянулось, нужно проверить технический статус и содержимое URL.
Почему Google не индексирует страницу после запроса?
Причиной может быть noindex, robots.txt, 5xx, redirect error, дублирование, canonical или состояние самой страницы. Кроме того, Google может просканировать технически доступный URL и пока не включить его в индекс.
Поэтому повторная отправка запроса без диагностики редко решает проблему. Сначала нужно определить текущий статус через Search Console и проверить опубликованную версию.
Что означает «Просканирована, но пока не проиндексирована»?
Googlebot уже получил страницу, однако Google пока не добавил документ в индекс. Search Console не сообщает единственную точную причину такого решения.
Для важного URL проверяют дубли, canonical, самостоятельную ценность содержимого, внутренние ссылки и рендеринг. Повторная отправка неизмененной страницы обычно не является решением.
Что означает «Обнаружена, но пока не проиндексирована»?
Google знает адрес, но еще не выполнил полноценное сканирование. Такое состояние может временно встречаться на новых страницах и не обязательно означает ошибку.
При массовом и длительном статусе проверяют структуру ссылок, Sitemap, сервер, большое число параметров и другие источники лишних URL. Для важных страниц нужно убедиться, что Google может нормально добраться до них.
Как исправить ошибку переадресации в Google Search Console?
Сначала нужно получить всю redirect-цепочку от исходного URL до конечного адреса. Затем убрать циклы, некорректные URL и лишние промежуточные переходы.
После исправления обновляют внутренние ссылки и Sitemap, проверяют конечную страницу и запускают Test live URL. Если проблема была массовой, после проверки нескольких примеров можно использовать Validate Fix.
Нужно ли каждый день повторно отправлять страницу на индексацию?
Нет, повторная отправка неизмененного URL не является способом ускорить работу Google. Сначала нужно понять, почему страница отсутствует в индексе.
Если URL технически исправен, запрос уже отправлен, а Google его обработал, дальнейшие действия зависят от текущего статуса. Для Crawled – currently not indexed ежедневные запросы не устраняют причину.
Нужно ли исправлять все страницы из раздела «Не проиндексировано»?
Нет, потому что часть URL исключается из индекса намеренно и правильно. К этой группе относятся корректные redirects, альтернативные canonical-страницы, удаленные URL и страницы с осознанным noindex.
Исправлять нужно случаи, где фактический статус противоречит назначению страницы. Поэтому сначала определяется роль URL, а уже потом принимается техническое решение.
Как массово отправить исправленную ошибку на проверку?
После исправления всей группы откройте конкретную проблему Page Indexing и нажмите Validate Fix. Перед запуском проверьте несколько URL через live inspection, чтобы убедиться, что изменение работает на всем шаблоне.
Google сначала проверит выборку, затем поставит известные затронутые URL в очередь на повторную проверку. Весь сайт при этом автоматически не сканируется.
Сколько длится Validate Fix?
Google указывает, что validation обычно занимает до примерно двух недель, хотя отдельные проверки могут идти заметно дольше. Повторно запускать процесс до завершения текущего цикла не рекомендуется.
Продолжительность зависит от количества страниц и фактического повторного обхода. Для больших разделов нужно закладывать время на то, чтобы Googlebot снова посетил известные URL.
Что делать, если Validate Fix получил Failed?
Откройте See details, найдите Failed и Pending URL и повторно проверьте типовые страницы. Затем нужно определить общий источник проблемы и исправить все оставшиеся экземпляры.
После завершения неуспешного цикла запускают Start new validation. Google повторно проверит Pending, Failed и новые экземпляры, а уже прошедшие Passed и Other не будет ставить в очередь заново.
Как проверить индексацию сайта в Google?
Для быстрой оценки можно использовать обычный поиск, однако для диагностики конкретной страницы лучше сразу переходить в Google Search Console. Отчет Page Indexing дает общую картину по сайту, а инструмент проверки URL показывает данные по одному адресу.
Проверять сайт на индексацию в Гугл желательно в двух масштабах. Сначала нужно понять, нет ли массовой проблемы с целым шаблоном или разделом. Затем вручную проверяются важные URL, потому что общий график не объясняет состояние каждой конкретной посадочной страницы.
Проверка через оператор site:
Для ориентировочной проверки можно ввести в Google:
site:example.com
Такой запрос показывает страницы домена, которые поисковая система может вывести по этому оператору. Для отдельного адреса можно попробовать запрос формата:
site:example.com/category/page/
Этот способ удобен для быстрой ручной проверки, но количество результатов не следует использовать как точный размер индекса. Выдача по оператору site: может быть неполной, а цифры могут меняться без реального удаления такого количества страниц.
Если нужно точно разобраться с конкретной страницей, переходят в Search Console. Для больших сайтов также используют отчет об индексировании страниц, где видна динамика индексируемых и неиндексируемых URL.
Как проверить URL через Google Search Console?
Откройте нужный ресурс в Google Search Console и вставьте полный адрес страницы в строку проверки сверху. Инструмент проверки URL, или URL Inspection, покажет данные о версии, которую Google знает после последнего обхода. Для диагностики текущего состояния дополнительно запускают проверку опубликованной страницы.
Порядок проверки выглядит так:
- Выберите нужный ресурс Search Console и вставьте полный URL.
- Дождитесь данных о состоянии страницы в индексе Google.
- Посмотрите дату последнего сканирования и тип Googlebot.
- Проверьте разрешение на сканирование и индексирование.
- Сравните User-declared canonical и Google-selected canonical.
- При необходимости запустите Test live URL.
После списка нужно оценить данные вместе. Например, старая сохраненная версия может показывать noindex, который разработчик уже удалил. В таком случае проверка опубликованной страницы покажет текущее состояние, а отчет обновится позже, после нового обхода Google. URL Inspection предназначен именно для диагностики отдельных страниц и запроса повторного индексирования.
Какие данные проверять в инструменте проверки URL?
В первую очередь смотрят статус индексирования, время последнего обхода и возможность получения страницы. Эти данные помогают понять, относится ли информация Search Console к текущей версии сайта или Google еще не видел последние изменения.
Далее проверяют источник обнаружения URL, referring page и Sitemap. Поле с Sitemap показывает известные Search Console карты, которые указывают на этот адрес. Отсутствие referring sitemap само по себе не означает ошибку, если Google обнаружил страницу другим способом.
Отдельного внимания требует canonical. Если владелец указал один канонический URL, а Google выбрал другой, нужно сравнить внутренние ссылки, Sitemap, редиректы, содержание дублей и другие сигналы. Canonical учитывается Google как сигнал, а окончательный выбор основной версии поисковая система делает самостоятельно.
Как отправить сайт на индексацию Google?
Способ зависит от количества страниц. Для одной новой или существенно обновленной страницы подойдет запрос индексации в Google Search Console. Для большого сайта ручная отправка каждого адреса не нужна – Google рекомендует использовать Sitemap и нормальную доступную структуру ссылок.
Перед отправкой стоит убедиться, что страница вообще готова к индексированию. Если URL возвращает 5xx, содержит noindex, закрыт в robots.txt или перенаправляет на другой адрес, повторный запрос не исправит первопричину.
Как отправить отдельную страницу на индексацию через Search Console?
Если нужно понять, как отправить сайт на индексацию в части одного URL, последовательность достаточно короткая. Откройте URL Inspection, вставьте адрес, проверьте опубликованную версию и убедитесь, что Google может получить страницу.
После успешной проверки можно нажать Request Indexing, то есть «Запросить индексирование». Google поставит URL в очередь на повторную обработку. Это подходит для новой страницы, недавно исправленного технического URL или документа, где произошло заметное обновление содержимого.
Запрос «отправить сайт на индексацию Google» часто понимают слишком буквально. Для целого проекта нет кнопки, которая мгновенно отправит все страницы в индекс. Google обнаруживает и переобходит сайт через структуру ссылок, карты сайта и собственную систему планирования сканирования.
Что происходит после нажатия «Запросить индексирование»?
После запроса Google может повторно просканировать страницу, однако отправка не гарантирует добавление документа в индекс. Если URL недоступен, инструмент сообщит о проблеме. При превышении лимита ручных запросов дополнительная отправка тоже не дает способа обойти ограничения.
Повторное нажатие кнопки несколько раз подряд не делает страницу качественнее и не исправляет canonical, серверный ответ или дубли. Поэтому запрос индексирования используют после технической проверки, а не вместо нее.
Если страница уже имеет статус «Просканирована, но пока не проиндексирована», бессмысленно каждый день отправлять тот же URL без изменений. В такой ситуации полезнее проверить содержимое, перелинковку, дубли и общую роль страницы в структуре сайта.
Как отправить на индексацию много страниц?
Для десятков, сотен или тысяч URL используют XML Sitemap. Google прямо рекомендует карту сайта для запроса обхода нескольких страниц вместо ручной отправки каждой через URL Inspection.
В Sitemap нужно указывать канонические URL, которые действительно предполагается индексировать. Туда не стоит массово добавлять 404, страницы с noindex, адреса с 301 redirect и технические дубли. Такие противоречивые сигналы усложняют диагностику.
Кроме Sitemap, новые страницы должны иметь внутренние ссылки. Если категория, услуга или статья присутствует в карте, но остается изолированной от основной структуры сайта, технически Google может ее обнаружить, однако архитектура проекта все равно остается слабой.
Нужно ли каждый раз отправлять Sitemap заново?
Если файл доступен и уже известен Google, удалять и повторно добавлять его после каждого изменения не требуется. Google периодически обращается к карте и видит обновленный список URL.
Заново отправить Sitemap имеет смысл после существенного изменения конфигурации или если Search Console сообщает, что файл не удалось получить. В обычной ситуации достаточно поддерживать карту актуальной и не помещать туда URL, которые заведомо не должны индексироваться.
Для контроля удобно фильтровать Page Indexing по конкретному Sitemap. Так можно отдельно увидеть состояние именно тех страниц, которые владелец сайта считает индексируемыми.
Почему страницы не индексируются в Google Search Console?
Раздел «Почему страницы не индексируются» нельзя воспринимать как список поломок. Часть статусов описывает нормальное поведение: страница с корректным редиректом не должна индексироваться под старым URL, а альтернативный дубль с правильным canonical может быть исключен намеренно.
Перед исправлением любого статуса нужно ответить на один вопрос: должна ли эта страница находиться в поиске как самостоятельный URL? Если ответ отрицательный, отсутствие индексирования часто соответствует задаче сайта. Google в своей документации отдельно указывает, что неиндексируемые страницы не всегда означают ошибку.
Ошибка сервера (5xx)
Статус Server error (5xx) означает, что во время запроса Google сервер ответил ошибкой уровня 500 или не смог нормально обработать запрос. Сюда относятся 500 Internal Server Error, 502 Bad Gateway, 503 Service Unavailable, 504 Gateway Timeout и другие серверные сбои.
Причиной может быть перегруженный сервер, ошибка приложения, проблема reverse proxy, CDN, база данных, слишком долгая генерация страницы или блокировка Googlebot защитной системой. Если 5xx появляются на важных категориях, товарах, услугах или статьях, проблему нужно исправлять.
Продолжительные серверные ошибки мешают Google получать содержимое и повторно обрабатывать URL. При массовом росте 5xx стоит дополнительно открыть Crawl Stats, проверить ответы хоста и сопоставить начало ошибок с релизами или изменениями инфраструктуры.
Разовый 503 во время краткого технического обслуживания не требует переделки всей SEO-структуры, если сайт уже работает стабильно. Но такой случай все равно нужно перепроверить: временная ошибка и регулярный сбой выглядят одинаково в одном отдельном запросе.
Ошибка переадресации
Ошибка переадресации Google Search Console означает, что Google начал переход по redirect, но не смог корректно добраться до ожидаемого конечного URL. Среди официально перечисленных причин Google называет слишком длинную цепочку, redirect loop, чрезмерно длинный URL внутри цепочки и некорректный либо пустой адрес.
На практике дополнительно проверяют комбинации HTTP и HTTPS, www и non-www, варианты со слэшем и без него, языковые правила, CDN и серверные перенаправления. После миграции несколько независимых правил могут последовательно срабатывать на одном URL и создавать ненужную цепочку.
Исправлять такую ошибку нужно, если адрес участвует во внутренней перелинковке, находится в Sitemap, получает внешние ссылки или должен вести пользователя на новую страницу. Желательно, чтобы старый URL сразу перенаправлялся на конечный релевантный адрес.
Обычный рабочий 301 не относится к ошибке переадресации. Если старый адрес корректно перенаправляет на новый, сам старый URL не должен индексироваться. В таком случае проверяют только то, что внутренние ссылки и Sitemap уже используют конечный адрес.
URL заблокирован файлом robots.txt
Статус URL blocked by robots.txt появляется, когда Googlebot не может сканировать страницу из-за правила Disallow. Причина обычно находится в общем robots.txt, отдельном правиле для определенного User-agent или слишком широком шаблоне пути.
Если заблокирована коммерческая категория, услуга, товар, статья или другая страница, которая должна индексироваться, правило нужно исправлять. Иначе поисковый робот не сможет нормально получать содержимое документа и отслеживать его изменения.
Если речь идет о технических фильтрах, внутренних служебных URL или других адресах, которые действительно не следует сканировать, исправление не требуется. Блокировка соответствует архитектуре сайта, если она поставлена осознанно.
При этом robots.txt нельзя считать надежной командой удаления уже известного URL из индекса. Google указывает, что заблокированная страница в редких случаях может быть известна по другим сигналам. Для noindex роботу сначала нужно разрешить загрузить страницу и прочитать соответствующую директиву. Для того чтобы просканировать страницу и получить tag noindex, данный URL должен отсутствовать в файле robots.txt.
URL помечен как noindex
Статус URL marked noindex означает, что Google обнаружил директиву noindex в meta robots или HTTP-заголовке X-Robots-Tag. В такой ситуации поисковая система не должна добавлять документ в индекс.
Исправлять статус нужно, если noindex случайно остался на публичной странице после разработки, миграции или смены шаблона. Особенно опасны массовые случаи, когда директива появляется на всех товарах, категориях или языковых версиях.
Если закрывается корзина, внутренний поиск, служебная страница или другой документ, который намеренно не нужен в выдаче, noindex работает правильно. Google прямо пишет, что при намеренном исключении такой статус является ожидаемым.
После удаления директивы полезно запустить Test live URL, убедиться, что текущая версия действительно разрешает indexing, и только затем при необходимости использовать Request Indexing. Проверка старых данных без live-теста может привести к ошибочному выводу.
Soft 404
Soft 404 возникает, когда сервер технически возвращает успешный ответ, часто 200 OK, но содержимое выглядит как отсутствующая страница. Типичный пример – товар удален, а шаблон сообщает «ничего не найдено», продолжая отдавать код 200.
Проблема встречается на пустых категориях, страницах удаленных объектов, результатах фильтрации и шаблонах с недостаточным содержимым. Google может решить, что такой URL фактически не представляет самостоятельного документа.
Если страница реально существует и должна индексироваться, нужно проверить содержимое и то, как Google видит ее после рендеринга. Если объекта больше нет и замены не существует, серверу лучше возвращать настоящий 404 или 410, а не маскировать отсутствие страницы успешным кодом.
Google рекомендует проверять Soft 404 через live inspection и смотреть отрендеренную страницу. Попытка перенаправить все удаленные URL на главную часто ухудшает ситуацию, потому что такой redirect не соответствует содержанию исходной страницы.
Страница заблокирована запросом авторизации (401)
Ответ 401 Unauthorized означает, что для получения страницы сервер требует авторизацию. Googlebot не входит в личные кабинеты как обычный пользователь, поэтому закрытый URL не может обрабатываться как стандартная публичная посадочная страница.
Если 401 появляется на категории, статье, товаре или услуге, предназначенной для органического поиска, нужно проверять настройки сервера, CMS, middleware или системы безопасности. Публичному документу требуется доступ без пользовательской авторизации.
Для личного кабинета, CRM, закрытого раздела партнеров и других приватных данных этот статус может быть нормальным. Нет необходимости открывать такую страницу Google только ради исчезновения строки из отчета.
Критерий достаточно простой: если пользователь из обычного поиска должен получить страницу без входа в аккаунт, ответ 401 противоречит задаче. Если доступ предусмотрен только после авторизации, поисковая индексация обычно не нужна.
Страница не найдена (404)
Статус Not found (404) означает, что сервер сообщает Google об отсутствии ресурса. Такие URL появляются после удаления товаров и статей, изменения структуры, ошибок внутренних ссылок, старых внешних ссылок или генерации неправильных адресов.
404 нужно исправлять, когда страница должна существовать, находится в Sitemap или на нее ведут внутренние ссылки. Если контент переехал на релевантный новый URL, обычно используют 301 redirect и одновременно обновляют внутренние ссылки.
Когда страница удалена окончательно и подходящей замены нет, корректный 404 не считается SEO-проблемой. Google прямо указывает, что обычные 404 для действительно отсутствующих URL не вредят сайту сами по себе.
Не следует перенаправлять каждый удаленный адрес на главную страницу. Такой маршрут не объясняет пользователю и поисковой системе, где находится эквивалент удаленного контента, и способен привести к дополнительным Soft 404.
Доступ запрещен (403)
Ответ 403 Forbidden означает, что сервер понял запрос, но отказал в доступе. Причиной могут быть firewall, CDN, anti-DDoS, правила безопасности, фильтрация User-agent, IP-ограничения или права доступа внутри приложения.
Если 403 получают обычные публичные страницы, нужно проверить серверные логи и правила защиты. Иногда сайт нормально открывается владельцу из браузера, но запрос Googlebot блокируется отдельным защитным сценарием.
Для действительно закрытых ресурсов исправление может не требоваться. Например, внутренний административный раздел не обязан становиться доступным роботу только потому, что Google когда-то узнал его URL.
При массовых 403 полезно сравнить время появления проблемы с изменениями CDN и firewall. Если блокируются тысячи важных URL, ручная отправка на индексацию не поможет, пока Googlebot не сможет получать страницы.
URL заблокирован из-за другой ошибки 4xx
В эту группу попадают клиентские ошибки, которые не выделены Search Console в отдельный статус. Это могут быть 400, 405, 408, 410, 429 и другие ответы уровня 4xx.
Для каждого такого URL сначала нужно определить, какой код возвращается и соответствует ли он назначению страницы. Например, 410 Gone может быть совершенно нормальным для окончательно удаленного документа, а 429 Too Many Requests на важных страницах способен указывать на слишком жесткие ограничения сервера.
Исправление требуется, когда индексируемая страница неожиданно возвращает 4xx. Тогда Google не получает обычный документ и не может обрабатывать его как доступный URL.
Если код выбран намеренно и соответствует реальному состоянию ресурса, менять его ради отчета не нужно. Цель проверки – привести технический ответ в соответствие с фактической ролью страницы.
Просканирована, но пока не проиндексирована
Статус Crawled – currently not indexed означает, что Google уже посетил URL, но пока не добавил его в индекс. Повторно отправлять страницу только ради изменения этого статуса Google не рекомендует, потому что причина обычно лежит не в отсутствии запроса на сканирование.
Для важных страниц проверяют самостоятельную ценность содержимого, совпадение с другими URL, canonical, внутренние ссылки, шаблонность и фактический HTML после рендеринга. Thin content тоже может быть полезным сигналом для анализа, хотя Search Console не сообщает конкретный внутренний фактор принятого решения.
Если статус массово появился на новых городских посадочных, тегах, фильтрах или программно созданных страницах, нужно сравнить эти URL между собой. Сотни документов с минимальными различиями часто требуют пересмотра самой структуры, а не дополнительных Request Indexing.
Исправлять статус нужно для страниц, которые действительно имеют отдельный поисковый интент и ценность. Для вторичных дублей или малоценных технических URL отсутствие в индексе может быть ожидаемым.
Обнаружена, но пока не проиндексирована
Discovered – currently not indexed означает, что Google знает адрес, но еще не выполнил полноценное сканирование. В таком случае дата последнего обхода обычно отсутствует, потому что Googlebot пока не получил страницу.
Причиной может быть большое количество URL, низкий приоритет обхода, слабая внутренняя структура, медленный сервер, параметры, бесконечные фильтры или другие источники большого URL-пространства. Google также может откладывать обход, если считает, что интенсивное сканирование создаст нежелательную нагрузку.
Для нового URL короткий период такого состояния не требует срочного вмешательства. Если же неделями или массово остаются важные категории и услуги, нужно проверить Sitemap, внутренние ссылки, сервер и количество генерируемых адресов.
Отдельно стоит искать crawl traps – бесконечные комбинации параметров, календарей, сортировок и фильтров. Они расходуют внимание поискового робота на технические URL вместо приоритетных страниц.
Альтернативная страница с правильным тегом canonical
Статус Alternate page with proper canonical tag обычно описывает нормальную ситуацию. Google распознал текущий URL как альтернативную версию и считает другой адрес каноническим.
Например, сайт может иметь технический вариант URL, который содержит то же содержимое и указывает canonical на основную страницу. Если Google принимает эту логику, альтернативный адрес не должен отдельно попадать в индекс.
Исправление требуется, когда текущая страница должна индексироваться самостоятельно, а canonical появился случайно. Тогда нужно проверить тег, внутренние ссылки, Sitemap и причины появления дубликата.
Если альтернативная страница действительно является дублем и canonical указан правильно, никаких действий не требуется. Google прямо описывает такое состояние как случай, который обычно не нуждается в исправлении.
Страница является копией, канонический вариант не выбран пользователем
Google может найти несколько одинаковых или почти одинаковых URL, даже если владелец сайта не указал canonical. В этом случае поисковая система выбирает основной адрес самостоятельно и исключает остальные версии.
Частые источники дублей – GET-параметры, сортировки, фильтры, HTTP/HTTPS, www/non-www, разные варианты регистра, слэш в конце или его отсутствие и технические маршруты CMS. Иногда причина находится в нескольких URL, которые фактически выводят один товар или одну категорию.
Если Google выбрал тот адрес, который и должен быть основным, срочное исправление не требуется. При этом лучше привести сигналы к одной логике: внутренние ссылки, Sitemap и canonical должны поддерживать выбранную архитектуру.
Если же в индекс попадает нежелательная версия, нужно явно консолидировать сигналы. Иначе поисковая система продолжит самостоятельно решать, какой вариант считать основным.
Страница является копией, Google выбрал другой canonical, чем пользователь
Этот статус означает конфликт: сайт указал один canonical, а Google решил считать основной другую страницу. Причина может находиться не в самом теге, а в совокупности сигналов.
Нужно сравнить содержимое дублей, внутренние ссылки, Sitemap, редиректы, hreflang и внешние ссылки. Если почти весь сайт ссылается на URL B, а на странице A стоит canonical на A, поисковая система получает противоречивую картину.
Исправлять ситуацию нужно, если выбранный Google адрес действительно неправильный для поиска. Тогда все сигналы проекта следует согласовать вокруг нужной версии.
Если после проверки оказывается, что пользовательский canonical настроен ошибочно, нет смысла заставлять Google принимать неверное решение. Лучше изменить собственную конфигурацию и привести архитектуру к фактическому основному URL.
Страница с переадресацией
Page with redirect не следует путать с Redirect error. В первом случае Google нормально обнаружил перенаправление и понимает, что исходный URL ведет на другой адрес.
Такое состояние ожидаемо после миграции, изменения slug, объединения дублей или переноса старой статьи. Сам URL с redirect обычно не должен индексироваться как отдельный документ.
Проверка требуется, если адрес с перенаправлением продолжает находиться в Sitemap или используется во внутренних ссылках. Лучше сразу ссылаться на конечную страницу и передавать Google чистую структуру без лишних переходов.
Если redirect установлен случайно и исходная страница должна существовать самостоятельно, его нужно убрать. При штатном 301 между старым и новым URL статус исправлять не требуется.
Какие предупреждения могут появляться у уже проиндексированных страниц?
Page Indexing способен показывать проблемы не только среди исключенных URL. Отдельные состояния относятся к страницам, которые Google уже добавил в индекс, но обработка прошла не так, как ожидает владелец сайта.
Такие предупреждения требуют оценки контекста. Если Google индексирует страницу, которую планировали исключить, или не может прочитать основное содержимое, одного факта присутствия URL в поиске недостаточно для вывода, что все работает правильно.
Страница проиндексирована, несмотря на блокировку robots.txt
Такое состояние возникает, когда Google знает URL по ссылкам или другим сигналам, но robots.txt запрещает загрузить содержимое. Поскольку поисковый робот не может открыть документ, он не способен прочитать размещенный внутри meta robots.
Если страница должна индексироваться, нужно разрешить сканирование, чтобы Google мог нормально получить содержимое. Если страницу, наоборот, требуется исключить из индекса, одной блокировки robots.txt недостаточно – Google должен иметь возможность увидеть noindex. В этом случае необходимо удалить такие URL из файла robots.txt, чтобы разрешить боту сканирование сайта и доступ к тегу noindex.
После изменения правил robots.txt нужно проверить конкретный URL и дождаться повторного обхода. Старый статус может сохраняться какое-то время, потому что Page Indexing не обновляется мгновенно после изменения файла.
Для технических URL решение зависит от задачи. Не стоит открывать тысячи бесполезных параметров только ради красивого отчета, но и рассчитывать на robots.txt как на надежный метод деиндексации тоже не следует.
Страница проиндексирована без контента
Если Google сообщает, что URL проиндексирован без содержимого, нужно проверить, какую страницу поисковая система фактически получила. Причина может находиться в рендеринге, нестандартном формате ответа, ошибке шаблона или расхождении между браузером пользователя и Googlebot.
Для обычной SEO-посадочной это состояние требует диагностики. Нужно посмотреть HTML, screenshot в URL Inspection, загружаемые ресурсы, JavaScript и серверный ответ.
Если основной текст появляется после скрипта, который Google не смог выполнить, необходимо проверить клиентскую логику и доступ к API или ресурсам. Для SSR-сайта стоит сравнить фактический HTML с тем, что видит браузер после гидратации.
После исправления страницу проверяют через live URL test. Только после успешного результата имеет смысл запрашивать повторную обработку.
Сводная таблица ошибок и состояний Google Search Console
Одинаковый статус может требовать разных действий в зависимости от назначения URL. Поэтому таблица ниже нужна как быстрый ориентир, а окончательное решение принимают после ручной проверки страницы.
| Статус | Нужно исправлять | Можно не исправлять |
|---|---|---|
| Server error 5xx | Важный URL стабильно недоступен Google | Разовый временный сбой уже устранен |
| Redirect error | Есть цикл, битая или слишком длинная цепочка | Обычный рабочий 301 к этому статусу не относится |
| Blocked by robots.txt | Заблокирована страница для органического поиска | Технический URL намеренно закрыт |
| URL marked noindex | noindex случайно стоит на целевой странице | Страница намеренно исключена |
| Soft 404 | Реальная страница ошибочно определяется как отсутствующая | Удаленный URL получает настоящий 404/410 |
| 401 | Публичная страница требует авторизацию по ошибке | Личный кабинет или закрытый раздел |
| 404 | Битая внутренняя ссылка, Sitemap или потерянная страница | URL удален и подходящей замены нет |
| 403 | Googlebot ошибочно заблокирован | Ресурс действительно закрытый |
| Other 4xx | Код ошибочный для целевой страницы | Ответ соответствует назначению URL |
| Crawled – currently not indexed | Важная страница должна получать поиск | URL не имеет самостоятельной поисковой задачи |
| Discovered – currently not indexed | Массово зависли важные URL | Новые страницы недавно обнаружены |
| Alternate with canonical | Canonical установлен ошибочно | Альтернативная версия действительно является дублем |
| Duplicate without user canonical | Google выбрал нежелательный URL | Выбран правильный основной адрес |
| Google chose different canonical | Google индексирует неверную версию | Пользовательский canonical сам оказался ошибочным |
| Page with redirect | Redirect случайный или URL остается в Sitemap | Нормальный 301 после переноса |
После таблицы нужно посмотреть не только название статуса, но и динамику. Резкий рост одной группы после релиза часто полезнее для диагностики, чем абсолютное количество URL.
Если сайт содержит миллион технических дублей и несколько тысяч нужных страниц, сам большой объем «Не проиндексировано» еще не доказывает проблему. Гораздо опаснее внезапное исчезновение из индекса конкретного типа коммерческих или информационных страниц.
Какие страницы нужно проверять вручную?
Search Console показывает примеры URL для каждой причины, но таблицу примеров нельзя считать полной выгрузкой всего сайта. Поэтому при массовой проблеме нужно выбирать репрезентативную выборку и проверять разные типы страниц вручную.
Приоритет получают URL, которые находятся в Sitemap, приносят органический трафик, участвуют в коммерческой структуре или должны индексироваться согласно SEO-плану. Для шаблонной ошибки достаточно найти несколько типовых примеров, чтобы понять источник, однако после исправления нужно убедиться, что изменение применилось ко всей группе.
В ручную выборку желательно включить:
- Главную и основные категории, если проблема касается всего сайта.
- Несколько товаров, услуг или статей каждого затронутого шаблона.
- Страницы из конкретного Sitemap с неожиданным статусом.
- URL, которые недавно были в индексе и затем исчезли.
- Страницы из разных языковых или региональных версий.
- Несколько адресов из разных участков списка примеров Search Console.
После выборки нужно сравнить URL между собой. Если все проблемные страницы используют один шаблон, искать ошибку отдельно в каждом документе обычно бессмысленно – причина может находиться в общей логике canonical, meta robots, SSR или серверного маршрута.
Как вручную проверить страницу из отчета Page Indexing?
Откройте конкретную причину в Page Indexing и выберите пример URL. Затем перейдите в URL Inspection, чтобы увидеть информацию последнего обхода Google. Сначала смотрят сохраненное состояние, потому что именно оно объясняет текущий статус отчета.
После этого запускают Test live URL. Текущая проверка нужна, чтобы понять, осталось ли ограничение после исправлений. Например, сохраненная версия может содержать noindex, а live-версия уже показывать, что индексирование разрешено.
Проверка должна включать HTTP-код, robots.txt, meta robots, X-Robots-Tag, canonical, Sitemap, рендеринг и конечный URL после redirects. Для JavaScript-страниц отдельно смотрят screenshot и полученный Google HTML.
Search Console не работает как real-time лог сервера. Если Google последний раз сканировал страницу до внесения правки, отчет закономерно продолжит показывать старую причину. Поэтому дата последнего сканирования должна проверяться до повторного изменения сайта.
Какие страницы при каждом статусе проверять вручную?
Для 5xx проверяют ключевые URL разных шаблонов и параллельно смотрят Crawl Stats. Если ошибки возникают в случайные моменты на разных разделах, вероятнее серверная или инфраструктурная проблема, чем ошибка конкретной страницы.
Для robots.txt и noindex приоритетны submitted pages из Sitemap. Сайт сам сообщает Google, что эти URL важны, поэтому одновременно блокировать их обычно нелогично.
При 404 проверяют адреса из внутренних ссылок и Sitemap. Случайные старые URL, которые уже нигде не используются и действительно удалены, могут спокойно оставаться 404.
Для Crawled – currently not indexed и Discovered – currently not indexed нужно взять несколько страниц каждого типа. Один URL ничего не говорит о ситуации, когда проблема затрагивает тысячи программно созданных документов.
Для canonical-статусов проверяются страницы с поисковым потенциалом, а также URL, где Google выбрал другую основную версию. Для Page with redirect в первую очередь ищут старые адреса в Sitemap и внутренних ссылках.
Как массово отправить исправленные ошибки на проверку в Google Search Console?
Массовая проверка исправления работает через Validate Fix. Она относится к конкретной причине в Search Console и не заменяет Request Indexing отдельных URL. Перед запуском нужно исправить всю известную группу, а не один показательный пример.
Порядок работы следующий:
- Откройте конкретную проблему в Page Indexing.
- Изучите примеры и определите общий источник.
- Исправьте шаблон, сервер или конфигурацию для всей группы.
- Проверьте несколько URL через URL Inspection.
- Запустите Test live URL на типовых примерах.
- Нажмите Validate Fix, когда проблема действительно устранена.
После списка не нужно повторно нажимать кнопку, пока предыдущая проверка не закончилась. Google рекомендует дождаться результата текущего validation cycle и только потом запускать следующий.
Если отчет отфильтрован по конкретному Sitemap, validation может применяться только к URL из этой выборки. Такой подход иногда удобен для приоритетного раздела, но перед запуском нужно понимать, какой именно набор страниц сейчас проверяется.
Что сделать перед массовой проверкой?
Главная ошибка – запускать Validate Fix сразу после изменения одного URL. Если статус затрагивает тысячу страниц одного шаблона, нужно убедиться, что новая логика уже работает на всем шаблоне.
Сначала берут несколько URL из разных участков выборки и проверяют текущую версию. Для redirect error смотрят полную цепочку, для noindex проверяют HTML и HTTP-заголовки, для 5xx желательно провести несколько запросов и посмотреть серверные логи.
Если проблема связана с canonical, одного live URL test недостаточно для прогнозирования решения Google. Нужно дополнительно проверить все сигналы сайта: canonical, Sitemap, внутренние ссылки и фактическое сходство страниц.
Только когда типовые URL выглядят исправленными, можно отправлять массовую проверку. Такой порядок сокращает риск, что validation остановится на первом оставшемся проблемном экземпляре.
Как Google начинает массовую проверку исправления?
После запуска Google сначала проверяет выборку страниц, на которых ранее была найдена эта проблема. Если ошибка остается на проверяемых URL, validation может завершиться неуспешно уже на раннем этапе.
Если первые экземпляры проходят проверку, Search Console продолжает работу со списком известных URL этой группы. Проверяются именно страницы с конкретной проблемой, а не весь сайт целиком.
Каждый проверяемый URL получает собственное состояние. Если ошибка исчезла, экземпляр проходит проверку. Если Google снова видит проблему, validation может перейти в Failed.
Графически процесс выглядит так:
Validate Fix → проверка примеров → Started → Looking good → проверка известных URL → Passed
При сохранении проблемы ветка меняется:
Validate Fix → проверка URL → проблема найдена → Failed → исправление → Start new validation
Проверяет ли Google весь сайт?
Нет. Search Console ставит на повторную проверку известные URL, которые относятся к выбранному типу проблемы. Google прямо описывает этот механизм: для validation в очередь попадают известные затронутые адреса, а не все страницы домена.
Если одновременно существуют 5xx, redirect error и noindex, это разные группы. Каждую причину нужно анализировать и валидировать отдельно, потому что успешное исправление одной не изменяет состояние другой.
Во время обычного обхода Google продолжает находить новые экземпляры проблемы. Они могут добавляться к существующей группе, поэтому исправление должно закрывать источник на уровне шаблона или конфигурации.
Для больших проектов это особенно важно. Исправление десяти URL вручную не решит задачу, если CMS продолжает ежедневно генерировать сотни новых адресов с той же ошибкой.
Сколько занимает массовая проверка исправлений?
Validation не выполняется мгновенно. Google указывает, что проверка обычно занимает до примерно двух недель, но в отдельных случаях может продолжаться значительно дольше. Скорость зависит от количества URL и графика повторного обхода.
Не стоит обещать разработчику или клиенту результат через конкретные два или три дня. Даже после технического исправления поисковая система должна повторно посетить нужные страницы и обновить собственные данные.
На больших проектах время может различаться между разделами. Часто сканируемые категории Google переобходит быстрее, чем глубокие малоизвестные страницы без внутренних ссылок.
Повторное нажатие Validate Fix не ускоряет уже запущенную проверку. Текущий цикл нужно довести до Passed или Failed, после чего принимать следующее решение.
Какие статусы имеет проверка исправлений?
Статус Not started означает, что для проблемы еще не запускали отдельную проверку исправления. При этом Google все равно может повторно сканировать страницы в рамках обычного обхода и обновлять число затронутых URL.
Started появляется после запуска validation. Google начал процесс и проверяет известные экземпляры проблемы. На этом этапе дополнительных действий обычно не требуется.
Looking good означает, что проверенные к текущему моменту экземпляры уже проходят validation. Это промежуточное состояние, поэтому его нельзя трактовать как окончательный результат.
Passed появляется, когда известные проверяемые экземпляры проблемы устранены или URL больше недоступны соответствующим образом. N/A может появиться, когда Google самостоятельно обнаружил исчезновение проблемы без запуска validation пользователем.
Failed означает, что во время проверки Google снова нашел проблему на части страниц. В таком случае нужно открыть детали, изучить неуспешные URL и устранить оставшийся источник ошибки.
Какие статусы получает каждый URL внутри массовой проверки?
У всей validation есть общий статус, но отдельные URL тоже имеют собственные состояния. Их нельзя путать, потому что часть страниц может уже пройти проверку, пока другие продолжают находиться в очереди.
Pending означает, что экземпляр поставлен на проверку, но Google еще не подтвердил исправление. Последнее известное состояние такого URL по-прежнему содержало проблему.
Passed означает, что Google повторно проверил экземпляр и больше не нашел конкретную ошибку. Failed говорит об обратном: после повторного обхода проблема осталась.
Состояние Other используется, когда Google не смог получить URL либо рассматриваемый объект больше отсутствует. Для процесса validation такое состояние считается эквивалентным успешно закрытому экземпляру.
Один и тот же URL может иметь Passed по одной проблеме и Pending или Failed по другой. Это нормально, потому что Search Console валидирует каждую категорию независимо.
Когда Google принимает массовое исправление?
Validation получает Passed, когда известные экземпляры конкретной проблемы больше ее не содержат. Это может произойти после исправления страницы или потому, что затронутый URL больше не существует и Google не может обнаружить прежний дефект.
Passed относится только к выбранной проблеме. Например, исправленный redirect error может исчезнуть, но конечная страница затем получить Crawled – currently not indexed. Это уже другой статус, который требует отдельного анализа.
Успешная проверка также не гарантирует позиции или даже обязательную индексацию. Она подтверждает, что конкретная причина, для которой запускался Validate Fix, больше не найдена на проверенных экземплярах.
Поэтому после Passed стоит вернуться к Page Indexing и посмотреть итоговое состояние нужных страниц. Цель проверки – не получить зеленую отметку, а привести URL к ожидаемому поведению.
Когда Google отклоняет проверку исправлений?
В интерфейсе правильнее говорить, что validation получила статус Failed. Это автоматический результат повторной проверки, а не ручное решение сотрудника Google.
Причина обычно проста: поисковая система снова обнаружила рассматриваемую проблему на одном или нескольких URL. Например, разработчик убрал noindex из HTML, но заголовок X-Robots-Tag: noindex продолжает приходить с сервера.
Для redirects частая ситуация – исправлена одна цепочка, но аналогичное правило остается на других языковых или региональных URL. Для 5xx проблема может проявляться периодически под нагрузкой, поэтому единичная успешная проверка в браузере не гарантирует стабильный серверный ответ.
Validation также может обнаружить новые экземпляры проблемы во время обычного обхода. Поэтому после Failed нужно искать общий паттерн, а не исправлять только первый URL из уведомления.
Что делать, если проверка исправления отклонена?
Откройте проблемную строку и перейдите в See details. Найдите URL со статусами Failed и Pending, после чего вручную проверьте несколько представителей каждого шаблона.
Для каждого URL нужно посмотреть текущий HTTP-код, robots, canonical, redirect и live-версию. Если проблема появляется только у Googlebot, дополнительно проверяют серверные логи, firewall, CDN и различия ответов для User-agent.
После этого определяется общий источник: шаблон страницы, правило сервера, middleware, языковая логика, SSR, CDN или генерация параметров. Исправлять нужно источник, который производит проблемные URL.
После завершения текущего цикла можно нажать Start new validation. В новый запуск попадут Pending и Failed URL, а также новые обнаруженные экземпляры проблемы. Уже прошедшие Passed и Other повторно проверяться не будут.
Нужно ли обязательно запускать Validate Fix?
Нет. Google продолжает обычное сканирование сайта независимо от того, нажал владелец Validate Fix или нет. Если поисковая система самостоятельно обнаружит, что проблема исчезла, количество затронутых URL может обновиться без отдельной validation.
Кнопка полезна, когда требуется контролируемая повторная проверка массового исправления. Search Console показывает ход процесса, сохраняет историю и сообщает, остались ли проблемные экземпляры.
Для небольшой единичной проблемы иногда достаточно исправить URL и дождаться следующего обхода. Для массового изменения шаблона validation удобнее, потому что дает отдельный процесс контроля.
Запуск проверки имеет смысл после того, как техническая работа действительно закончена. Отправлять заведомо неисправную группу только ради запуска процесса не нужно.
Как проверить сайт на ошибки Google?
Проверка сайта на ошибки Google начинается не с одного отчета. Page Indexing отвечает за индексирование, URL Inspection помогает анализировать конкретные страницы, Crawl Stats показывает поведение сканирования, а Sitemap дает представление о переданных Google URL.
Если нужно проверить сайт на ошибки Гугл после релиза, лучше идти от массовых сигналов к конкретным примерам. Сначала смотрят изменения графиков и причины в Search Console, затем выбирают несколько URL каждого затронутого типа и проверяют их вручную.
Отчет «Индексирование страниц»
Page Indexing показывает количество известных Google индексируемых и неиндексируемых страниц, а также причины, по которым URL не попали в индекс. Для большого сайта этот отчет помогает быстро увидеть массовое изменение после миграции или технического релиза.
Смотреть нужно не только на абсолютное количество URL, но и на динамику. Если после обновления резко выросли noindex, 404 или 5xx, стоит сопоставить дату роста с изменениями сайта.
Отдельно полезен фильтр по Sitemap. Он помогает сосредоточиться на тех URL, которые сам сайт заявляет как приоритетные для индексирования.
Для конкретной страницы отчет недостаточен. Google рекомендует использовать URL Inspection, если требуется точный статус одного URL.
Инструмент «Проверка URL»
URL Inspection используют для диагностики отдельного адреса. Он показывает, что Google знает о странице после последнего сканирования, и дает возможность запустить live-проверку текущей версии.
Особенно полезно сравнивать сохраненное и текущее состояние после технического исправления. Например, Page Indexing еще показывает старый noindex, а Test live URL уже подтверждает отсутствие директивы.
Через этот же интерфейс можно запросить повторное индексирование отдельной страницы. Для массовых URL такой сценарий не подходит, поэтому сотни адресов вручную отправлять не следует.
Проверка сайта на ошибки Гугл всегда должна включать несколько типовых URL, если проблема относится к шаблону. Один успешный адрес не гарантирует, что исправление применилось ко всему разделу.
Статистика сканирования
Crawl Stats помогает увидеть, как Googlebot обращается к сайту. Здесь полезно анализировать распределение ответов 2xx, 3xx, 4xx и 5xx, состояние хоста и изменение активности сканирования.
Если Page Indexing показывает массовые серверные ошибки, статистика сканирования помогает понять масштаб. Рост 5xx одновременно с падением успешных ответов часто указывает на серверную проблему, а не на содержимое отдельных страниц.
Для большого сайта дополнительно полезны логи сервера. Они показывают конкретные запросы Googlebot, время ответа и повторяющиеся технические маршруты, которые Search Console агрегирует.
Если ошибки появляются только периодически, однократное открытие страницы из браузера может ничего не показать. В таком случае история запросов гораздо информативнее.
Sitemap
Sitemap должен содержать канонические индексируемые URL. Если карта заполнена редиректами, 404, noindex и дублями, сайт одновременно сообщает Google, что адрес важен, и технически дает сигнал не индексировать его.
После изменения структуры нужно проверить, что старые страницы удалены из Sitemap, а новые конечные адреса добавлены. Для мультиязычного сайта также проверяются все языковые версии.
Sitemap помогает Google обнаруживать страницы, но не является гарантией индексирования. Даже корректно переданный URL проходит обычную обработку и может получить статус Crawled – currently not indexed.
Для большого проекта удобно создавать карты по типам контента. Тогда изменение индексации товаров, категорий и статей можно анализировать отдельно.
Robots.txt и meta robots
Robots.txt управляет доступом к сканированию, а meta robots и X-Robots-Tag могут управлять индексированием уже доступного документа. Смешивание этих механизмов часто создает противоречивую конфигурацию.
Если URL заблокирован в robots.txt, Googlebot не сможет открыть HTML и прочитать размещенный там noindex. Поэтому схема Disallow + noindex не дает надежного удаления уже известной страницы.
Для страниц, которые нужно исключить из поиска, обычно требуется дать роботу возможность прочитать соответствующую директиву. Для технических областей с огромным числом URL robots.txt может использоваться для контроля сканирования.
После любых изменений нужно проверять конкретные примеры. Одно слишком широкое правило в robots.txt способно закрыть целый раздел сайта.
Почему запрос индексирования не решает проблему?
Request Indexing сообщает Google, что страницу стоит проверить повторно. Кнопка не меняет HTTP-код, содержимое, canonical, сервер или внутренние ссылки, поэтому техническая причина остается до ее фактического исправления.
Если пользователь регулярно нажимает «Запросить индексирование», а URL продолжает оставаться вне индекса, нужно прекратить повторную отправку и перейти к диагностике. Особенно это касается Crawled – currently not indexed, где страница уже была получена Google.
Ведущий SEO-специалист — Геннадий
Когда страница не индексируется, я не начинаю с повторного нажатия кнопки „Запросить индексирование“. Сначала проверяю, получает ли Googlebot 200 OK, нет ли noindex, блокировки, неправильного canonical, дублей или цепочки редиректов и есть ли на страницу внутренние ссылки. Если технически URL чистый, уже смотрю на самостоятельную ценность страницы. Повторный запрос без устранения причины обычно ничего не меняет.
Качество и самостоятельная ценность страницы
После технической проверки нужно оценить, зачем документ существует отдельно от других URL. Если десять страниц отличаются только названием города или несколькими словами, поисковая система может не считать каждую версию необходимой для индекса.
Полезно сравнить страницу с другими документами того же шаблона. Нужно проверить, есть ли собственное содержание, отвечает ли текст конкретному интенту и не повторяет ли соседние страницы почти полностью.
Количество слов само по себе проблему не решает. Короткая страница может полноценно закрывать запрос, а длинный шаблонный текст оставаться слабым дублем.
Для массово создаваемых страниц критерий самостоятельности особенно важен. Автоматическая генерация тысяч URL без отдельной пользовательской задачи часто приводит к большому числу просканированных, но неиндексируемых документов.
Внутренняя перелинковка
Страница должна иметь понятное место в структуре сайта. Важный URL, на который не ведут внутренние ссылки, труднее воспринимать как часть основного набора документов.
Ссылки желательно ставить с тематически связанных страниц. Категория может ссылаться на подкатегории, статья – на связанные материалы, услуга – на релевантные подразделы или города.
Не нужно создавать сотни бессмысленных ссылок только ради обхода роботом. Цель внутренней перелинковки – дать пользователю и поисковой системе логичный маршрут между связанными документами.
После изменения структуры стоит проверить, не остались ли ссылки на старые redirect URL. Лучше сразу вести внутренний трафик на конечные канонические страницы.
Дубли и canonical
Дубли появляются из-за параметров, фильтров, сортировок, языковых маршрутов, технических адресов и ошибок CMS. Если одинаковое содержимое доступно по нескольким URL, Google должен определить основную версию.
Canonical помогает передать предпочтение, однако одного тега иногда недостаточно. Sitemap и внутренние ссылки тоже должны использовать выбранный канонический URL.
Если разные сигналы противоречат друг другу, Google может выбрать другой canonical. Тогда нужно привести архитектуру к единой логике, а не просто несколько раз отправлять страницу на индексацию.
При проверке дублей полезно смотреть не только код страницы, но и фактическое содержимое. Две разные URL могут технически иметь разные canonical, но практически выводить почти один документ.
JavaScript и рендеринг
Для JavaScript-сайта браузер пользователя может показывать полноценный контент, хотя исходный HTML остается почти пустым. Google умеет выполнять рендеринг, но ошибки скриптов, API, авторизации или ресурсов способны изменить итоговый документ.
Через Test live URL нужно посмотреть screenshot и обработанный HTML. Если ключевой текст, ссылки или canonical появляются неправильно, проблема находится на этапе рендеринга.
Для SSR-проектов тоже стоит проверять ответ сервера. Иногда содержимое визуально исправляется после клиентской гидратации, однако Google сначала получает ошибочный серверный HTML.
Необходимо следить, чтобы важные SEO-данные не зависели от нестабильного клиентского запроса. Чем предсказуемее базовый документ, тем проще диагностировать проблемы индексирования.
Сервер и доступ Googlebot
Даже хороший контент не будет нормально обрабатываться, если сервер периодически возвращает ошибки или блокирует робота. Поэтому диагностика должна включать HTTP-код, DNS, CDN, firewall и anti-DDoS.
Проблема особенно заметна на больших сайтах, где ручная проверка одного URL показывает 200, а серверные логи содержат регулярные 429, 502 или 503 для Googlebot.
Нужно проверить, нет ли отдельного правила по User-agent, стране, IP или скорости запросов. Агрессивная защита иногда принимает поискового робота за нежелательный трафик.
После серверного исправления полезно сравнить Crawl Stats до и после изменения. Так можно увидеть, стабилизировались ли ответы сайта для Google.
Частые ошибки при работе с индексацией
Самая распространенная ошибка – пытаться сделать индексируемыми все URL, которые отображаются в группе «Не проиндексировано». У крупного сайта могут быть тысячи корректных дублей, redirects, удаленных страниц и технических адресов.
Не менее часто встречается противоположная ситуация: целевые страницы выпадают из индекса, но команда продолжает отправлять Request Indexing вместо технической диагностики. В результате причина сохраняется неделями.
Чаще всего проблемы создают следующие действия:
- Один URL отправляют на индексирование много раз подряд без каких-либо изменений.
- Оператор site: используют как точный счетчик страниц в индексе.
- URL с redirect, 404 или noindex продолжают хранить в Sitemap.
- Внутренние ссылки после миграции ведут на старые адреса.
- Canonical противоречит Sitemap и внутренней перелинковке.
- Robots.txt используют как единственный способ удаления страницы из индекса.
- Validate Fix запускают после исправления одного URL из большой группы.
- Статус Passed принимают за гарантию индексации и будущего ранжирования.
- Не проверяют дату последнего сканирования перед повторными изменениями.
- Массовые шаблонные URL оценивают по одному случайному примеру.
После списка нужно вернуться к приоритетам. Сначала проверяются страницы, которые должны приносить органический трафик, затем массовые проблемы шаблонов, а технические исключения анализируются только в том объеме, в котором они влияют на сканирование и структуру сайта.
Чек-лист проверки индексации страницы
Перед Request Indexing страницу лучше пройти по короткому техническому чек-листу. Он помогает не отправлять Google URL, который заведомо содержит блокировку или другой конфликтующий сигнал.
Проверка включает следующие действия:
- Убедиться, что URL должен индексироваться как самостоятельная страница.
- Проверить ответ 200 OK для индексируемого документа.
- Исключить случайный noindex и X-Robots-Tag.
- Убедиться, что Googlebot не заблокирован robots.txt.
- Проверить canonical и выбранную основную версию.
- Убедиться, что нет redirect loop или лишней цепочки.
- Проверить наличие URL в правильном Sitemap.
- Найти внутренние ссылки на страницу.
- Проверить содержимое и рендеринг.
- Открыть URL Inspection и посмотреть дату последнего обхода.
- Запустить Test live URL после внесенных исправлений.
- При необходимости отправить Request Indexing.
- Для массовой ошибки после полного исправления использовать Validate Fix.
После такой проверки проще понять, где заканчивается техническая часть и начинается решение Google об индексировании. Если все условия соблюдены, а страница остается Crawled – currently not indexed, повторение тех же действий редко дает новый результат.
Проверка индексации начинается с определения роли страницы. Если URL должен находиться в поиске, нужно проверить HTTP-ответ, robots, noindex, canonical, redirects, Sitemap, внутренние ссылки, рендеринг и фактический статус в Google Search Console.
Не каждая строка в группе «Не проиндексировано» требует исправления. Корректный redirect, осознанный noindex, удаленный 404 или альтернативная canonical-страница могут быть нормальной частью технической структуры сайта.
Для одной страницы используйте URL Inspection и Request Indexing после устранения причины. Для массовой ошибки сначала исправьте весь шаблон или конфигурацию, проверьте несколько URL вручную и затем запускайте Validate Fix.
Если в Search Console накопились ошибки индексирования и непонятно, какие из них влияют на органический трафик, передайте отчет и список приоритетных страниц специалистам Seo-Gen. Мы разделим технические ошибки и нормальные исключения, определим причину по каждому типу URL и подготовим конкретный список исправлений для разработчика.


