Індексація сайту в Google: перевірка та помилки Search Console


Після публікації нової сторінки вона автоматично не з'являється в пошуку. Спочатку Google повинен виявити URL, просканувати його, обробити вміст та вирішити, чи потрібно додавати документ до індексу. Між публікацією та появою сторінки у пошуку може пройти різний час, тому сам факт відсутності URL у видачі ще не вказує на технічну помилку.
Індексація сайту в Google вимагає розбирати конкретний статус сторінки. Один URL може бути закритий через noindex, інший повертати 5xx, третій виявитись дублем, а четвертий вже перебувати в індексі, але не мати позицій за потрібним запитом. Google Search Console допомагає розділити ці ситуації та зрозуміти, на якому етапі виникла проблема.
Що таке індексація сайту в Google і як вона працює?
Індекс Google можна представити як базу документів, які пошукова система обробила та розглядає для показу у пошуку. До потрапляння туди URL проходить кілька етапів. Тому фрази «Google знає сторінку», «Google просканував сторінку» і «сторінка індексується» описують різні стани.
Типова послідовність виглядає так:
виявлення URL → crawl → отримання HTML → рендеринг сторінки → аналіз вмісту → вибір canonical → indexing → можлива участь у пошуку.
Сторінка може зупинитися практично на будь-якому етапі цього ланцюжка. Наприклад, Google може знати URL із sitemap.xml, але поки не виконати сканування сайту. В іншому випадку Googlebot вже отримав сторінку, проте пошукова система вирішила поки не додавати її в індекс.
Як Google знаходить нові сторінки?
Googlebot дізнається про URL із внутрішніх та зовнішніх посилань, XML Sitemap, вже відомих сторінок сайту та інших доступних джерел. Хороша внутрішня перелінковка допомагає пошуковому роботу знаходити нові документи та розуміти їхнє місце у структурі сайту.
Якщо нова стаття існує тільки за прямою адресою і жодна сторінка, що індексується, на неї не посилається, виявлення і повторне сканування можуть відбуватися повільніше. Такі URL часто називають orphan page. Для важливих сторінок краще створювати нормальний шлях від розділу, категорії чи іншої тематично зв'язаної сторінки.
Sitemap також передає Google список URL, але присутність сторінки у файлі не гарантує індексування. Карта повідомляє пошуковій системі, які адреси власник вважає важливими для обходу. Для регулярно оновлюваного сайту корисний коректний <lastmod>, якщо дата дійсно відображає суттєву зміну документа.
Що відбувається після виявлення URL-адреси?
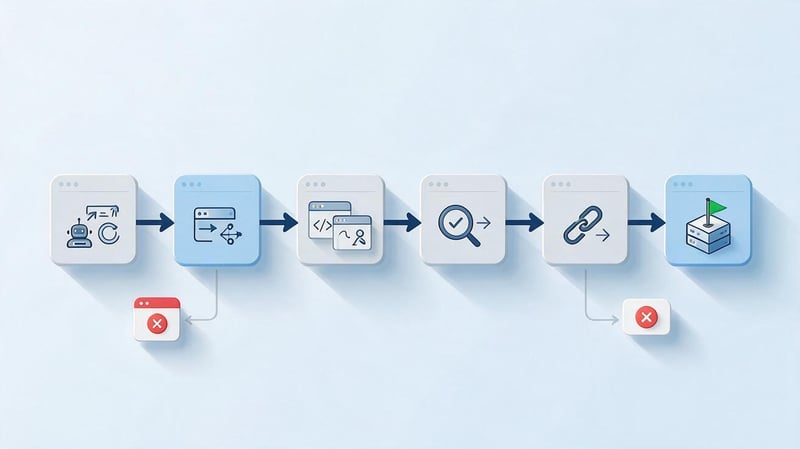
Після виявлення адреса потрапляє до системи планування обходу. Google визначає, коли URL потрібно запитати, отримує серверну відповідь та аналізує HTTP-код. Якщо доступ дозволено, пошуковий робот завантажує необхідні ресурси та обробляє вміст сторінки.
Для сторінок, де значна частина вмісту створюється через JavaScript, додатково має значення рендеринг. Якщо у вихідному HTML майже нічого немає, а після виконання скриптів основний текст не з'являється або завантажується помилково, Google може побачити сторінку інакше, ніж користувач у браузері.
Після обробки Google порівнює документ з іншими відомими версіями. На цьому етапі враховуються дублі сторінок, редиректи та сигнали canonical. Потім пошукова система вибирає канонічний URL та приймає рішення про індексування.
Чим сканування відрізняється від індексування?
Сканування означає, що Googlebot запросив URL і отримав певну відповідь від сервера. Індексування відбувається пізніше і означає, що Google додав оброблений документ у свій пошуковий індекс. Між цими діями немає автоматичного зв'язку.
Тому статус «Просканована, але поки що не проіндексована» не суперечить роботі пошукової системи. Google вже отримав URL, але поки що не включив його в індекс. Причиною може бути стан сторінки, дублювання, якість вмісту або рішення системи, точну внутрішню причину якого Search Console не вказує.
Чим індексація відрізняється від ранжування?
Якщо URL є в індексі Google, це ще не означає, що користувач побачить його за конкретним комерційним або інформаційним запитом. Після індексування починається окреме завдання – визначити релевантність документа та його місце серед інших результатів.
Тому відсутність позиції не можна автоматично трактувати як помилку індексування. Спочатку потрібно перевірити URL через URL Inspection та переконатися, що сторінка дійсно знаходиться в індексі. Якщо статус нормальний, аналіз продовжують вже на рівні семантики, контенту, внутрішніх та зовнішніх сигналів.
Відповіді на ваші запитання
Як перевірити, чи проіндексовано сайт у Google?
Для окремої сторінки використовуйте URL Inspection у Google Search Console. Інструмент показує, чи є URL в індексі Google, коли він сканувався і який canonical вибрала пошукова система.
Оператор site: підходить для швидкої орієнтовної перевірки домену, але не дає точної кількості проіндексованих сторінок. Для великого сайту загальну динаміку краще дивитись у Page Indexing.
Як надіслати сайт на індексацію Google?
Одну нову або оновлену сторінку можна надіслати через URL Inspection та кнопку Request Indexing. Перед надсиланням перевірте live-версію та переконайтеся, що Googlebot може отримати вміст.
Для великої кількості URL використовують Sitemap та внутрішню перелінковку. Google рекомендує карту сайту замість ручного надсилання багатьох сторінок.
Скільки часу займає індексація сторінки в Google?
Фіксованого терміну немає, тому що Google самостійно планує обхід та обробку URL. Одна сторінка може бути оброблена швидко, інша залишиться в очікуванні довше.
Request Indexing не дає гарантованого терміну та не гарантує попадання сторінки до індексу. Якщо очікування затягнулося, необхідно перевірити технічний статус та вміст URL.
Чому Google не індексує сторінку після запиту?
Причиною може бути noindex, robots.txt, 5xx, redirect error, дублювання, canonical або стан самої сторінки. Крім того, Google може просканувати технічно доступну URL-адресу і поки не включити її в індекс.
Тому повторне надсилання запиту без діагностики рідко вирішує проблему. Спочатку потрібно визначити поточний статус через Search Console та перевірити опубліковану версію.
Що означає «Просканована, але поки що не проіндексована»?
Googlebot вже отримав сторінку, проте Google поки не додав документ до індексу. Search Console не повідомляє єдиної точної причини такого рішення.
Для важливого URL перевіряють дублі, canonical, самостійну цінність вмісту, внутрішні посилання та рендеринг. Повторне надсилання незміненої сторінки зазвичай не є рішенням.
Що означає «Виявлено, але поки що не проіндексовано»?
Google знає адресу, але ще не виконав повноцінного сканування. Такий стан може тимчасово зустрічатись на нових сторінках і не обов'язково означає помилку.
При масовому та тривалому статусі перевіряють структуру посилань, Sitemap, сервер, велику кількість параметрів та інші джерела зайвих URL-адрес. Для важливих сторінок необхідно переконатися, що Google може нормально дістатися до них.
Як виправити помилку переадресації в Google Search Console?
Спочатку потрібно отримати весь redirect-ланцюжок від вихідної URL до кінцевої адреси. Потім прибрати цикли, некоректні URL-адреси і зайві проміжні переходи.
Після виправлення оновлюють внутрішні посилання та Sitemap, перевіряють кінцеву сторінку та запускають Test live URL. Якщо проблема була масовою, після перевірки кількох прикладів можна використати Validate Fix.
Чи потрібно щодня повторно надсилати сторінку на індексацію?
Ні, повторне надсилання незміненої URL-адреси не є способом прискорити роботу Google. Спочатку потрібно зрозуміти, чому сторінка відсутня в індексі.
Якщо URL технічно виправлено, запит вже надіслано, а Google його обробив, подальші дії залежать від поточного статусу. Для Crawled – currently not indexed щоденні запити не усувають причину.
Чи потрібно виправляти всі сторінки з розділу «Не проіндексовано»?
Ні, тому що частина URL виключається з індексу навмисно та правильно. До цієї групи належать коректні redirects, альтернативні canonical-сторінки, видалені URL-адреси і сторінки з усвідомленим noindex.
Виправляти потрібно випадки, де фактичний статус суперечить призначенню сторінки. Тому спочатку визначається роль URL, а потім приймається технічне рішення.
Як масово відправити виправлену помилку на перевірку?
Після виправлення всієї групи відкрийте конкретну проблему Page Indexing та натисніть Validate Fix. Перед запуском перевірте кілька URL-адрес через live inspection, щоб переконатися, що зміна працює на всьому шаблоні.
Google спочатку перевірить вибірку, потім поставить відомі зачеплені URL у чергу на повторну перевірку. Весь сайт автоматично не сканується.
Скільки триває Validate Fix?
Google вказує, що validation зазвичай триває до двох тижнів, хоча окремі перевірки можуть йти помітно довше. Повторно запускати процес до завершення поточного циклу не рекомендується.
Тривалість залежить від кількості сторінок та фактичного повторного обходу. Для великих розділів потрібно закладати час, щоб Googlebot знову відвідав відомі URL.
Що робити, якщо Validate Fix отримав Failed?
Відкрийте See details, знайдіть Failed та Pending URL та перевірте типові сторінки. Потім потрібно визначити спільне джерело проблеми і виправити всі екземпляри, що залишилися.
Після завершення неуспішного циклу запускають Start new validation. Google повторно перевірить Pending, Failed і нові екземпляри, а вже пройдені Passed і Other не ставитиме в чергу заново.
Як перевірити індексацію сайту в Google?
Для швидкої оцінки можна використовувати звичайний пошук, проте для діагностики конкретної сторінки краще відразу переходити до Google Search Console. Звіт Page Indexing дає загальну картину сайту, а інструмент перевірки URL показує дані за однією адресою.
Перевіряти сайт на індексацію в Google бажано в двох масштабах. Спочатку потрібно зрозуміти, чи немає масової проблеми з цілим шаблоном чи розділом. Потім вручну перевіряються важливі URL-адреси, тому що загальний графік не пояснює стан кожної конкретної посадкової сторінки.
Перевірка через оператор site:
Для орієнтовної перевірки можна ввести в Google:
site:example.com
Такий запит показує сторінки домену, які може вивести пошукова система по цьому оператору. Для окремої адреси можна спробувати запит формату:
site:example.com/category/page/
Цей спосіб зручний для швидкої перевірки, але кількість результатів не слід використовувати як точний розмір індексу. Видача оператора site: може бути неповною, а цифри можуть змінюватися без реального видалення такої кількості сторінок.
Якщо потрібно розібратися з конкретною сторінкою, переходять в Search Console. Для великих сайтів також використовують звіт про індексування сторінок, де видно динаміку індексованих та неіндексованих URL.
Як перевірити URL через Google Search Console?
Відкрийте потрібний ресурс у Google Search Console і вставте повну адресу сторінки в рядок перевірки зверху. Інструмент перевірки URL або URL Inspection покаже дані про версію, яку Google знає після останнього обходу. Для діагностики поточного стану додатково запускають перевірку опублікованої сторінки.
Порядок перевірки виглядає так:
- Виберіть потрібний ресурс Search Console та вставте повну URL-адресу.
- Дочекайтеся даних про стан сторінки в індексі Google.
- Перегляньте дату останнього сканування та тип Googlebot.
- Перевірте дозвіл на сканування та індексування.
- Порівняйте User-declared canonical і Google-selected canonical.
- За потреби запустіть Test live URL.
Після списку слід оцінити дані разом. Наприклад, стара збережена версія може показувати noindex, який розробник вже видалив. У такому випадку перевірка опублікованої сторінки покаже поточний стан, а звіт оновиться пізніше після нового обходу Google. URL Inspection призначений саме для діагностики окремих сторінок та запиту повторного індексування.
Які дані перевіряти в інструменті перевірки URL?
Насамперед дивляться статус індексування, час останнього обходу та можливість отримання сторінки. Ці дані допомагають зрозуміти, чи інформація Search Console відноситься до поточної версії сайту чи Google ще не бачив останніх змін.
Далі перевіряють джерело виявлення URL, referring page та Sitemap. Поле з Sitemap показує відомі Search Console карти, які вказують на цю адресу. Відсутність referring sitemap сама собою не означає помилку, якщо Google виявив сторінку іншим способом.
Окремої уваги вимагає canonical. Якщо власник вказав один канонічний URL, а Google вибрав інший, потрібно порівняти внутрішні посилання, Sitemap, редиректи, зміст дублів та інші сигнали. Canonical враховується Google як сигнал, а остаточний вибір основної версії пошукова система робить самостійно.
Як надіслати сайт на індексацію Google?
Спосіб залежить від кількості сторінок. Для однієї нової або суттєво оновленої сторінки підійде запит індексації в Google Search Console. Для великого сайту ручне відправлення кожної адреси не потрібне – Google рекомендує використовувати Sitemap та нормальну доступну структуру посилань.
Перед відправкою варто переконатися, що сторінка взагалі готова до індексування. Якщо URL повертає 5xx, містить noindex, закритий у robots.txt або перенаправляє на іншу адресу, повторний запит не виправить першопричину.
Як надіслати окрему сторінку на індексацію через Search Console?
Якщо потрібно зрозуміти, як надіслати сайт на індексацію в частині одного URL, послідовність досить коротка. Відкрийте URL Inspection, вставте адресу, перевірте опубліковану версію та переконайтеся, що Google може отримати сторінку.
Після успішної перевірки можна натиснути Request Indexing, тобто «Запросити індексування». Google поставить URL у чергу на повторну обробку. Це підходить для нової сторінки, нещодавно виправленої технічної URL-адреси або документа, де відбулося помітне оновлення вмісту.
Запит «надіслати сайт на індексацію Google» часто розуміють надто буквально. Для цілого проєкту немає кнопки, яка миттєво надішле всі сторінки в індекс. Google виявляє та переобходить сайт через структуру посилань, карти сайту та власну систему планування сканування.
Що відбувається після натискання «Запросити індексування»?
Після запиту Google може повторно просканувати сторінку, проте надсилання не гарантує додавання документа до індексу. Якщо URL-адреса недоступна, інструмент повідомить про проблему. При перевищенні ліміту ручних запитів додаткове відправлення також не дає способу обійти обмеження.
Повторне натискання кнопки кілька разів поспіль не робить сторінку якіснішою і не виправляє canonical, серверну відповідь або дублі. Тому запит індексування використовують після технічної перевірки, а не замість неї.
Якщо сторінка вже має статус «Просканована, але поки не проіндексована», безглуздо кожен день надсилати ту саму URL-адресу без змін. У такій ситуації корисніше перевірити вміст, перелінкування, дублі та загальну роль сторінки у структурі сайту.
Як надіслати на індексацію багато сторінок?
Для десятків, сотень або тисяч URL використовують XML Sitemap. Google прямо рекомендує карту сайту для запиту обходу кількох сторінок замість ручного надсилання кожної через URL Inspection.
У Sitemap потрібно вказувати канонічні URL-адреси, які дійсно передбачається індексувати. Туди не варто масово додавати 404, сторінки з noindex, адреси з 301 redirect та технічні дублі. Такі суперечливі сигнали ускладнюють діагностику.
Крім Sitemap, нові сторінки повинні мати внутрішні посилання. Якщо категорія, послуга або стаття є у карті, але залишається ізольованою від основної структури сайту, технічно Google може її виявити, проте архітектура проєкту все одно залишається слабкою.
Чи потрібно щоразу відправляти Sitemap заново?
Якщо файл доступний і вже відомий Google, видаляти та повторно додавати його після кожної зміни не потрібно. Google періодично звертається до карти та бачить оновлений список URL.
Заново надіслати Sitemap має сенс після істотної зміни конфігурації або якщо Search Console повідомляє, що файл не вдалося отримати. У звичайній ситуації достатньо підтримувати карту актуальною і не розміщувати туди URL-адреси, які свідомо не повинні індексуватися.
Для контролю зручно фільтрувати Page Indexing за конкретним Sitemap. Так можна окремо побачити стан саме тих сторінок, які власник сайту вважає індексованими.
Чому сторінки не індексуються в Google Search Console?
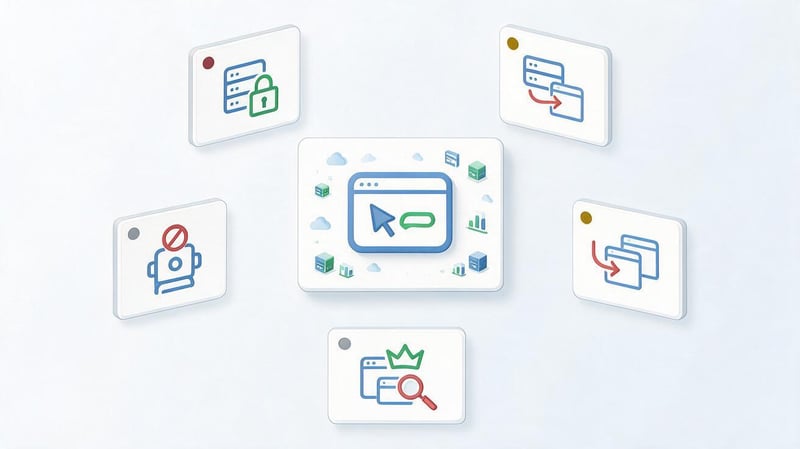
Розділ «Чому сторінки не індексуються» не можна сприймати як список поломок. Частина статусів описує нормальну поведінку: сторінка з коректним редиректом не повинна індексуватися під старим URL, а альтернативний дубль з правильним canonical може бути виключено навмисно.
Перед виправленням будь-якого статусу потрібно відповісти на одне запитання: чи ця сторінка повинна знаходитися в пошуку як самостійна URL-адреса? Якщо відповідь негативна, відсутність індексування часто відповідає задачі сайту. Google у своїй документації окремо вказує, що сторінки, що не індексуються, не завжди означають помилку.
Помилка сервера (5xx)
Статус Server error (5xx) означає, що під час запиту Google сервер відповів помилкою рівня 500 або не зміг нормально опрацювати запит. Сюди відносяться 500 Internal Server Error, 502 Bad Gateway, 503 Service Unavailable, 504 Gateway Timeout та інші серверні збої.
Причиною може бути перевантажений сервер, помилка застосунку, проблема reverse proxy, CDN, база даних, занадто довга генерація сторінки або блокування Googlebot захисною системою. Якщо 5xx з'являються на важливих категоріях, товарах, послугах або статтях, проблему потрібно вирішувати.
Тривалі серверні помилки заважають Google отримувати вміст та повторно обробляти URL-адресу. При масовому зростанні 5xx варто додатково відкрити Crawl Stats, перевірити відповіді хоста та зіставити початок помилок із релізами чи змінами інфраструктури.
Разовий 503 під час короткого технічного обслуговування не вимагає переробки всієї SEO-структури, якщо сайт працює стабільно. Але такий випадок все одно потрібно перевіряти ще раз: тимчасова помилка і регулярний збій виглядають однаково в одному окремому запиті.
Помилка переадресації
Помилка переадресації Google Search Console означає, що Google почав перехід по redirect, але не зміг коректно дістатися до очікуваного кінцевого URL. Серед офіційно перерахованих причин Google називає надто довгий ланцюжок, redirect loop, надмірно довгий URL усередині ланцюжка і некоректну або порожню адресу.
На практиці додатково перевіряють комбінації HTTP та HTTPS, www та non-www, варіанти зі слешем і без нього, мовні правила, CDN та серверні перенаправлення. Після міграції кілька незалежних правил можуть послідовно спрацьовувати на одній URL-адресі і створювати непотрібний ланцюжок.
Виправляти таку помилку потрібно, якщо адреса бере участь у внутрішній перелінковці, знаходиться в Sitemap, отримує зовнішні посилання або має вести користувача на нову сторінку. Бажано, щоб старий URL відразу перенаправлявся на кінцеву релевантну адресу.
Звичайний робочий 301 не відноситься до помилки переадресації. Якщо стара адреса коректно перенаправляє на нову, сама стара URL не повинна індексуватися. У такому випадку перевіряють лише те, що внутрішні посилання та Sitemap вже використовують кінцеву адресу.
URL заблоковано файлом robots.txt
Статус URL blocked by robots.txt з'являється, коли Googlebot не може сканувати сторінку через правила Disallow. Причина зазвичай знаходиться в загальному robots.txt, окремому правилі для певного User-agent або надто широкому шаблоні шляху.
Якщо заблоковано комерційну категорію, послугу, товар, статтю або іншу сторінку, яка має індексуватися, правило потрібно виправляти. Інакше пошуковий робот не зможе нормально отримувати вміст документа та відслідковувати його зміни.
Якщо йдеться про технічні фільтри, внутрішні службові URL або інші адреси, які дійсно не слід сканувати, виправлення не потрібне. Блокування відповідає архітектурі сайту, якщо його встановлено свідомо.
При цьому robots.txt не можна вважати надійною командою видалення вже відомого URL з індексу. Google вказує, що заблокована сторінка в окремих випадках може бути відома за іншими сигналами. Для noindex роботу спочатку потрібно дозволити завантажити сторінку та прочитати відповідну директиву. Для того, щоб просканувати сторінку і отримати tag noindex, цей URL повинен бути відсутнім у файлі robots.txt.
URL позначений як noindex
Статус URL marked noindex означає, що Google виявив директиву noindex у meta robots або HTTP-заголовку X-Robots-Tag. У такій ситуації пошукова система не повинна додавати документ до індексу.
Виправляти статус потрібно, якщо noindex випадково залишився на публічній сторінці після розробки, міграції чи зміни шаблону. Особливо небезпечними є масові випадки, коли директива з'являється на всіх товарах, категоріях або мовних версіях.
Якщо закривається кошик, внутрішній пошук, службова сторінка або інший документ, який навмисно не потрібний у видачі, noindex працює правильно. Google прямо пише, що за навмисного виключення такий статус є очікуваним.
Після видалення директиви корисно запустити Test live URL, переконатися, що поточна версія дійсно дозволяє indexing, і лише потім за необхідності використовувати Request Indexing. Перевірка старих даних без live-тесту може призвести до помилкового висновку.
Soft 404
Soft 404 виникає, коли сервер технічно повертає успішну відповідь, часто 200 OK, але вміст виглядає як відсутня сторінка. Типовий приклад – товар видалено, а шаблон повідомляє «нічого не знайдено», продовжуючи віддавати код 200.
Проблема зустрічається на порожніх категоріях, сторінках видалених об'єктів, результатах фільтрації та шаблонах із недостатнім вмістом. Google може вирішити, що така URL-адреса фактично не представляє самостійного документа.
Якщо сторінка реально існує і повинна індексуватись, потрібно перевірити вміст і те, як Google бачить її після рендерингу. Якщо об'єкта більше немає і заміни немає, серверу краще повертати справжній 404 чи 410, а не маскувати відсутність сторінки успішним кодом.
Google рекомендує перевіряти Soft 404 через live inspection та дивитися відрендерену сторінку. Спроба перенаправити всі видалені URL-адреси на головну часто погіршує ситуацію, тому що такий redirect не відповідає змісту вихідної сторінки.
Сторінка заблокована запитом авторизації (401)
Відповідь 401 Unauthorized означає, що для отримання сторінки сервер вимагає авторизації. Googlebot не входить в особисті кабінети як звичайний користувач, тому закрита URL-адреса не може оброблятися як стандартна публічна посадкова сторінка.
Якщо 401 з'являється на категорії, статті, товарі або послузі, призначених для органічного пошуку, потрібно перевіряти налаштування сервера, CMS, middleware або системи безпеки. Публічному документу потрібен доступ без авторизації.
Для особистого кабінету, CRM, закритого розділу партнерів та інших приватних даних цей статус може бути нормальним. Немає необхідності відкривати таку сторінку Google лише задля зникнення рядка зі звіту.
Критерій досить простий: якщо користувач зі звичайного пошуку повинен отримати сторінку без входу до облікового запису, відповідь 401 суперечить задачі. Якщо доступ передбачено лише після авторизації, пошукова індексація зазвичай не потрібна.
Сторінка не знайдена (404)
Статус Not found (404) означає, що сервер повідомляє Google про відсутність ресурсу. Такі URL з'являються після видалення товарів та статей, зміни структури, помилок внутрішніх посилань, старих зовнішніх посилань або створення неправильних адрес.
404 потрібно виправляти, коли сторінка має існувати, перебуває у Sitemap чи на неї ведуть внутрішні посилання. Якщо контент переїхав на новий URL, зазвичай використовують 301 redirect і одночасно оновлюють внутрішні посилання.
Коли сторінку видалено остаточно і відповідної заміни немає, коректний 404 не вважається SEO-проблемою. Google прямо вказує, що звичайні 404 для дійсно відсутніх URL не шкодять сайту самі по собі.
Не слід перенаправляти кожну видалену адресу на головну сторінку. Такий маршрут не пояснює користувачеві та пошуковій системі, де знаходиться еквівалент видаленого контенту, та здатний призвести до додаткових Soft 404.
Доступ заборонено (403)
Відповідь 403 Forbidden означає, що сервер зрозумів запит, але відмовив у доступі. Причиною можуть бути firewall, CDN, anti-DDoS, правила безпеки, фільтрація User-agent, IP-обмеження або права доступу всередині застосунку.
Якщо 403 отримують звичайні публічні сторінки, необхідно перевірити серверні логи та правила захисту. Іноді вебсайт нормально відкривається власнику з браузера, але запит Googlebot блокується окремим захисним сценарієм.
Для справді закритих ресурсів виправлення може бути не потрібно. Наприклад, внутрішній адміністративний розділ не повинен ставати доступним роботу тільки тому, що Google колись дізнався його URL.
При масових 403 корисно порівняти час появи проблеми зі змінами CDN та firewall. Якщо блокуються тисячі важливих URL-адрес, ручне надсилання на індексацію не допоможе, поки Googlebot не зможе отримувати сторінки.
URL заблоковано через іншу помилку 4xx
До цієї групи потрапляють клієнтські помилки, які не виділені Search Console в окремий статус. Це можуть бути 400, 405, 408, 410, 429 та інші відповіді рівня 4xx.
Для кожного такого URL спочатку потрібно визначити, який код повертається і чи він відповідає призначенню сторінки. Наприклад, 410 Gone може бути нормальним для остаточно видаленого документа, а 429 Too Many Requests на важливих сторінках здатний вказувати на занадто жорсткі обмеження сервера.
Виправлення потрібно, коли індексована сторінка несподівано повертає 4xx. Тоді Google не отримує звичайний документ і не може обробляти його як доступну URL-адресу.
Якщо код вибрано навмисно і відповідає реальному стану ресурсу, змінювати його заради звіту не потрібно. Мета перевірки – привести технічну відповідь у відповідність до фактичної ролі сторінки.
Просканована, але поки що не проіндексована
Статус Crawled – currently not indexed означає, що Google вже відвідав URL, але поки що не додав його до індексу. Повторно відправляти сторінку лише заради зміни цього статусу Google не рекомендує, тому що причина зазвичай лежить не у відсутності запиту на сканування.
Для важливих сторінок перевіряють самостійну цінність вмісту, збіг з іншими URL, canonical, внутрішні посилання, шаблонність та фактичний HTML після рендерингу. Thin content також може бути корисним сигналом для аналізу, хоча Search Console не повідомляє конкретний внутрішній фактор прийнятого рішення.
Якщо статус масово з'явився на нових міських посадкових, тегах, фільтрах або програмно створених сторінках, потрібно порівняти ці URL-адреси між собою. Сотні документів із мінімальними відмінностями часто вимагають перегляду самої структури, а не додаткових Request Indexing.
Виправляти статус потрібно для сторінок, які справді мають окремий пошуковий інтент та цінність. Для вторинних дублів або малоцінних технічних URL-адрес відсутність в індексі може бути очікуваною.
Виявлено, але поки не проіндексовано
Discovered – currently not indexed означає, що Google знає адресу, але ще не виконав повноцінне сканування. У такому випадку дата останнього обходу зазвичай відсутня, тому що Googlebot поки не отримав сторінки.
Причиною може бути велика кількість URL-адрес, низький пріоритет обходу, слабка внутрішня структура, повільний сервер, параметри, нескінченні фільтри або інші джерела великого URL-простору. Google також може відкладати обхід, якщо вважає, що інтенсивне сканування створить небажане навантаження.
Для нового URL короткий період такого стану не потребує термінового втручання. Якщо ж тижнями або масово залишаються важливі категорії та послуги, потрібно перевірити Sitemap, внутрішні посилання, сервер та кількість адрес, що генеруються.
Окремо варто шукати crawl traps – нескінченні комбінації параметрів, календарів, сортувань та фільтрів. Вони витрачають увагу пошукового робота на технічні URL-адреси замість пріоритетних сторінок.
Альтернативна сторінка з правильним canonical тегом
Статус Alternate page with proper canonical tag зазвичай описує нормальну ситуацію. Google розпізнав поточну URL-адресу як альтернативну версію і вважає іншу адресу канонічною.
Наприклад, сайт може мати технічний варіант URL, який містить той самий вміст і вказує canonical на основну сторінку. Якщо Google приймає цю логіку, альтернативна адреса не повинна попадати окремо в індекс.
Виправлення потрібно, коли поточна сторінка повинна індексуватися самостійно, а canonical з'явився випадково. Тоді потрібно перевірити тег, внутрішні посилання, Sitemap та причини появи дубліката.
Якщо альтернативна сторінка дійсно є дублем і canonical вказано правильно, ніяких дій не потрібно. Google прямо описує такий стан як випадок, який зазвичай не потребує виправлення.
Сторінка є копією, канонічний варіант не вибраний користувачем
Google може знайти кілька однакових або майже однакових URL, навіть якщо власник сайту не вказав canonical. У цьому випадку пошукова система вибирає основну адресу самостійно та виключає решту версій.
Часті джерела дублів – GET-параметри, сортування, фільтри, HTTP/HTTPS, www/non-www, різні варіанти регістру, слеш в кінці або його відсутність та технічні маршрути CMS. Іноді причина знаходиться в декількох URL-адресах, які фактично виводять один товар або одну категорію.
Якщо Google вибрав ту адресу, яка і має бути основною, термінове виправлення не потрібне. При цьому краще привести сигнали до однієї логіки: внутрішні посилання, Sitemap і canonical повинні підтримувати вибрану архітектуру.
Якщо ж до індексу потрапляє небажана версія, потрібно явно консолідувати сигнали. Інакше пошукова система продовжить самостійно вирішувати, який варіант вважатиме основним.
Сторінка є копією, Google вибрав інший canonical, ніж користувач
Цей статус означає конфлікт: сайт вказав один canonical, а Google вирішив вважати основною іншу сторінку. Причина може бути не в самому тезі, а в сукупності сигналів.
Потрібно порівняти вміст дублів, внутрішні посилання, Sitemap, редиректи, hreflang та зовнішні посилання. Якщо майже весь сайт посилається на URL B, а на сторінці A стоїть canonical на A, пошукова система отримує суперечливу картину.
Виправляти ситуацію потрібно, якщо вибрана Google адреса дійсно неправильна для пошуку. Тоді всі сигнали проєкту слід узгодити довкола потрібної версії.
Якщо після перевірки виявляється, що користувацький canonical налаштований помилково, немає сенсу змушувати Google приймати неправильне рішення. Краще змінити власну конфігурацію та привести архітектуру до фактичного основного URL.
Сторінка з переадресацією
Page with redirect не слід плутати з Redirect error. У першому випадку Google нормально виявив перенаправлення та розуміє, що вихідна URL веде на іншу адресу.
Такий стан очікується після міграції, зміни slug, об'єднання дублів або перенесення старої статті. Сам URL із redirect зазвичай не повинен індексуватися як окремий документ.
Перевірка потрібна, якщо адреса з перенаправленням продовжує перебувати в Sitemap або використовується у внутрішніх посиланнях. Краще відразу посилатися на кінцеву сторінку та передавати Google чисту структуру без зайвих переходів.
Якщо redirect встановлений випадково і вихідна сторінка має існувати самостійно, його потрібно видалити. При штатному 301 між старим та новим URL статус виправляти не потрібно.
Які попередження можуть з'являтися на вже проіндексованих сторінках?
Page Indexing здатний показувати проблеми не лише серед виключених URL-адрес. Окремі стани відносяться до сторінок, які Google вже додав до індексу, але обробка пройшла не так, як очікує власник сайту.
Такі попередження потребують оцінки контексту. Якщо Google індексує сторінку, яку планували виключити, або не може прочитати основний вміст, одного факту присутності URL у пошуку недостатньо для висновку, що все працює правильно.
Сторінка проіндексована, незважаючи на блокування robots.txt
Такий стан виникає, коли Google знає URL-адресу за посиланнями або іншими сигналами, але robots.txt забороняє завантажувати вміст. Оскільки пошуковий робот не може відкрити документ, він не може прочитати розміщений всередині meta robots.
Якщо сторінка повинна індексуватися, потрібно дозволити сканування, щоб Google міг нормально отримати вміст. Якщо сторінку, навпаки, потрібно виключити з індексу, одного блокування robots.txt недостатньо – Google повинен мати можливість побачити noindex. У цьому випадку необхідно видалити такі URL-адреси з файлу robots.txt, щоб дозволити боту сканування сайту і доступ до тега noindex.
Після зміни правил robots.txt потрібно перевірити конкретну URL-адресу і дочекатися повторного обходу. Старий статус може зберігатися якийсь час, тому що Page Indexing не оновлюється миттєво після зміни файлу.
Для технічних URL-адрес рішення залежить від завдання. Не варто відкривати тисячі марних параметрів тільки заради гарного звіту, але й розраховувати на robots.txt як на надійний метод деіндексації теж не слід.
Сторінка проіндексована без контенту
Якщо Google повідомляє, що URL проіндексована без вмісту, потрібно перевірити, яку сторінку пошукова система фактично отримала. Причина може бути у рендерингу, нестандартному форматі відповіді, помилці шаблону або розбіжності між браузером користувача та Googlebot.
Для звичайної SEO-посадкової цей стан потребує діагностики. Потрібно подивитися HTML, screenshot в URL Inspection, ресурси, що завантажуються, JavaScript і серверну відповідь.
Якщо основний текст з'являється після скрипту, який Google не зміг виконати, необхідно перевірити клієнтську логіку та доступ до API або ресурсів. Для SSR-сайту варто порівняти фактичний HTML із тим, що бачить браузер після гідратації.
Після виправлення сторінку перевіряють через live URL test. Тільки після успішного результату має сенс запитувати повторну обробку.
Зведена таблиця помилок та станів Google Search Console
Однаковий статус може вимагати різних дій залежно від призначення URL. Тому таблиця нижче потрібна як швидкий орієнтир, а остаточне рішення приймають після ручної перевірки сторінки.
| Статус | Потрібно виправляти | Можна не виправляти |
|---|---|---|
| Server error 5xx | Важлива URL-адреса стабільно недоступна Google | Разовий тимчасовий збій уже усунено |
| Redirect error | Є цикл, битий або занадто довгий ланцюжок | Звичайний робочий 301 до цього статусу не належить |
| Blocked by robots.txt | Заблоковано сторінку для органічного пошуку | Технічна URL навмисно закрита |
| URL marked noindex | noindex випадково стоїть на цільовій сторінці | Сторінку навмисно виключено |
| Soft 404 | Реальна сторінка помилково визначається як відсутня | Видалений URL отримує справжній 404/410 |
| 401 | Публічна сторінка вимагає авторизації помилково | Особистий кабінет або закритий розділ |
| 404 | Бите внутрішнє посилання, Sitemap або втрачена сторінка | URL видалено та відповідної заміни немає |
| 403 | Googlebot помилково заблоковано | Ресурс справді закритий |
| Інші 4xx | Код помилковий для цільової сторінки | Відповідь відповідає призначенню URL |
| Crawled – currently not indexed | Важлива сторінка має отримувати пошук | URL не має самостійного пошукового завдання |
| Discovered – currently not indexed | Масово зависли важливі URL | Нові сторінки нещодавно виявлені |
| Alternate with canonical | Canonical встановлено помилково | Альтернативна версія справді є дублем |
| Duplicate without user canonical | Google вибрав небажаний URL | Вибрано правильну основну адресу |
| Google chose different canonical | Google індексує неправильну версію | Користувальницький canonical сам виявився помилковим |
| Page with redirect | Redirect випадковий або URL залишається в Sitemap | Нормальний 301 після перенесення |
Після таблиці потрібно подивитися не лише назву статусу, а й динаміку. Різке зростання однієї групи після релізу часто корисніше для діагностики, ніж абсолютна кількість URL.
Якщо сайт містить мільйон технічних дублів і кілька тисяч потрібних сторінок, сам великий обсяг «Не проіндексовано» ще не доводить проблему. Набагато небезпечнішим є раптове зникнення з індексу конкретного типу комерційних або інформаційних сторінок.
Які сторінки потрібно перевіряти вручну?
Search Console показує приклади URL для кожної причини, але таблицю прикладів не можна вважати повним вивантаженням всього сайту. Тому при масовій проблемі потрібно вибирати репрезентативну вибірку та перевіряти різні типи сторінок вручну.
Пріоритет отримують URL, що знаходяться в Sitemap, приносять органічний трафік, беруть участь у комерційній структурі або мають індексуватися згідно з SEO-планом. Для шаблонної помилки достатньо знайти кілька типових прикладів, щоб зрозуміти джерело, проте після виправлення потрібно переконатися, що зміну застосовано до всієї групи.
У ручну вибірку бажано включити:
- Головну та основні категорії, якщо проблема стосується всього сайту.
- Декілька товарів, послуг або статей кожного зачепленого шаблону.
- Сторінки з конкретного Sitemap з несподіваним статусом.
- URL, які недавно були в індексі, а потім зникли.
- Сторінки різних мовних або регіональних версій.
- Декілька адрес з різних ділянок списку прикладів Search Console.
Після вибірки потрібно порівняти URL між собою. Якщо всі проблемні сторінки використовують один шаблон, шукати помилку окремо в кожному документі зазвичай безглуздо – причина може бути в загальній логіці canonical, meta robots, SSR або серверного маршруту.
Як вручну перевірити сторінку зі звіту Page Indexing?
Відкрийте конкретну причину в Page Indexing та виберіть приклад URL. Потім перейдіть до URL Inspection, щоб побачити інформацію останнього обходу Google. Спочатку дивляться збережений стан, тому що саме він пояснює поточний статус звіту.
Після цього запускають Test live URL. Поточна перевірка потрібна, щоб зрозуміти, чи залишилося обмеження після виправлення. Наприклад, збережена версія може містити noindex, а live-версія вже показуватиме, що індексування дозволено.
Перевірка повинна включати HTTP-код, robots.txt, meta robots, X-Robots-Tag, canonical, Sitemap, рендеринг та кінцевий URL після redirects. Для JavaScript-сторінок окремо дивляться screenshot та отриманий Google HTML.
Search Console не працює як real-time лог сервера. Якщо Google останній раз сканував сторінку до внесення правки, звіт закономірно продовжить показувати стару причину. Тому дата останнього сканування має перевірятись до повторної зміни сайту.
Які сторінки перевіряти вручну при кожному статусі?
Для 5xx перевіряють ключові URL різних шаблонів та паралельно дивляться Crawl Stats. Якщо помилки виникають у випадкові моменти на різних розділах, ймовірніша серверна або інфраструктурна проблема, ніж помилка конкретної сторінки.
Для robots.txt і noindex пріоритетні submitted pages з Sitemap. Сайт сам повідомляє Google, що ці URL важливі, тому одночасно блокувати їх зазвичай нелогічно.
При 404 перевіряють адреси з внутрішніх посилань та Sitemap. Випадкові старі URL-адреси, які вже ніде не використовуються і дійсно видалені, можуть спокійно залишатися 404.
Для Crawled – currently not indexed та Discovered – currently not indexed потрібно взяти кілька сторінок кожного типу. Один URL нічого не говорить про ситуацію, коли проблема стосується тисяч програмно створених документів.
Для canonical-статусів перевіряються сторінки з пошуковим потенціалом, а також URL, де Google вибрав іншу основну версію. Для Page with redirect спочатку шукають старі адреси в Sitemap і внутрішніх посиланнях.
Як масово відправити виправлені помилки на перевірку в Google Search Console?
Масова перевірка виправлення працює через Validate Fix. Вона стосується конкретної причини в Search Console і не замінює Request Indexing окремих URL. Перед запуском потрібно виправити всю відому групу, а не один показовий приклад.
Порядок роботи наступний:
- Відкрийте конкретну проблему в Page Indexing.
- Вивчіть приклади та визначте спільне джерело.
- Виправте шаблон, сервер або конфігурацію для всієї групи.
- Перевірте кілька URL через URL Inspection.
- Запустіть Test live URL на типових прикладах.
- Натисніть Validate Fix, коли проблема справді вирішена.
Після списку не потрібно повторно натискати кнопку, доки попередня перевірка не закінчилася. Google рекомендує дочекатися результату поточного validation cycle і потім запускати наступний.
Якщо звіт відфільтрований за конкретним Sitemap, validation може застосовуватися лише до URL з цієї вибірки. Такий підхід іноді зручний для пріоритетного розділу, але перед запуском слід розуміти, який саме набір сторінок зараз перевіряється.
Що зробити перед масовою перевіркою?
Головна помилка – запускати Validate Fix одразу після зміни однієї URL-адреси. Якщо статус зачіпає тисячу сторінок одного шаблону, переконайтеся, що нова логіка вже працює на всьому шаблоні.
Спочатку беруть кілька URL із різних ділянок вибірки та перевіряють поточну версію. Для redirect error дивляться повний ланцюжок, для noindex перевіряють HTML та HTTP-заголовки, для 5xx бажано провести кілька запитів та подивитися серверні логи.
Якщо проблема пов'язана з canonical, одного live URL test недостатньо для прогнозування рішення Google. Потрібно додатково перевірити всі сигнали сайту: canonical, Sitemap, внутрішні посилання та фактичну схожість сторінок.
Тільки коли типові URL виглядають виправленими, можна надсилати масову перевірку. Такий порядок скорочує ризик, що validation зупиниться на першому проблемному екземплярі, що залишився.
Як Google розпочинає масову перевірку виправлення?
Після запуску Google спочатку перевіряє вибірку сторінок, на яких раніше було знайдено цю проблему. Якщо помилка залишається на URL, що перевіряються, validation може завершитися неуспішно вже на ранньому етапі.
Якщо перші екземпляри проходять перевірку, Search Console продовжує роботу зі списком відомих URL цієї групи. Перевіряються саме сторінки з конкретною проблемою, а не весь сайт.
Кожен URL, що перевіряється, отримує власний стан. Якщо помилка зникла, екземпляр проходить перевірку. Якщо Google знову бачить проблему, validation може перейти до Failed.
Графічно процес виглядає так:
Validate Fix → перевірка прикладів → Started → Looking good → перевірка відомих URL → Passed
При збереженні проблеми гілка змінюється:
Validate Fix → перевірка URL → проблема знайдена → Failed → виправлення → Start new validation
Чи перевіряє Google весь сайт?
Ні. Search Console ставить на повторну перевірку відомі URL-адреси, які відносяться до вибраного типу проблеми. Google прямо описує цей механізм: для validation у чергу потрапляють відомі зачеплені адреси, а не всі сторінки домену.
Якщо одночасно існують 5xx, redirect error та noindex, це різні групи. Кожну причину потрібно аналізувати та валідувати окремо, тому що успішне виправлення однієї не змінює стан іншої.
Під час звичайного обходу Google продовжує знаходити нові екземпляри проблеми. Вони можуть додаватися до існуючої групи, тому виправлення має закривати джерело на рівні шаблону або конфігурації.
Для великих проєктів це особливо важливо. Виправлення десяти URL-адрес вручну не вирішить завдання, якщо CMS продовжує щодня генерувати сотні нових адрес з тією ж помилкою.
Скільки займає масова перевірка виправлень?
Validation не виконується миттєво. Google вказує, що перевірка зазвичай триває до двох тижнів, але в окремих випадках може тривати значно довше. Швидкість залежить від кількості URL та графіка повторного обходу.
Не варто обіцяти розробнику чи клієнту результат через конкретні два чи три дні. Навіть після технічного виправлення пошукова система має повторно відвідати потрібні сторінки та оновити власні дані.
У великих проєктах час може різнитися між розділами. Часто скановані категорії Google переобходить швидше, ніж глибокі маловідомі сторінки без внутрішніх посилань.
Повторне натискання Validate Fix не пришвидшує вже запущену перевірку. Поточний цикл слід довести до Passed або Failed, після чого приймати наступне рішення.
Які статуси має перевірка виправлень?
Статус Not started означає, що для проблеми ще не запускали окрему перевірку виправлення. При цьому Google все одно може повторно сканувати сторінки в рамках звичайного обходу та оновлювати кількість зачеплених URL-адрес.
Started з'являється після запуску validation. Google розпочав процес і перевіряє відомі екземпляри проблеми. На цьому етапі додаткові дії зазвичай не потрібні.
Looking good означає, що перевірені до поточного моменту екземпляри вже проходять validation. Це проміжний стан, тому його не можна трактувати як остаточний результат.
Passed з'являється, коли відомі перевірювані екземпляри проблеми усунуті або URL більше недоступні відповідним чином. N/A може з'явитись, коли Google самостійно виявив зникнення проблеми без запуску validation користувачем.
Failed означає, що під час перевірки Google знову знайшов проблему на частині сторінок. У такому випадку потрібно відкрити деталі, вивчити неуспішні URL і усунути джерело помилки, що залишилося.
Які статуси отримує кожна URL-адреса всередині масової перевірки?
У всій validation є загальний статус, але окремі URL-адреси теж мають власні стани. Їх не можна плутати, бо частина сторінок може вже пройти перевірку, доки інші продовжують перебувати у черзі.
Pending означає, що екземпляр поставлено на перевірку, але Google ще не підтвердив виправлення. Останній відомий стан такого URL, як і раніше, містив проблему.
Passed означає, що Google повторно перевірив екземпляр і більше не знайшов конкретну помилку. Failed говорить про протилежне: після повторного обходу проблема залишилася.
Стан Other використовується, коли Google не зміг отримати URL або об'єкт, що розглядається, більше відсутній. Для процесу validation такий стан вважається еквівалентним успішно закритому екземпляру.
Один і той же URL може мати Passed за однією проблемою і Pending або Failed за іншою. Це нормально, тому що Search Console валідує кожну категорію незалежно.
Коли Google приймає масове виправлення?
Validation отримує Passed, коли відомі екземпляри конкретної проблеми більше її не містять. Це може статися після виправлення сторінки або тому, що зачеплена URL-адреса більше не існує і Google не може виявити колишній дефект.
Passed відноситься лише до вибраної проблеми. Наприклад, виправлений redirect error може зникнути, але кінцева сторінка потім одержати Crawled – currently not indexed. Це вже інший статус, який потребує окремого аналізу.
Успішна перевірка також не гарантує позиції чи навіть обов'язкової індексації. Вона підтверджує, що конкретної причини, для якої запускався Validate Fix, більше не знайдено на перевірених екземплярах.
Тому після Passed варто повернутися до Page Indexing та подивитися підсумковий стан потрібних сторінок. Мета перевірки – не отримати зелену позначку, а привести URL до очікуваної поведінки.
Коли Google відхиляє перевірку виправлень?
В інтерфейсі правильніше говорити, що validation набула статусу Failed. Це автоматичний результат повторної перевірки, а не ручне рішення співробітника Google.
Причина зазвичай проста: пошукова система знову виявила проблему, що розглядається, на одному або декількох URL. Наприклад, розробник прибрав noindex з HTML, але заголовок X-Robots-Tag: noindex продовжує надходити з сервера.
Для redirects найчастіша ситуація – виправлено один ланцюжок, але аналогічне правило залишається на інших мовних або регіональних URL-адресах. Для 5xx проблема може виявлятися періодично під навантаженням, тому поодинока успішна перевірка у браузері не гарантує стабільну серверну відповідь.
Validation також може виявити нові екземпляри проблеми під час звичайного обходу. Тому після Failed потрібно шукати загальний патерн, а не виправляти лише перший URL із повідомлення.
Що робити, якщо перевірку виправлення відхилено?
Відкрийте проблемний рядок та перейдіть до See details. Знайдіть URL зі статусами Failed та Pending, після чого вручну перевірте кілька представників кожного шаблону.
Для кожного URL потрібно подивитися поточний HTTP-код, robots, canonical, redirect та live-версію. Якщо проблема з'являється лише у Googlebot, додатково перевіряють серверні логи, firewall, CDN та відмінності відповідей для User-agent.
Після цього визначається загальне джерело: шаблон сторінки, правило сервера, middleware, мовна логіка, SSR, CDN або генерація параметрів. Виправляти потрібно джерело, яке виробляє проблемні URL-адреси.
Після завершення поточного циклу можна натиснути Start new validation. У новий запуск потраплять Pending та Failed URL, а також нові виявлені екземпляри проблеми. Вже пройдені Passed та Other повторно перевірятися не будуть.
Чи потрібно обов'язково запускати Validate Fix?
Ні. Google продовжує звичайне сканування сайту незалежно від того, натиснув власник Validate Fix чи ні. Якщо пошукова система самостійно виявить, що проблема зникла, кількість зачеплених URL-адрес може оновитися без окремої validation.
Кнопка корисна, коли потрібна контрольована повторна перевірка масового виправлення. Search Console показує хід процесу, зберігає історію та повідомляє, чи залишилися проблемні екземпляри.
Для невеликої одиничної проблеми іноді достатньо виправити URL-адресу і дочекатися наступного обходу. Для масової зміни шаблону validation зручніше, тому що дає окремий процес контролю.
Запуск перевірки має сенс після того, як технічну роботу справді закінчено. Надсилати свідомо несправну групу тільки заради запуску процесу не потрібно.
Як перевірити сайт на помилки Google?
Перевірка сайту на помилки Google починається не з одного звіту. Page Indexing відповідає за індексування, URL Inspection допомагає аналізувати конкретні сторінки, Crawl Stats показує поведінку сканування, а Sitemap дає уявлення про надіслані Google URL.
Якщо потрібно перевірити сайт на помилки Google після релізу, краще йти від масових сигналів до конкретних прикладів. Спочатку дивляться зміни графіків та причини у Search Console, потім вибирають кілька URL кожного зачепленого типу та перевіряють їх вручну.
Звіт «Індексування сторінок»
Page Indexing показує кількість відомих Google сторінок, що індексуються і не індексуються, а також причини, з яких URL не потрапили в індекс. Для великого сайту цей звіт допомагає швидко побачити масову зміну після міграції чи технічного релізу.
Дивитись потрібно не лише на абсолютну кількість URL, а й на динаміку. Якщо після оновлення різко зросли noindex, 404 або 5xx, варто порівняти дату зростання із змінами сайту.
Окремо корисний фільтр за Sitemap. Він допомагає зосередитись на тих URL, які сам сайт заявляє як пріоритетні для індексування.
Для конкретної сторінки звіт недостатній. Google рекомендує використовувати URL Inspection, якщо потрібний точний статус однієї URL-адреси.
Інструмент «Перевірка URL»
URL Inspection використовують для діагностики окремої адреси. Він показує, що Google знає про сторінку після останнього сканування, і дозволяє запустити live-перевірку поточної версії.
Особливо корисно порівнювати збережений та поточний стан після технічного виправлення. Наприклад, Page Indexing ще показує старий noindex, а Test live URL вже підтверджує відсутність директиви.
Через цей інтерфейс можна запросити повторне індексування окремої сторінки. Для масових URL-адрес такий сценарій не підходить, тому сотні адрес вручну відправляти не слід.
Перевірка сайту на помилки Google завжди повинна включати кілька типових URL, якщо проблема стосується шаблону. Одна успішна адреса не гарантує, що виправлення застосовано до всього розділу.
Статистика сканування
Crawl Stats допомагає побачити, як Googlebot звертається до сайту. Тут корисно аналізувати розподіл відповідей 2xx, 3xx, 4xx та 5xx, стан хоста та зміну активності сканування.
Якщо Page Indexing показує масові серверні помилки, статистика сканування допомагає зрозуміти масштаб. Зростання 5xx одночасно з падінням успішних відповідей часто вказує на серверну проблему, а не на вміст окремих сторінок.
Для великого сайту додатково корисні серверні логи. Вони показують конкретні запити Googlebot, час відповіді та повторювані технічні маршрути, які Search Console агрегує.
Якщо помилки з'являються періодично, одноразове відкриття сторінки з браузера може нічого не показати. У такому разі історія запитів набагато інформативніша.
Sitemap
Sitemap повинен містити канонічні індексовані URL. Якщо карта заповнена редиректами, 404, noindex і дублями, сайт одночасно повідомляє Google, що адреса важлива, і технічно дає сигнал не індексувати її.
Після зміни структури потрібно перевірити, чи старі сторінки видалені з Sitemap, а нові кінцеві адреси додані. Для мультимовного сайту також перевіряються усі мовні версії.
Sitemap допомагає Google виявляти сторінки, але не є гарантією індексування. Навіть коректно переданий URL проходить звичайну обробку і може отримати статус Crawled – currently not indexed.
Для великого проєкту зручно створювати карти за типами контенту. Тоді зміну індексації товарів, категорій та статей можна аналізувати окремо.
Robots.txt та meta robots
Robots.txt керує доступом до сканування, а meta robots та X-Robots-Tag можуть керувати індексуванням вже доступного документа. Змішування цих механізмів часто створює суперечливу конфігурацію.
Якщо URL заблоковано в robots.txt, Googlebot не зможе відкрити HTML і прочитати розміщений там noindex. Тому схема Disallow+noindex не дає надійного видалення вже відомої сторінки.
Для сторінок, які потрібно виключити з пошуку, зазвичай потрібно дати роботу можливість прочитати відповідну директиву. Для технічних областей з великою кількістю URL robots.txt можна використовувати для контролю сканування.
Після будь-яких змін слід перевіряти конкретні приклади. Одне занадто широке правило robots.txt здатне закрити цілий розділ сайту.
Чому запит індексування не вирішує проблему?
Request Indexing повідомляє Google, що сторінку варто перевірити повторно. Кнопка не змінює HTTP-код, вміст, canonical, сервер або внутрішні посилання, тому технічна причина залишається до її фактичного виправлення.
Якщо користувач регулярно натискає «Запросити індексування», а URL продовжує залишатися поза індексом, потрібно припинити повторне надсилання та перейти до діагностики. Особливо це стосується Crawled – currently not indexed, де сторінку вже було отримано Google.
Провідний SEO-спеціаліст — Геннадій
Коли сторінка не індексується, я не починаю з повторного натискання кнопки „Запросити індексування“. Спочатку перевіряю, чи отримує Googlebot 200 OK, чи немає noindex, блокування, неправильного canonical, дублів чи ланцюжка редиректів і чи є на сторінку внутрішні посилання. Якщо технічно URL чиста, вже дивлюся на самостійну цінність сторінки. Повторний запит без усунення причин зазвичай нічого не змінює.
Якість та самостійна цінність сторінки
Після технічної перевірки слід оцінити, навіщо документ існує окремо від інших URL. Якщо десять сторінок відрізняються лише назвою міста або кількома словами, пошукова система може не вважати кожну версію необхідної для індексу.
Корисно порівняти сторінку з іншими документами того самого шаблону. Потрібно перевірити, чи є власний зміст, чи текст відповідає конкретному інтенту і чи не повторює сусідні сторінки майже повністю.
Кількість слів сама собою проблему не вирішує. Коротка сторінка може повноцінно закривати запит, а довгий шаблонний текст залишатиметься слабким дублем.
Для масово створюваних сторінок критерій самостійності особливо важливий. Автоматична генерація тисяч URL без окремого завдання користувача часто призводить до великої кількості просканованих, але неіндексованих документів.
Внутрішня перелінковка
Сторінка повинна мати зрозуміле місце у структурі сайту. Важливу URL-адресу, на яку не ведуть внутрішні посилання, важче сприймати як частину основного набору документів.
Посилання бажано ставити із тематично пов'язаних сторінок. Категорія може посилатися на підкатегорії, стаття – на пов'язані матеріали, послуга – на релевантні підрозділи чи міста.
Не потрібно створювати сотні безглуздих посилань лише заради обходу роботом. Мета внутрішньої перелінковки – дати користувачеві та пошуковій системі логічний маршрут між пов'язаними документами.
Після зміни структури варто перевірити, чи не залишилися посилання на старі URL. Краще одразу вести внутрішній трафік на кінцеві канонічні сторінки.
Дублі та canonical
Дублі з'являються через параметри, фільтри, сортування, мовні маршрути, технічні адреси та помилки CMS. Якщо однаковий вміст доступний за кількома URL-адресами, Google має визначити основну версію.
Canonical допомагає вказати бажану версію, однак одного тега іноді недостатньо. Sitemap та внутрішні посилання теж повинні використовувати вибраний канонічний URL.
Якщо різні сигнали суперечать один одному, Google може вибрати інший canonical. Тоді потрібно привести архітектуру до єдиної логіки, а не просто кілька разів надсилати сторінку на індексацію.
Під час перевірки дублів корисно дивитися не лише код сторінки, а й фактичний вміст. Дві різні URL-адреси можуть технічно мати різні canonical, але практично виводити майже один документ.
JavaScript та рендеринг
Для JavaScript-сайту браузер користувача може показувати повноцінний контент, хоча вихідний HTML залишається майже порожнім. Google вміє виконувати рендеринг, але помилки скриптів, API, авторизації чи ресурсів можуть змінити підсумковий документ.
Через Test live URL потрібно переглянути screenshot і оброблений HTML. Якщо ключовий текст, посилання або canonical з'являються неправильно, проблема знаходиться на етапі рендерингу.
Для SSR-проєктів також варто перевіряти відповідь сервера. Іноді вміст візуально виправляється після клієнтської гідратації, проте Google спочатку отримує помилковий серверний HTML.
Необхідно стежити, щоб важливі SEO дані не залежали від нестабільного клієнтського запиту. Чим передбачуваніший базовий документ, тим простіше діагностувати проблеми індексування.
Сервер та доступ Googlebot
Навіть хороший контент не буде нормально оброблятись, якщо сервер періодично повертає помилки або блокує робота. Тому діагностика повинна включати HTTP-код, DNS, CDN, firewall та anti-DDoS.
Проблема особливо помітна на великих сайтах, де ручна перевірка однієї URL-адреси показує 200, а серверні логи містять регулярні 429, 502 або 503 для Googlebot.
Потрібно перевірити, чи немає окремого правила щодо User-agent, країни, IP або швидкості запитів. Агресивний захист іноді сприймає пошукового робота за небажаний трафік.
Після серверного виправлення корисно порівняти Crawl Stats до та після зміни. Так можна побачити, чи стабілізувалися відповіді сайту для Google.
Часті помилки під час роботи з індексацією
Найпоширеніша помилка – намагатися зробити індексовані всі URL, які відображаються в групі «Не проіндексовано». У великого сайту можуть бути тисячі коректних дублів, redirects, видалених сторінок та технічних адрес.
Не менш часто зустрічається протилежна ситуація: цільові сторінки випадають із індексу, але команда продовжує надсилати Request Indexing замість технічної діагностики. У результаті причина зберігається тижнями.
Найчастіше проблеми створюють такі дії:
- Один URL відправляють на індексування багато разів поспіль без будь-яких змін.
- Оператор site: використовують як точний лічильник сторінок в індексі.
- URL з redirect, 404 або noindex продовжують зберігати в Sitemap.
- Внутрішні посилання після міграції ведуть на старі адреси.
- Canonical суперечить Sitemap і внутрішній перелінковці.
- Robots.txt використовують як єдиний спосіб видалення сторінки з індексу.
- Validate Fix запускають після виправлення одного URL із великої групи.
- Статус Passed приймають за гарантію індексації та майбутнього ранжирування.
- Не перевіряють дату останнього сканування перед повторними змінами.
- Масові шаблонні URL-адреси оцінюють за одним випадковим прикладом.
Після списку потрібно повернутись до пріоритетів. Спочатку перевіряються сторінки, які мають приносити органічний трафік, потім масові проблеми шаблонів, а технічні винятки аналізуються лише в тому обсязі, в якому вони впливають на сканування та структуру сайту.
Чек-лист перевірки індексації сторінки
Перед Request Indexing сторінку краще пройти коротким технічним чек-листом. Він допомагає не надсилати Google URL, який свідомо містить блокування або інший конфліктний сигнал.
Перевірка включає такі дії:
- Переконатися, що URL-адреса повинна бути індексована як самостійна сторінка.
- Перевірити відповідь 200 OK для документа, що індексується.
- Виключити випадковий noindex і X-Robots-Tag.
- Переконатися, що Googlebot не заблоковано robots.txt.
- Перевірити canonical і обрану основну версію.
- Переконатись, що немає redirect loop або зайвого ланцюжка.
- Перевірити наявність URL у правильному Sitemap.
- Знайти внутрішні посилання на сторінку.
- Перевірити вміст та рендеринг.
- Відкрити URL Inspection та переглянути дату останнього обходу.
- Запустити Test live URL після внесених виправлень.
- При необхідності надіслати Request Indexing.
- Для масової помилки після повного виправлення використати Validate Fix.
Після такої перевірки простіше зрозуміти, де закінчується технічна частина та починається рішення Google про індексування. Якщо всі умови дотримані, а сторінка залишається Crawled – currently not indexed, повторення тих самих дій рідко дає новий результат.
Перевірка індексації починається з визначення ролі сторінки. Якщо URL має знаходитися в пошуку, потрібно перевірити HTTP-відповідь, robots, noindex, canonical, redirects, Sitemap, внутрішні посилання, рендеринг та фактичний статус у Google Search Console.
Не кожен рядок групи «Не проіндексовано» вимагає виправлення. Коректний redirect, усвідомлений noindex, видалений 404 або альтернативна canonical-сторінка можуть бути нормальною частиною технічної структури сайту.
Для однієї сторінки використовуйте URL Inspection та Request Indexing після усунення причини. Для масової помилки спочатку виправте весь шаблон або конфігурацію, перевірте кілька URL вручну, а потім запускайте Validate Fix.
Якщо в Search Console накопичилися помилки індексування та незрозуміло, які з них впливають на органічний трафік, передайте звіт та список пріоритетних сторінок фахівцям Seo-Gen. Ми розділимо технічні помилки та нормальні винятки, визначимо причину для кожного типу URL і підготуємо конкретний список виправлень для розробника.


