SEO-оптимизация URL и иерархия сайта


Адрес страницы кажется небольшой технической деталью, пока на сайте не появляется несколько сотен категорий, услуг, товаров, статей и фильтров. Если URL создавались без общей системы, постепенно возникают дубли, длинные цепочки папок, разные варианты регистра, лишние параметры и страницы, до которых поисковому роботу приходится добираться через несколько переходов.
SEO-оптимизация URL начинается с архитектуры сайта. Сначала определяют, какие разделы нужны, как они связаны между собой и какие страницы должны получать органический трафик. После этого выбирают единый формат адресов, правила для slug, параметров, языковых версий, canonical и редиректов. Такой порядок снижает риск технических дублей и упрощает дальнейшее развитие сайта.
Что такое SEO-иерархия URL и зачем она нужна?
SEO-иерархия показывает, как адреса страниц соотносятся с логической структурой сайта. Например, у интернет-магазина могут быть главная страница, каталог, категория ноутбуков и отдельная карточка модели. Адреса можно оформить как последовательную цепочку каталогов, однако сама структура сайта определяется шире: меню, хлебными крошками, внутренними ссылками, страницами категорий и фактической глубиной переходов.
Для поискового робота имеет значение, какие страницы связаны между собой и насколько легко до них добраться. Поэтому длинный адрес с несколькими папками сам по себе не делает страницу глубокой, а короткий URL не гарантирует хорошую доступность. Страница может находиться по адресу /product-1/, но быть спрятана на четвёртом уровне навигации.
Из каких частей состоит URL?
Возьмём адрес https://example.com/catalog/notebooks/gaming/?sort=price#models. В нём можно выделить протокол https, домен example.com, путь /catalog/notebooks/gaming/, GET-параметр sort=price и fragment #models. Последний смысловой элемент пути часто называют slug. В этом примере таким элементом будет gaming.
Каждая часть выполняет отдельную функцию. Домен определяет сайт, путь указывает на конкретный документ, параметры могут менять сортировку, фильтр или другое состояние страницы. Fragment ведёт к определённому месту внутри документа и обычно не создаёт новую индексируемую страницу. При проектировании адресов нужно понимать назначение каждого элемента и не добавлять технические сегменты без причины.
Чем структура URL отличается от структуры сайта?
Структура URL описывает формат адресов, а архитектура сайта показывает отношения между страницами. Эти понятия связаны, но не совпадают. Адрес /catalog/notebooks/gaming/model-x/ выглядит как четыре последовательных уровня, хотя карточка товара может быть доступна из главного меню через категорию и один дополнительный переход.
Возможна и обратная ситуация. Страница /model-x/ имеет короткий URL, но ссылки на неё находятся только внутри нескольких вложенных фильтров. Тогда URL depth остаётся минимальным, а click depth увеличивается. При SEO-аудите оба показателя рассматривают отдельно, потому что сокращение количества папок в адресе не решает проблему плохой внутренней навигации.
Что такое семантический URL?
Семантический URL описывает содержание страницы понятными словами. Такой адрес легче прочитать пользователю, вебмастеру и поисковому роботу. Сравните /product?id=17358 и /notebooks/macbook-air/. Второй вариант сразу показывает тему страницы, тогда как первый содержит только технический идентификатор.
SEO-friendly URL обычно создают в нижнем регистре, разделяют слова дефисами и убирают ненужные служебные элементы. При этом семантический URL не превращают в строку из ключевых слов. Адрес должен оставаться стабильным и понятным после обновления текста, изменения мета-тегов или расширения семантического ядра.
Ответы на ваши вопросы
Какой URL считается SEO-friendly?
SEO-friendly URL понятно описывает содержание страницы и следует единому стандарту сайта. Обычно он использует нижний регистр, дефисы между словами и стабильный slug без ненужных идентификаторов. Такой адрес проще проверить вручную, использовать во внутренних ссылках и поддерживать после обновлений CMS.
При этом качество URL нельзя оценивать отдельно от страницы. Даже аккуратный адрес не исправит дубли, неправильный canonical или отсутствие внутренних ссылок. Поэтому техническая проверка должна охватывать весь набор сигналов, связанных с индексированием документа.
Влияет ли уровень вложенности страницы на SEO?
Глубина влияет на то, насколько легко поисковый робот и пользователь находят страницу внутри сайта. Если важный документ доступен только через длинную цепочку переходов, он получает меньше внутренних связей и может обходиться реже. Поэтому уровень вложенности страницы полезно контролировать при проектировании архитектуры.
Количество папок в URL не равно глубине клика. Страница с длинным адресом может быть доступна прямо из главного меню, а короткий URL может находиться далеко внутри каталога. При аудите нужно проверять click depth и внутренние ссылки, а не считать только слэши.
Нужно ли добавлять категорию в URL товара?
Обязательного требования нет. Категория в пути помогает визуально показать структуру, но создаёт дополнительные сложности, если товар относится к нескольким разделам или со временем переносится между ними. В таких проектах стабильный независимый адрес товара может быть удобнее.
Если категория включена в URL, следует определить одну основную версию страницы. Нельзя создавать отдельный адрес одного товара для каждой категории без понятной каноникализации. Перед выбором модели нужно учитывать устройство каталога и дальнейшее развитие ассортимента.
Можно ли использовать кириллицу в URL?
Кириллические URL могут индексироваться, поэтому запрета на такой формат нет. Выбор зависит от технической платформы, языка сайта и уже существующей структуры. Для нового проекта важно заранее определить единое правило и применять его во всех шаблонах.
Если действующий сайт использует транслитерацию и получает органический трафик, массовая замена адресов на кириллицу обычно требует отдельного обоснования. Любое изменение индексируемого URL связано с редиректами, обновлением внутренних ссылок и повторным обходом страниц.
Нужно ли менять старые URL на более короткие?
Само сокращение адреса редко является достаточной причиной для миграции. Если старый URL корректно работает, индексируется и не мешает развитию структуры, его можно оставить. Чем дольше страница существует, тем больше ссылок и технических связей может быть привязано к текущему адресу.
Менять URL стоит при системной проблеме: дублях, неправильной языковой архитектуре, неконтролируемых параметрах или переходе на новую структуру. В этом случае заранее готовят карту редиректов и обновляют все внутренние сигналы.
Какой уровень вложенности считается оптимальным?
Фиксированного числа для всех сайтов нет. Для небольшого корпоративного проекта большинство приоритетных страниц обычно находится близко к главной, тогда как крупный каталог естественно имеет больше уровней. Оценивать следует удобство навигации и количество переходов до важных документов.
Если коммерческая страница доступна через меню, категории и релевантные внутренние ссылки, дополнительный сегмент URL не создаёт автоматическую SEO-проблему. Гораздо хуже ситуация, когда документ формально существует, но найти его можно только через внутренний поиск.
Что лучше использовать в URL – дефис или нижнее подчёркивание?
Для новых адресов лучше выбрать дефис и придерживаться этого стандарта во всех шаблонах. Такой вариант широко используется для разделения слов и хорошо читается человеком. Смешивать разные способы внутри одной структуры не стоит, потому что это усложняет контроль URL.
На существующем сайте старые адреса с подчёркиваниями не обязательно менять массово. Если они работают и индексируются, потенциальная польза от косметической миграции может быть меньше технических затрат и риска ошибок в редиректах.
Нужно ли закрывать URL с GET-параметрами от индексации?
Решение зависит от назначения параметра. Сортировка, UTM-метки и многие технические варианты обычно не требуют отдельной индексируемой страницы. Коммерчески полезный фильтр с поисковым спросом, уникальным содержанием и стабильным URL может использоваться как самостоятельная посадочная страница.
Поэтому общее правило «закрыть все параметры» слишком грубое. Сначала нужно классифицировать типы URL, определить канонические версии и проверить, какие комбинации действительно имеют ценность для поиска.
Как спроектировать иерархическую структуру сайта?
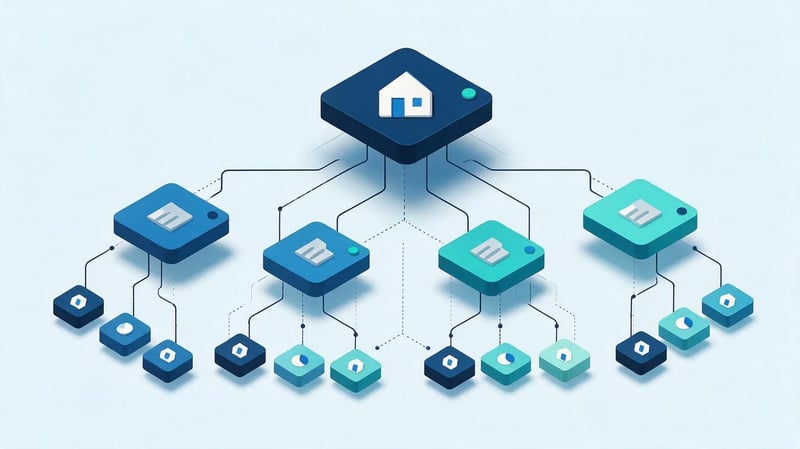
Иерархическая структура сайта строится от общих разделов к более узким страницам. Для интернет-магазина это может быть путь от каталога к категории и товару, для сайта услуг – от направления к отдельной услуге, для блога – от основного раздела к тематической рубрике и статье. Такая схема помогает заранее определить отношения между документами.
До разработки URL полезно составить дерево сайта. В нём фиксируют будущие разделы, родительские страницы, дочерние страницы, целевые запросы и предполагаемый уровень вложенности. После этого разработчик получает понятную архитектуру, а SEO-специалист может проверить, нет ли лишних уровней, пересекающихся страниц и разделов без поискового спроса.
Пример простой схемы:
Главная
├── Услуги
│   ├── SEO
│   │   ├── SEO-аудит
│   │   └── SEO-консалтинг
│   └── PPC
├── Инструменты
│   ├── Проверка URL
│   └── Генератор Sitemap
└── Блог
    ├── SEO
    └── PPC
Иерархическая структура работ по созданию сайта
Иерархическая структура работ по созданию сайта начинается со сбора семантики и определения поискового интента. Запросы группируют по смыслу, после чего становится понятно, где нужна отдельная категория, услуга, статья, товарная подборка или информационная страница. Затем кластеры распределяют по будущему дереву сайта.
Следующий этап – определение родительских и дочерних документов. После этого проектируют меню, хлебные крошки и внутреннюю перелинковку. URL формируют уже на готовой логической основе. В финале настраивают canonical, hreflang, sitemap.xml и правила индексации. Перед запуском сайт проходит полный краулинг, чтобы обнаружить 404, редиректы, дубли и страницы без внутренних ссылок.
Какие страницы относятся к первому уровню?
К первому уровню обычно относят основные разделы, которые открываются непосредственно из главной страницы или главного меню. Для коммерческого сайта такими разделами могут быть услуги, каталог, цены, проекты и блог. Для интернет-магазина первый уровень часто представлен крупными товарными направлениями или общей страницей каталога.
Количество разделов определяется содержанием сайта и спросом, а не желанием добавить больше ключевых слов в URL. Если отдельная папка не соответствует реальному разделу и не помогает навигации, создавать её ради адреса не нужно. Каждый дополнительный уровень должен иметь понятное назначение внутри структуры.
Главная страница
Главная находится в корне домена и условно считается нулевым уровнем. Через неё пользователь получает доступ к основным направлениям сайта, а внутренние ссылки распределяют внимание между наиболее важными разделами. От главной обычно начинается расчёт click depth, хотя часть страниц может быть доступна через другие элементы навигации.
В URL главной страницы не добавляют дополнительные каталоги. Основной адрес должен соответствовать выбранной версии домена, протокола и trailing slash. Все альтернативные варианты, например HTTP, другой поддомен или неправильная версия со слэшем, должны приводиться к единому каноническому адресу через редиректы.
Основные разделы
Разделы первого уровня удобно оформлять короткими и устойчивыми адресами: /services/, /catalog/, /blog/, /tools/. Название папки должно соответствовать содержанию раздела и сохранять смысл даже после расширения сайта. Слишком узкий slug иногда приходится менять при добавлении новых направлений, поэтому структуру лучше продумывать заранее.
Если раздел существует только как техническая прослойка и не содержит полезной страницы, следует проверить, нужен ли он пользователю и поисковой системе. В некоторых проектах достаточно прямых адресов услуг, а в других полноценная страница категории помогает навигации, перелинковке и работе с отдельным поисковым кластером.
Какие страницы относятся ко второму и третьему уровню?
На втором уровне обычно размещают подразделы, категории и отдельные направления услуг. Третий уровень используют для более узких сущностей, если такая детализация соответствует структуре проекта. Например, путь /services/seo/audit/ показывает направление SEO и отдельную услугу аудита, а /catalog/notebooks/gaming/ – категорию и её подкатегорию.
Дополнительный сегмент должен передавать реальную связь между страницами. Если папка существует только ради более длинного URL, она усложняет миграции и поддержку. Для каждой новой ступени полезно проверить поисковый спрос, наличие собственного контента, место в меню и внутренние ссылки на дочерние документы.
Как определить уровень вложенности страницы?
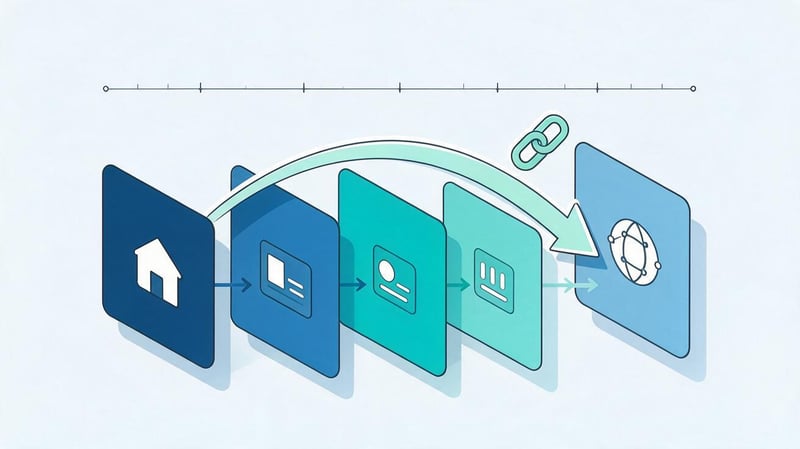
Уровень вложенности страницы часто ошибочно определяют по количеству слэшей в адресе. Такой подсчёт показывает структуру пути, однако он ничего не говорит о том, сколько переходов потребуется пользователю или Googlebot. Для SEO важнее рассматривать URL depth и глубину клика одновременно.
Уровень вложенности страницы оценивают по тому, как документ встроен в общую архитектуру. Если коммерческая страница находится далеко от главных разделов, не связана с категориями и получает одну внутреннюю ссылку, короткий URL ситуацию не исправит. Задача заключается в том, чтобы важные документы находились в понятной навигационной цепочке.
URL depth и click depth – в чем разница?
URL depth показывает количество смысловых сегментов пути. Адрес /catalog/notebooks/gaming/ глубже адреса /notebooks/, если смотреть только на строку URL. Click depth отвечает на другой вопрос: сколько переходов требуется от главной или другого крупного хаба до целевой страницы.
Представим товар с адресом /product-x/. Если ссылка на него находится только внутри категории, подкатегории и ещё одного фильтра, поисковому роботу понадобится несколько переходов. Одновременно статья с адресом /blog/seo/url-structure/ может открываться напрямую из блока новых материалов на главной. Поэтому глубина страницы и длина пути рассматриваются раздельно.
Сколько уровней вложенности допустимо?
Универсального ограничения по количеству уровней не существует. Правило «не больше трёх слэшей» слишком грубое для больших магазинов, маркетплейсов, баз знаний и многоязычных сайтов. Иногда длинный путь точно отражает архитектуру и не создаёт технических проблем.
Оценивать нужно доступность важных страниц, отсутствие бесконечных цепочек и понятность структуры. Если коммерческий документ можно найти только после пяти последовательных переходов, стоит пересмотреть внутренние связи. Если длинный URL при этом доступен из меню, категории и связанных страниц, одна только длина адреса не является причиной для миграции.
Как уменьшить глубину важных страниц?
Сначала определяют страницы, которые должны получать больше внутреннего веса и быстрее обнаруживаться поисковым роботом. Обычно это основные услуги, категории, приоритетные товарные подборки и статьи, которые поддерживают коммерческие страницы. Затем проверяют, сколько внутренних переходов требуется для доступа к ним.
Снизить click depth помогают ссылки из главного меню, хабов, категорий, хлебных крошек и тематических блоков. Внутренняя перелинковка должна быть осмысленной: ссылки ставят там, где пользователь действительно может продолжить путь. Простое добавление десятков ссылок в футер создаёт шум и не заменяет нормальную информационную архитектуру.
Как построить семантический URL?
SEO-оптимизация URL требует единого набора правил для всего проекта. Разработчик должен заранее знать, какой регистр использовать, как разделять слова, что делать с категориями, как оформлять языковые версии и допускаются ли параметры. Тогда новые страницы создаются по общей схеме, а не получают случайные адреса в зависимости от конкретного шаблона.
Хороший адрес сохраняет смысл без лишних деталей. Он не зависит от даты публикации, рекламной кампании или временного названия акции, если эти элементы не нужны содержанию страницы. Стабильность особенно важна для документов, которые планируется продвигать несколько лет и на которые постепенно накапливаются внешние и внутренние ссылки.
Нужно ли использовать ключевые слова в URL?
Ключевое слово можно использовать, когда оно естественно описывает содержание. Для страницы SEO-аудита адрес /seo-audit/ понятен и без дополнительных элементов. Добавлять несколько вариантов одного запроса вроде /seo-audit-proverka-saita-seo-analiz/ не нужно, потому что такой slug хуже читается и сложнее поддерживается.
Фраза в адресе должна соответствовать основной теме страницы, а расширенная семантика раскрывается в Title, H1, тексте и подзаголовках. SEO-оптимизация URL не требует переносить в slug весь кластер запросов. Если тема страницы меняется только частично, стабильный адрес часто выгоднее очередного переименования.
Какой длины должен быть URL?
Фиксированного SEO-лимита в 70, 75 или 100 символов придерживаться не нужно. Короткий адрес удобнее читать, копировать, проверять в отчётах и использовать в технических правилах, поэтому лишние элементы стоит убирать. Однако сокращать понятный путь ценой потери логики структуры тоже не требуется.
При аудите длинного URL нужно смотреть, почему он получился таким. Если длину создают повторяющиеся категории, идентификаторы, даты и служебные параметры, структуру стоит упростить. Если путь отражает реальную архитектуру большого сайта, сам размер строки ещё не говорит о технической ошибке.
Дефис или нижнее подчёркивание?
Для разделения слов обычно используют дефис. Адрес /seo-url-structure/ читается привычнее, чем /seo_url_structure/, и соответствует распространённому формату человекопонятных URL. Главное правило – выбрать один стандарт и не создавать разные варианты для новых разделов.
Если старый сайт годами работает с подчёркиваниями и страницы получают органический трафик, массовая замена только ради дефисов редко оправдана. Такая миграция потребует 301-редиректов, обновления внутренних ссылок, sitemap и технического контроля. Изменения должны давать практическую пользу, а не косметический эффект.
Использовать верхний или нижний регистр?
Безопаснее создавать URL в нижнем регистре. На некоторых серверах /SEO/ и /seo/ могут обрабатываться как разные адреса, из-за чего возникают дубли или ошибки при ручной постановке ссылок. Единый нижний регистр упрощает работу разработчиков и снижает количество случайных вариантов.
Если система принимает адрес с заглавными буквами, его следует приводить к основной версии. Такое правило желательно реализовать на уровне CMS или сервера, чтобы редактору не приходилось контролировать регистр вручную. Внутренние ссылки, canonical и sitemap должны использовать один и тот же конечный URL.
Кириллица, латиница или транслитерация?
Поисковые системы способны работать с кириллическими адресами, поэтому сама кириллица не является ошибкой. Для проекта важнее единый принцип. Одни сайты используют латиницу, другие – транслитерацию, третьи создают локализованные URL для каждого языка. Выбор зависит от CMS, текущей структуры и требований к мультиязычности.
Смешивать несколько подходов внутри одной группы страниц нежелательно. Если украинская версия использует /uk/poshukova-optymizatsiya/, а русская /ru/seo-optimizaciya/, это должно быть осознанным правилом. При изменении языковой модели проверяют hreflang, canonical и все внутренние ссылки между версиями.
Как построить иерархию онлайн?
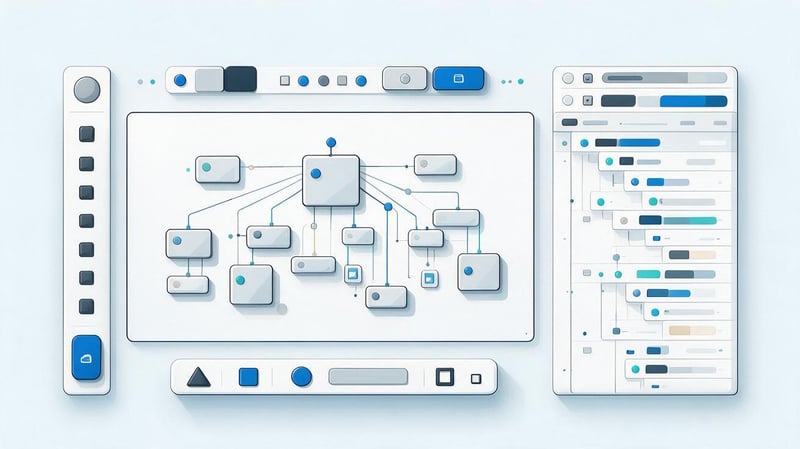
До разработки дерево сайта удобно вынести в отдельную схему. Так SEO-специалист, разработчик, дизайнер и контент-менеджер видят одинаковую структуру и могут обсуждать конкретные страницы. Если нужно построить иерархию онлайн, достаточно инструмента, где можно отобразить родительские и дочерние связи и добавить данные по каждому URL.
Для небольшого проекта подойдёт таблица или mind map. Большому интернет-магазину удобнее использовать таблицу с фильтрами, типами страниц, статусами индексации и связями между категориями. Формат вторичен: схема должна помогать контролировать архитектуру и не терять страницы при разработке.
Какие данные нужно внести в схему?
Для каждой страницы фиксируют название, тип документа, родительский раздел, предполагаемый URL и основной поисковый кластер. Полезно сразу добавить уровень вложенности, статус index/noindex, канонический адрес, язык и связь с другими версиями страницы. Такая таблица помогает увидеть технические конфликты ещё до верстки.
Если нужно создать иерархию онлайн для действующего сайта, в схему также добавляют текущий URL, новый URL и тип действия: оставить, перенести через 301, объединить или удалить. Для миграции отдельное поле с картой редиректов значительно снижает риск потерять старые адреса и внешние ссылки.
Где можно создать иерархию онлайн?
Для простой схемы подходят сервисы mind map и онлайн-диаграмм. В них удобно показывать ветвление разделов и обсуждать будущую навигацию с командой. Google Sheets или другая таблица лучше подходит для крупных проектов, где нужно сортировать тысячи URL, добавлять семантику, canonical и статусы внедрения.
Существуют также sitemap planners и визуализации из краулеров, которые помогают сделать иерархию онлайн на основе уже существующего сайта. Для SEO-аудита полезен Screaming Frog или похожий crawler: он показывает внутренние ссылки, уровни обхода, коды ответа и orphan pages при подключении дополнительных источников URL.
Как проверить готовую структуру?
Сначала нужно убедиться, что каждая индексируемая страница имеет понятное место в дереве. Если документ не относится ни к одному разделу и не получает внутренних ссылок, его роль следует пересмотреть. Отдельно проверяют страницы, созданные под одинаковый интент: они могут конкурировать друг с другом и усложнять архитектуру.
После этого смотрят на технические сигналы. У страницы должен быть корректный статус ответа, правильный canonical, место в sitemap при необходимости и рабочие внутренние ссылки. Полезно выполнить crawl будущей структуры на тестовом окружении перед релизом, чтобы найти ошибки раньше, чем их увидит Googlebot.
Как настроить URL для разных типов страниц?
Одинаковое правило нельзя механически применять к услугам, статьям, товарам и фильтрам. У каждого типа страниц своя роль и жизненный цикл. Статья может находиться в тематическом разделе блога, товар – сохранять независимый адрес после переноса между категориями, а региональная страница – содержать географический сегмент.
Перед созданием шаблонов нужно описать правила для каждого типа. В CMS эти правила лучше закрепить системно, чтобы редактор заполнял slug, а структура формировалась предсказуемо. Это уменьшает количество ручных ошибок и помогает сохранить единообразие после обновления шаблонов.
URL для услуг
Для услуг обычно выбирают короткие адреса, которые отражают направление и конкретную услугу. Например, /services/seo/ может быть разделом, а /services/seo/audit/ – отдельной посадочной страницей. Если общий раздел услуг не нужен как индексируемый документ, архитектура может быть более плоской.
Не стоит добавлять в URL рекламные определения вроде best, cheap или несколько географических маркеров без реальной причины. Семантический URL должен оставаться понятным после изменения оффера и текста. Коммерческие уточнения лучше раскрывать в контенте, мета-тегах и отдельных посадочных страницах.
URL для блога
Для блога подходят две распространённые модели: /blog/article-name/ и /blog/category/article-name/. Первая проще и стабильнее при переносе материала между рубриками. Вторая визуально показывает тематическую принадлежность и может быть удобна в крупных редакционных проектах.
Выбранную модель желательно применять ко всем новым публикациям. Если существующий блог уже использует плоскую структуру, переход к вложенной схеме только ради слова категории в URL обычно не нужен. Тематическую связь статьи можно показать через хлебные крошки, рубрики и внутренние ссылки.
URL категорий и товаров интернет-магазина
Категории удобно организовывать иерархически: /catalog/notebooks/, /catalog/notebooks/gaming/. Для товара возможен адрес внутри категории или отдельный стабильный путь, например /product/macbook-air/. Оба варианта применимы, если структура сайта и canonical настроены последовательно.
Независимый товарный URL удобен, когда товар может одновременно находиться в нескольких категориях. В таком случае не приходится создавать разные адреса одного товара или менять URL после переноса между разделами. Если категория включена в путь, CMS должна гарантировать одну основную версию документа.
URL региональных страниц
Региональные посадочные страницы создают, когда у бизнеса есть реальный локальный интент и отдельная информация для конкретного города или региона. Адрес может выглядеть как /seo/kyiv/ или /kyiv/seo/. Выбор зависит от общей архитектуры и того, что является основным уровнем – услуга или география.
Не следует генерировать десятки одинаковых городских страниц только ради замены названия населённого пункта. Каждая индексируемая версия должна иметь собственную ценность: условия, контакты, зону обслуживания, локальные кейсы или другой релевантный контент. URL отражает структуру, но не заменяет содержание.
URL мультиязычного сайта
Для языковых версий удобно использовать отдельные каталоги: /uk/, /ru/, /en/. Такая схема ясно разделяет документы и позволяет связать их через hreflang. Каждая версия страницы получает собственный URL, Title, Description, H1 и локализованный контент.
Canonical обычно указывает на текущую языковую страницу, если она является самостоятельной индексируемой версией. Hreflang связывает эквиваленты между языками. Если slug локализован, нужно следить, чтобы все ссылки использовали актуальные адреса и не создавали промежуточные редиректы между языковыми версиями.
Как работать с GET-параметрами, фильтрами и сортировкой?
GET-параметры встречаются в интернет-магазинах, поиске, фильтрах, аналитике и интерфейсах сортировки. Их наличие само по себе не означает SEO-проблему. Ошибки появляются, когда каждый параметр создаёт отдельный индексируемый URL с тем же содержанием или генерирует практически бесконечное количество комбинаций.
Для каждого типа параметров нужно определить правило. Одни адреса могут участвовать в поисковом продвижении, другие должны оставаться техническими. Отдельно проверяют пагинацию, сортировки, фильтры по характеристикам, UTM-метки и параметры внутреннего поиска.
Когда GET-параметры нормальны?
Параметры полезны, когда они управляют состоянием интерфейса или передают данные приложению. Например, ?sort=price может менять порядок товаров, а ?page=2 открывать следующую часть списка. Такие URL могут существовать технически, если их обработка не создаёт хаоса в индексации.
Проблема возникает при отсутствии общего правила. Если один и тот же набор товаров доступен через десятки вариантов сортировки, поисковая система получает несколько адресов похожего документа. Тогда нужно определить канонический URL и правильно настроить внутренние ссылки на основную версию.
Когда параметры создают дубли?
Типичный пример – /notebooks/, /notebooks/?sort=price и /notebooks/?utm_source=google. Если содержимое страницы отличается только порядком товаров или рекламной меткой, создавать отдельные поисковые документы обычно нет причины. Такие варианты способны расходовать ресурсы краулинга и путать технические отчёты.
Дубли также возникают из-за разных порядков параметров, повторяющихся фильтров и технических идентификаторов сессии. При аудите важно собрать все варианты, сравнить контент и выбрать основную версию. Затем canonical, ссылки и sitemap приводят к согласованному состоянию.
Как работать с фильтрами?
Фасетная навигация полезна пользователям, но способна сгенерировать тысячи сочетаний цвета, бренда, размера и других характеристик. Часть таких комбинаций может соответствовать реальному коммерческому спросу, поэтому полностью отключать все фильтры от SEO необязательно.
Индексируемые фильтры выбирают на основе семантики и качества посадочной страницы. Для них создают стабильный URL, уникальные мета-теги и полезное содержание. Остальные комбинации обрабатывают как технические. Правило должно учитывать canonical, внутренние ссылки и краулинг, чтобы Google не тратил ресурсы на бесконечные варианты.
Canonical, sitemap и внутренние ссылки в URL-структуре
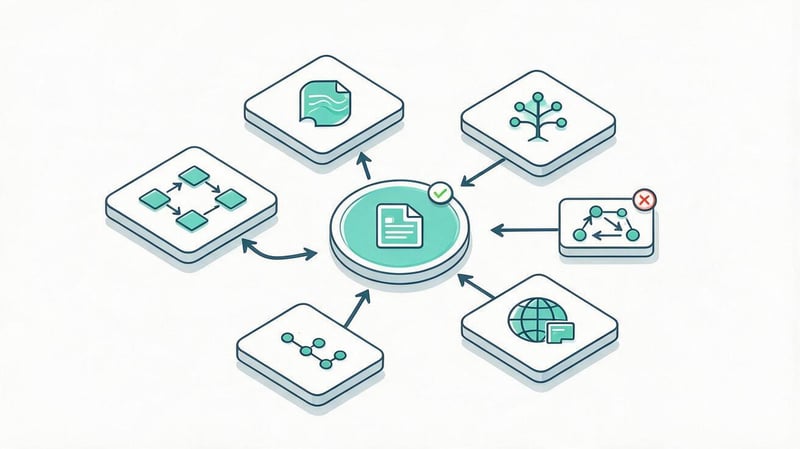
Адрес страницы работает вместе с другими техническими сигналами. Если внутренние ссылки ведут на один URL, canonical указывает на второй, а sitemap содержит третий, поисковой системе приходится самостоятельно выбирать основную версию. Чем последовательнее настроены сигналы, тем проще поддерживать индексирование.
Для каждой индексируемой страницы желательно определить один основной адрес. Именно он используется в меню, контентных ссылках, BreadcrumbList, XML-карте и языковых связях. Если существует несколько технических вариантов, они должны обрабатываться единым и понятным способом.
Как выбрать канонический URL?
Канонический URL – версия страницы, которую сайт считает основной среди нескольких похожих адресов. На самостоятельной индексируемой странице обычно ставят self-canonical. Если технические параметры создают дубли, canonical может вести на базовую версию без параметров.
Canonical не стоит использовать как универсальное средство исправления любой структуры. Если старый адрес полностью заменён новым, чаще нужен 301-редирект. Если страницы имеют разный контент и должны индексироваться отдельно, объединять их одним canonical нельзя. Решение зависит от отношений между документами.
Какие URL добавлять в sitemap.xml?
В sitemap.xml включают канонические индексируемые адреса, которые сайт хочет передать поисковой системе для обхода. Не следует добавлять туда 404, URL с редиректом, дубли, технические параметры и страницы с noindex. Иначе карта сайта противоречит другим сигналам.
После миграции sitemap нужно обновить одновременно с внутренними ссылками. Если новый сайт уже работает по новым адресам, старые URL не должны месяцами оставаться в XML-карте. Регулярная проверка sitemap через Google Search Console помогает обнаружить ошибки статусов и проблемы индексации.
Почему внутренние ссылки должны вести сразу на конечный URL?
Если меню или статья ссылаются на старый адрес, который затем перенаправляет пользователя через 301, сайт создаёт лишний шаг. При массовом количестве таких ссылок появляются дополнительные запросы, сложнее анализировать структуру и легче получить длинные redirect chains.
После смены URL внутреннюю перелинковку нужно обновить. Ссылки должны вести непосредственно на финальный адрес со статусом 200. Такой же URL следует использовать в canonical и sitemap. Для крупной миграции проверку удобно автоматизировать с помощью crawler и отчёта по redirecting internal links.
Что делать с финальным слэшем в URL?
Адреса /seo и /seo/ технически могут считаться разными URL. На одном сервере они автоматически объединяются, на другом способны открыть две одинаковые страницы. Поэтому проекту нужен единый стандарт trailing slash, закреплённый на уровне маршрутизации и генерации внутренних ссылок.
Если основной вариант заканчивается слэшем, версия без него должна вести на него постоянным редиректом. Если выбран обратный принцип, редирект настраивают в другую сторону. Не нужно оставлять обе версии со статусом 200 и надеяться, что canonical полностью решит проблему.
Внутренние ссылки, sitemap.xml, hreflang и BreadcrumbList должны использовать основной формат. Особенно полезна автоматическая проверка после обновлений CMS: новые шаблоны иногда начинают генерировать ссылки без слэша, даже если основная часть сайта использует противоположный стандарт.
Стоит ли менять URL уже работающего сайта?
Красивый новый адрес сам по себе редко оправдывает миграцию страницы, которая давно индексируется и получает трафик. При смене URL поисковой системе приходится обработать новый документ, редирект и обновлённые внутренние сигналы. Дополнительная работа появляется и у команды сайта.
Сначала нужно определить проблему текущего адреса. Если он стабилен, уникален, корректно индексируется и не мешает масштабированию структуры, его можно оставить. SEO-оптимизация URL действующего сайта требует более осторожного подхода, чем проектирование адресов на новом домене.
Ведущий SEO-специалист — Геннадий
Я не начинаю оптимизацию URL с массового переименования адресов. Сначала проверяю семантику, дерево страниц и внутренние связи, а уже после этого определяю формат URL. Если страница получает органический трафик и её адрес технически нормальный, менять его только ради более красивого slug обычно не стоит. Стабильный URL с правильными canonical и перелинковкой ценнее косметической миграции без реальной причины.
Когда изменение URL оправдано?
Смена адреса оправдана, когда текущая структура мешает индексации, создаёт большое количество дублей или не позволяет нормально развивать сайт. Причиной может быть переход на новую CMS, объединение доменов, изменение языковой архитектуры, исправление системно неправильных параметров или полная переработка каталога.
Каждый случай нужно оценивать отдельно. Массовая замена транслитерации, регистра или названия папки ради более аккуратного внешнего вида редко даёт достаточно пользы. Чем больше индексируемых страниц участвует в миграции, тем важнее карта соответствий и контроль после релиза.
Как безопасно перенести страницы на новые URL?
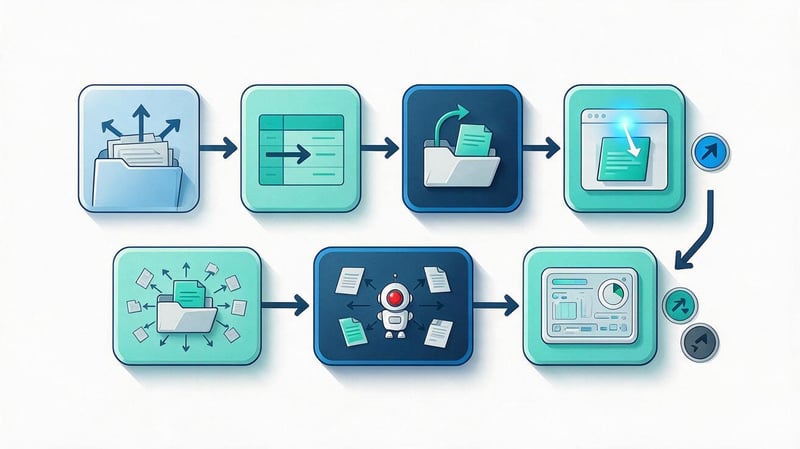
Перенос начинается с полного списка старых индексируемых адресов. Их собирают из crawler, sitemap, Google Search Console, аналитики и базы данных. Затем для каждого старого URL определяют новую конечную страницу. Нельзя полагаться только на текущие ссылки сайта, потому что часть старых документов может уже отсутствовать в навигации.
После подготовки карты редиректов на тестовом окружении проверяют статусы ответов, canonical, hreflang, sitemap и внутренние ссылки. Релиз лучше проводить как единую техническую операцию, чтобы старые и новые сигналы не оставались смешанными в течение длительного периода.
Составить карту старый URL → новый URL
Для каждого старого адреса указывают конечную релевантную страницу. Если содержание сохранилось, соответствие обычно получается один к одному. Если несколько документов объединяются, можно перенаправить их на общий новый материал, но только при совпадении поискового интента и содержания.
Нельзя автоматически отправлять все удалённые URL на главную. Такой редирект мало помогает пользователю и затрудняет понимание структуры. Если подходящей замены нет, иногда корректнее вернуть 404 или 410, чем создавать искусственное соответствие с нерелевантным разделом.
Настроить 301-редиректы
Для постоянного переноса используют 301. Редирект должен вести сразу на финальный адрес, без цепочки A → B → C. Перед запуском полезно проверить карту автоматически, чтобы обнаружить циклы, переходы на 404 и правила, которые перекрывают друг друга.
После релиза старые URL могут продолжать получать переходы из поисковой выдачи, внешних ссылок и закладок. Поэтому редиректы не стоит удалять сразу после обновления индекса. Их сохраняют достаточно долго и периодически проверяют по логам и данным аналитики.
Обновить внутренние ссылки
301 нужен для старых внешних адресов и сохранённых переходов, однако внутренние ссылки сайта должны сразу вести на новые URL. Это касается меню, карточек, статей, хлебных крошек, блоков похожих материалов и ссылок внутри шаблонов.
После миграции crawler должен показать минимальное количество внутренних ссылок на редиректы. Если система продолжает массово генерировать старые адреса, причину следует исправить в шаблоне или данных, а не оставлять редирект как постоянную внутреннюю прослойку.
Обновить canonical, sitemap и hreflang
Canonical после миграции должен указывать на новый основной адрес. В sitemap.xml также заменяют старые URL новыми. На мультиязычном сайте проверяют каждый hreflang, потому что одна устаревшая ссылка способна отправить поискового робота через редирект или на уже удалённый документ.
Дополнительно стоит проверить структурированные данные. BreadcrumbList, Article, Product и другие типы Schema.org могут содержать URL напрямую. Если разметка осталась старой, технические сигналы сайта становятся несогласованными даже при корректной работе обычных ссылок.
Проверить сайт после переноса
После публикации выполняют полный crawl. В отчёте проверяют статусы 200, 301 и 404, redirect chains, canonical, noindex, глубину страницы и внутренние ссылки. Отдельно сопоставляют количество индексируемых URL до и после миграции.
Через Google Search Console следят за обходом и индексацией новых страниц. Резкие изменения не всегда проявляются в первый день, поэтому контроль продолжают после релиза. При обнаружении системной ошибки её лучше исправить сразу, пока поисковая система не обработала большое количество неправильных URL.
Какие ошибки встречаются при SEO-оптимизации URL?
Большинство проблем появляется из-за отсутствия единого стандарта. Один шаблон создаёт адреса со слэшем, другой без него, редакторы используют разные регистры, фильтры генерируют параметры, а старые URL остаются во внутренних ссылках. По отдельности каждая ошибка кажется небольшой, но на крупном сайте они складываются в тысячи технических вариантов.
Проверять нужно всю цепочку: генерацию URL, статус ответа, canonical, sitemap, внутренние ссылки и фактическую индексируемость. Таблица ниже показывает типовые ситуации и безопасное направление исправления.
| Ошибка | Почему возникает проблема | Что сделать |
|---|---|---|
| Слишком сложный URL | В адрес попадают технические каталоги и повторяющиеся сегменты | Убрать элементы, которые не отражают реальную структуру |
| Несколько URL одного документа | Параметры, регистр или разные пути создают дубли | Выбрать основной адрес и настроить canonical или 301 |
| Заглавные и строчные версии | CMS принимает несколько вариантов регистра | Использовать нижний регистр и единое правило редиректа |
| Нижнее подчёркивание | Структура создавалась без общего стандарта | Для новых URL использовать дефисы без массовой миграции старых страниц |
| Переспам в slug | В адрес пытаются добавить весь кластер запросов | Оставить короткое смысловое название страницы |
| Бесконтрольные фильтры | Каждая комбинация характеристик получает URL | Отделить ценные SEO-фильтры от технических вариантов |
| Смена URL без 301 | Старый документ удаляется после миграции | Подготовить карту соответствий и постоянные редиректы |
| Старые внутренние ссылки | Шаблоны продолжают использовать прежние адреса | Обновить ссылки непосредственно на конечные URL |
| Две версии со слэшем | Сервер отдаёт /page и /page/ со статусом 200 | Выбрать единый trailing slash и настроить редирект |
| Несогласованные canonical и hreflang | Технические теги обновлялись отдельно от URL | Синхронизировать все сигналы после миграции |
После исправления ошибок нужно повторить crawl. Проверка подтверждает, что изменения действительно работают в браузере и на серверном уровне, а не только выглядят правильно в настройках CMS.
Чек-лист правильной SEO-иерархии URL
Перед запуском нового раздела или после изменения архитектуры полезно пройти единый чек-лист. Он помогает найти расхождения между структурой, адресами и техническими сигналами. Проверку лучше выполнять на тестовом окружении, а затем повторить на боевом сайте после публикации.
Основные пункты контроля:
- Для каждой индексируемой страницы определён тип, родительский раздел и место в общей архитектуре.
- Важные страницы доступны через обычные HTML-ссылки и не зависят только от формы поиска или JavaScript-сценария.
- URL коротко описывает содержание и не содержит ненужных технических сегментов.
- Каталоги в адресе соответствуют реальным разделам и не создаются только ради ключевого слова.
- Для новых страниц используется единый нижний регистр.
- Слова в slug разделяются одинаковым способом, без смешения дефисов и подчёркиваний.
- Для trailing slash выбран один стандарт, который применяется во всех шаблонах.
- GET-параметры и фасетная навигация не создают бесконтрольные индексируемые дубли.
- Канонический URL соответствует основной версии документа и используется последовательно.
- Sitemap.xml содержит только рабочие канонические страницы, предназначенные для индексации.
- Hreflang связывает реальные URL языковых версий без промежуточных редиректов.
- Внутренние ссылки ведут непосредственно на конечные страницы со статусом 200.
- На сайте отсутствуют важные orphan pages без нормальной внутренней перелинковки.
- Старые адреса после миграции имеют корректное соответствие через 301-редирект.
- После внедрения выполнен полный crawl и проверены коды ответа, canonical, ссылки и индексируемость.
Такой чек-лист удобно добавить в регламент разработки. Тогда требования к URL контролируются при создании каждой новой страницы, а технический долг не накапливается до следующего большого SEO-аудита.
Иерархия сайта начинается с семантики, типов страниц и отношений между разделами. URL фиксирует эту логику в адресах, но поисковому роботу также нужны понятные внутренние связи, доступная навигация, согласованные canonical, sitemap и hreflang. Поэтому сокращение или переименование slug без проверки всей архитектуры редко решает системную проблему.
На новом сайте правила URL лучше определить до разработки шаблонов. На действующем проекте сначала проводят crawl, собирают индексируемые страницы и оценивают последствия изменений. Такой подход сохраняет стабильные адреса там, где они работают, и исправляет только те участки, которые мешают индексации или дальнейшему масштабированию.
Если структура сайта уже разрослась, появились дубли, сложные фильтры или несогласованные URL, закажите технический SEO-аудит в Seo-Gen. Мы проверим архитектуру, уровни вложенности, canonical, редиректы и внутреннюю перелинковку, после чего подготовим готовое ТЗ на исправления для разработчика.


