SEO-оптимізація URL та ієрархія сайту


Адреса сторінки здається невеликою технічною деталлю, доки на сайті не з'являється кілька сотень категорій, послуг, товарів, статей та фільтрів. Якщо URL створювалися без загальної системи, поступово виникають дублі, довгі ланцюжки папок, різні варіанти регістру, зайві параметри та сторінки, до яких пошуковому роботу доводиться добиратися через кілька переходів.
SEO-оптимізація URL починається з архітектури сайту. Спочатку визначають, які розділи потрібні, як вони пов'язані між собою та які сторінки мають отримувати органічний трафік. Після цього вибирають єдиний формат адрес, правила для slug, параметрів, мовних версій, canonical та редиректів. Такий порядок знижує ризик технічних дублів та спрощує подальший розвиток сайту.
Що таке SEO-ієрархія URL та навіщо вона потрібна?
SEO-ієрархія показує, як адреси сторінок співвідносяться з логічною структурою сайту. Наприклад, інтернет-магазин може мати головну сторінку, каталог, категорію ноутбуків і окрему картку моделі. Адреси можна оформити як послідовний ланцюжок каталогів, проте сама структура сайту визначається ширше: меню, хлібними крихтами, внутрішніми посиланнями, сторінками категорій та фактичною глибиною переходів.
Для пошукового робота має значення, які сторінки пов'язані між собою та наскільки легко до них дістатися. Тому довга адреса з кількома папками сама по собі не робить сторінку глибокою, а коротка URL-адреса не гарантує хорошу доступність. Сторінка може розташовуватися за адресою /product-1/, але бути захованою на четвертому рівні навігації.
З яких частин складається URL-адреса?
Візьмемо адресу https://example.com/catalog/notebooks/gaming/?sort=price#models. У ній можна виділити протокол https, домен example.com, шлях /catalog/notebooks/gaming/, GET-параметр sort=price та fragment #models. Останній смисловий елемент шляху часто називають slug. У цьому прикладі таким елементом буде gaming.
Кожна частина виконує окрему функцію. Домен визначає сайт, шлях вказує на конкретний документ, параметри можуть змінювати сортування, фільтр чи інший стан сторінки. Fragment веде до певного місця всередині документа і зазвичай не створює нову сторінку, що індексується. При проєктуванні адрес потрібно розуміти призначення кожного елемента і не додавати технічні сегменти без причини.
Чим структура URL відрізняється від структури сайту?
Структура URL описує формат адрес, а архітектура сайту показує зв'язки між сторінками. Ці поняття пов'язані, але не збігаються. Адреса /catalog/notebooks/gaming/model-x/ виглядає як чотири послідовні рівні, хоча картка товару може бути доступна з головного меню через категорію та один додатковий перехід.
Можлива й протилежна ситуація. Сторінка /model-x/ має коротку URL-адресу, але посилання на неї знаходяться лише всередині декількох вкладених фільтрів. Тоді URL depth залишається мінімальним, а click depth збільшується. При SEO-аудиті обидва показники розглядають окремо, тому що скорочення кількості папок в адресі не вирішує проблему поганої внутрішньої навігації.
Що таке семантична URL-адреса?
Семантичний URL описує зміст сторінки зрозумілими словами. Таку адресу легше прочитати користувачеві, вебмайстру та пошуковому роботу. Порівняйте /product?id=17358 та /notebooks/macbook-air/. Другий варіант одразу показує тему сторінки, тоді як перший містить лише технічний ідентифікатор.
SEO-friendly URL зазвичай створюють у нижньому регістрі, поділяють слова дефісами та прибирають непотрібні службові елементи. При цьому семантичний URL не перетворюють на рядок із ключових слів. Адреса повинна залишатися стабільною та зрозумілою після оновлення тексту, зміни мета-тегів або розширення семантичного ядра.
Відповіді на ваші запитання
Який URL вважається SEO-friendly?
SEO-friendly URL зрозуміло описує зміст сторінки і дотримується єдиного стандарту сайту. Зазвичай він використовує нижній регістр, дефіси між словами та стабільний slug без непотрібних ідентифікаторів. Таку адресу простіше перевірити вручну, використовувати у внутрішніх посиланнях та підтримувати після оновлень CMS.
При цьому якість URL не можна оцінювати окремо від сторінки. Навіть акуратна адреса не виправить дублі, неправильний canonical або відсутність внутрішніх посилань. Тому технічна перевірка має охоплювати весь набір сигналів, пов'язаних із індексуванням документа.
Чи впливає рівень вкладеності сторінки на SEO?
Глибина впливає на те, наскільки легко пошуковий робот та користувач знаходять сторінку всередині сайту. Якщо важливий документ доступний лише через довгий ланцюжок переходів, він отримує менше внутрішніх зв'язків і може рідше обходитися. Тому рівень вкладеності сторінки корисно контролювати під час проєктування архітектури.
Кількість папок в URL не дорівнює глибині кліка. Сторінка з довгою адресою може бути доступна прямо з головного меню, а коротка URL-адреса може знаходитися далеко всередині каталогу. При аудиті потрібно перевіряти click depth та внутрішні посилання, а не рахувати тільки слеші.
Чи потрібно додавати категорію до URL товару?
Обов'язкової вимоги немає. Категорія в шляху допомагає візуально показати структуру, але створює додаткові складності, якщо товар належить до кількох розділів або з часом переноситься між ними. У таких проєктах стабільна незалежна адреса товару може бути зручнішою.
Якщо категорію включено до URL, слід визначити одну основну версію сторінки. Не можна створювати окрему адресу одного товару для кожної категорії без зрозумілої канонікалізації. Перед вибором моделі потрібно враховувати влаштування каталогу та подальший розвиток асортименту.
Чи можна використовувати кирилицю в URL?
Кирилічні URL-адреси можуть індексуватися, тому заборони на такий формат немає. Вибір залежить від технічної платформи, мови сайту та вже існуючої структури. Для нового проєкту важливо заздалегідь визначити єдине правило та застосовувати його у всіх шаблонах.
Якщо діючий сайт використовує транслітерацію та отримує органічний трафік, масова заміна адрес на кирилицю зазвичай потребує окремого обґрунтування. Будь-яка зміна URL, що індексується, пов'язана з редиректами, оновленням внутрішніх посилань і повторним обходом сторінок.
Чи потрібно змінювати старі URL-адреси на більш короткі?
Саме скорочення адреси рідко є достатньою причиною міграції. Якщо стара URL-адреса коректно працює, індексується і не заважає розвитку структури, її можна залишити. Чим довше сторінка існує, тим більше посилань та технічних зв'язків можуть бути прив'язані до поточної адреси.
Змінювати URL-адресу варто при системній проблемі: дублях, неправильній мовній архітектурі, неконтрольованих параметрах або переході на нову структуру. У цьому випадку заздалегідь готують карту редиректів та оновлюють усі внутрішні сигнали.
Який рівень вкладеності вважається оптимальним?
Фіксованого числа для всіх вебсайтів немає. Для невеликого корпоративного проєкту більшість пріоритетних сторінок зазвичай знаходиться близько до головної, тоді як великий каталог, природно, має більше рівнів. Оцінювати слід зручність навігації та кількість переходів до важливих документів.
Якщо комерційна сторінка доступна через меню, категорії та релевантні внутрішні посилання, додатковий сегмент URL не створює автоматичної SEO-проблеми. Набагато гірша ситуація, коли документ формально існує, але знайти його можна лише через внутрішній пошук.
Що краще використовувати в URL – дефіс або нижнє підкреслення?
Для нових адрес краще вибрати дефіс і дотримуватися цього стандарту у всіх шаблонах. Такий варіант широко використовується для поділу слів і добре читається людиною. Змішувати різні способи всередині однієї структури не варто, тому що це ускладнює контроль URL.
На існуючому сайті старі адреси із підкресленнями не обов'язково міняти масово. Якщо вони працюють і індексуються, потенційна користь від косметичної міграції може бути меншою за технічні витрати та ризик помилок у редиректах.
Чи потрібно закривати URL-адреси з GET-параметрами від індексації?
Рішення залежить від призначення параметра. Сортування, UTM-мітки та багато технічних варіантів зазвичай не вимагають окремої сторінки, що індексується. Комерційно корисний фільтр з пошуковим попитом, унікальним змістом та стабільним URL може використовуватися як самостійна посадкова сторінка.
Тому загальне правило «закрити всі параметри» занадто грубе. Спочатку потрібно класифікувати типи URL, визначити канонічні версії та перевірити, які комбінації дійсно мають цінність для пошуку.
Як спроєктувати ієрархічну структуру сайту?
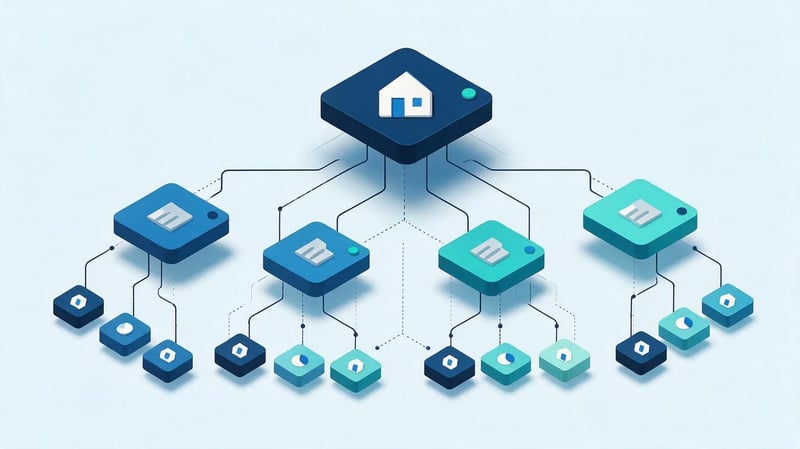
Ієрархічна структура сайту будується від загальних розділів до вужчих сторінок. Для інтернет-магазину це може бути шлях від каталогу до категорії та товару, для сайту послуг – від напрямку до окремої послуги, для блогу – від основного розділу до тематичної рубрики та статті. Така схема допомагає наперед визначити зв'язки між документами.
До розробки URL корисно скласти дерево сайту. У ньому фіксують майбутні розділи, батьківські сторінки, дочірні сторінки, цільові запити та передбачуваний рівень вкладеності. Після цього розробник отримує зрозумілу архітектуру, а SEO-фахівець може перевірити, чи немає зайвих рівнів, сторінок, що перетинаються, і розділів без пошукового попиту.
Приклад простої схеми:
Головна
├── Послуги
│   ├── SEO
│   │   ├── SEO-аудит
│   │   └── SEO-консалтинг
│   └── PPC
├── Інструменти
│   ├── Перевірка URL
│   └── Генератор Sitemap
└── Блог
    ├── SEO
    └── PPC
Ієрархічна структура робіт зі створення сайту
Ієрархічна структура робіт зі створення сайту починається зі збору семантики та визначення пошукового інтенту. Запити групують за змістом, після чого стає зрозумілим, де потрібна окрема категорія, послуга, стаття, товарна добірка або інформаційна сторінка. Потім кластери розподіляють по майбутньому дереву сайту.
Наступний етап – визначення батьківських та дочірніх документів. Після цього проєктують меню, хлібні крихти та внутрішню перелінковку. URL-адресу формують вже на готовій логічній основі. У фіналі налаштовують canonical, hreflang, sitemap.xml та правила індексації. Перед запуском сайт проходить повний краулінг, щоб виявити 404, редиректи, дублі та сторінки без внутрішніх посилань.
Які сторінки належать до першого рівня?
До першого рівня зазвичай належать основні розділи, які відкриваються безпосередньо з головної сторінки або головного меню. Для комерційного сайту такими розділами можуть бути послуги, каталог, ціни, проєкти та блог. Для інтернет-магазину перший рівень часто представлений великими товарними напрямками чи загальною сторінкою каталогу.
Кількість розділів визначається змістом сайту та попитом, а не бажанням додати більше ключових слів до URL. Якщо окрема папка не відповідає реальному розділу і не допомагає навігації, створювати її для адреси не потрібно. Кожен додатковий рівень повинен мати зрозуміле призначення всередині структури.
Головна сторінка
Головна знаходиться в корені домену і умовно вважається нульовим рівнем. Через неї користувач отримує доступ до основних напрямків сайту, а внутрішні посилання розподіляють увагу між найважливішими розділами. Від головної зазвичай починається розрахунок click depth, хоча частина сторінок може бути доступна через інші навігаційні елементи.
В URL головної сторінки не додають додаткові каталоги. Основна адреса повинна відповідати вибраній версії домену, протоколу та trailing slash. Усі альтернативні варіанти, наприклад HTTP, інший піддомен або неправильна версія зі слешем, повинні зводитися до єдиної канонічної адреси через редиректи.
Основні розділи
Розділи першого рівня зручно оформляти короткими та стійкими адресами: /services/, /catalog/, /blog/, /tools/. Назва папки повинна відповідати змісту розділу та зберігати сенс навіть після розширення сайту. Занадто вузький slug іноді доводиться змінювати при додаванні нових напрямків, тому структуру краще продумувати заздалегідь.
Якщо розділ існує лише як технічний прошарок і не містить корисної сторінки, слід перевірити, чи потрібен він користувачеві та пошуковій системі. У деяких проєктах достатньо прямих адрес послуг, а в інших повноцінна сторінка категорії допомагає навігації, перелінкуванню та роботі з окремим пошуковим кластером.
Які сторінки належать до другого та третього рівня?
На другому рівні зазвичай розміщують підрозділи, категорії та окремі напрями послуг. Третій рівень використовують для вужчих сутностей, якщо така деталізація відповідає структурі проєкту. Наприклад, шлях /services/seo/audit/ показує напрямок SEO та окрему послугу аудиту, а /catalog/notebooks/gaming/ – категорію та її підкатегорію.
Додатковий сегмент має передавати реальний зв'язок між сторінками. Якщо папка існує лише заради більш довгої URL-адреси, вона ускладнює міграції та підтримку. Для кожного нового ступеня корисно перевірити пошуковий попит, наявність власного контенту, місце у меню та внутрішні посилання на дочірні документи.
Як визначити рівень вкладеності сторінки?
Рівень вкладеності сторінки часто помилково визначають за кількістю слешів в адресі. Такий підрахунок показує структуру шляху, проте він нічого не говорить про те, скільки переходів потрібно користувачеві або Googlebot. Для SEO важливіше розглядати URL depth та глибину кліка одночасно.
Рівень вкладеності сторінки оцінюють за тим, як документ вбудований у загальну архітектуру. Якщо комерційна сторінка знаходиться далеко від головних розділів, не пов'язана з категоріями і отримує одне внутрішнє посилання, коротка URL-адреса ситуацію не виправить. Завдання полягає в тому, щоб важливі документи знаходилися у зрозумілому навігаційному ланцюжку.
URL depth та click depth – у чому різниця?
URL depth показує кількість смислових сегментів шляху. Адреса /catalog/notebooks/gaming/ глибша за адресу /notebooks/, якщо дивитися тільки на рядок URL. Click depth відповідає на інше питання: скільки переходів потрібно від головної чи іншого великого хаба до цільової сторінки.
Уявімо товар з адресою /product-x/. Якщо посилання на нього знаходиться лише всередині категорії, підкатегорії та ще одного фільтра, пошуковому роботу знадобиться кілька переходів. Одночасно стаття з адресою /blog/seo/url-structure/ може відкриватися безпосередньо із блоку нових матеріалів на головній. Тому глибина сторінки та довжина шляху розглядаються окремо.
Скільки рівнів вкладеності допустимо?
Універсального обмеження за кількістю рівнів немає. Правило «не більше трьох слешів» занадто грубе для великих магазинів, маркетплейсів, баз знань та багатомовних сайтів. Іноді довгий шлях точно відбиває архітектуру і не створює технічних проблем.
Оцінювати потрібно доступність важливих сторінок, відсутність нескінченних ланцюжків та зрозумілість структури. Якщо комерційний документ можна знайти лише після п'яти послідовних переходів, слід переглянути внутрішні зв'язки. Якщо довга URL-адреса доступна з меню, категорії та пов'язаних сторінок, одна лише довжина адреси не є причиною для міграції.
Як зменшити глибину важливих сторінок?
Спочатку визначають сторінки, які мають отримувати більше внутрішньої ваги та швидше виявлятися пошуковим роботом. Зазвичай, це основні послуги, категорії, пріоритетні товарні добірки та статті, які підтримують комерційні сторінки. Потім перевіряють, скільки внутрішніх переходів потрібно для доступу до них.
Зменшити click depth допомагають посилання з головного меню, хабів, категорій, хлібних крихт та тематичних блоків. Внутрішня перелінковка має бути осмисленою: посилання ставлять там, де користувач справді може продовжити шлях. Просте додавання десятків посилань у футер створює шум та не замінює нормальну інформаційну архітектуру.
Як побудувати семантичний URL?
SEO-оптимізація URL вимагає єдиного набору правил для всього проєкту. Розробник повинен заздалегідь знати, який регістр використовувати, як розділяти слова, що робити з категоріями, як оформляти мовні версії та чи допускаються параметри. Тоді нові сторінки створюються за загальною схемою, а не отримують випадкові адреси залежно від конкретного шаблона.
Хороша адреса зберігає сенс без зайвих деталей. Вона не залежить від дати публікації, рекламної кампанії або тимчасової назви акції, якщо ці елементи не потрібні змісту сторінки. Стабільність особливо важлива для документів, які планується просувати кілька років і на які поступово накопичуються зовнішні та внутрішні посилання.
Чи потрібно використовувати ключові слова в URL?
Ключове слово можна використати, коли воно природно описує зміст. Для сторінки SEO-аудиту адреса /seo-audit/ зрозуміла і без додаткових елементів. Додавати кілька варіантів одного запиту на кшталт /seo-audit-proverka-saita-seo-analiz/ не потрібно, тому що такий slug гірше читається та складніше підтримується.
Фраза в адресі повинна відповідати основній темі сторінки, а розширена семантика розкривається в Title, H1, тексті та підзаголовках. SEO-оптимізація URL не вимагає переносити в slug весь кластер запитів. Якщо тема сторінки змінюється лише частково, стабільна адреса часто вигідніша за чергове перейменування.
Якої довжини має бути URL?
Фіксованого SEO-ліміту в 70, 75 чи 100 символів дотримуватися не потрібно. Коротку адресу зручніше читати, копіювати, перевіряти у звітах та використовувати у технічних правилах, тому зайві елементи варто прибирати. Однак скорочувати зрозумілий шлях ціною втрати логіки структури також не потрібно.
При аудиті довгого URL потрібно дивитися, чому він вийшов таким. Якщо довжину створюють повторювані категорії, ідентифікатори, дати та службові параметри, структуру варто спростити. Якщо шлях відображає реальну архітектуру великого сайту, розмір рядка ще не говорить про технічну помилку.
Дефіс чи нижнє підкреслення?
Для поділу слів зазвичай використовують дефіс. Адреса /seo-url-structure/ читається звичніше, ніж /seo_url_structure/, і відповідає поширеному формату людинозрозумілих URL. Головне правило – вибрати один стандарт і не створювати різні варіанти для нових розділів.
Якщо старий сайт роками працює з підкресленнями та сторінки отримують органічний трафік, масова заміна лише заради дефісів рідко виправдана. Така міграція вимагатиме 301-редиректів, оновлення внутрішніх посилань, sitemap та технічного контролю. Зміни мають надавати практичну користь, а не косметичний ефект.
Використовувати верхній чи нижній регістр?
Безпечніше створювати URL у нижньому регістрі. На деяких серверах /SEO/ і /seo/ можуть оброблятися як різні адреси, через що виникають дублі чи помилки при ручній постановці посилань. Єдиний нижній регістр спрощує роботу розробників та знижує кількість випадкових варіантів.
Якщо система приймає адресу з великими літерами, її слід зводити до основної версії. Таке правило бажано реалізувати на рівні CMS чи сервера, щоб редактору не доводилося контролювати регістр вручну. Внутрішні посилання, canonical і sitemap повинні використовувати один і той же кінцевий URL.
Кирилиця, латиниця чи транслітерація?
Пошукові системи здатні працювати з кириличними адресами, тому сама кирилиця не є помилкою. Для проєкту важливішим є єдиний принцип. Одні сайти використовують латиницю, інші – транслітерацію, треті створюють локалізовані URL-адреси для кожної мови. Вибір залежить від CMS, поточної структури та вимог до мультимовності.
Змішувати кілька підходів усередині однієї групи сторінок небажано. Якщо українська версія використовує /uk/poshukova-optymizatsiya/, а російська /ru/seo-optimizaciya/, це має бути усвідомленим правилом. При зміні мовної моделі перевіряють hreflang, canonical і всі внутрішні посилання між версіями.
Як побудувати ієрархію онлайн?
До розробки дерево сайту зручно винести в окрему схему. Так SEO-фахівець, розробник, дизайнер та контент-менеджер бачать однакову структуру та можуть обговорювати конкретні сторінки. Якщо потрібно побудувати ієрархію онлайн, достатньо інструмента, де можна відобразити батьківські та дочірні зв'язки та додати дані по кожному URL.
Для маленького проєкту підійде таблиця або mind map. Великому інтернет-магазину зручніше використовувати таблицю з фільтрами, типами сторінок, статусами індексації та зв'язками між категоріями. Формат вторинний: схема повинна допомагати контролювати архітектуру та не втрачати сторінки під час розробки.
Які дані потрібно внести до схеми?
Для кожної сторінки фіксують назву, тип документа, батьківський розділ, передбачуваний URL та основний пошуковий кластер. Корисно відразу додати рівень вкладеності, статус index/noindex, канонічну адресу, мову та зв'язок з іншими версіями сторінки. Така таблиця допомагає побачити технічні конфлікти до верстки.
Якщо потрібно створити ієрархію онлайн для чинного сайту, до схеми також додають поточну URL-адресу, нову URL-адресу та тип дії: залишити, перенести через 301, об'єднати або видалити. Для міграції окреме поле з картою редиректів значно знижує ризик втратити старі адреси та зовнішні посилання.
Де можна створити ієрархію онлайн?
Для простої схеми підходять сервіси mind map і онлайн-діаграм. У них зручно показувати розгалуження розділів і обговорювати майбутню навігацію з командою. Google Sheets або інша таблиця краще підходить для великих проєктів, де потрібно сортувати тисячі URL-адрес, додавати семантику, canonical і статуси впровадження.
Існують також sitemap planners та візуалізації з краулерів, які допомагають зробити ієрархію онлайн на основі вже існуючого сайту. Для SEO-аудиту корисний Screaming Frog або схожий crawler: він показує внутрішні посилання, рівні обходу, коди відповіді та orphan pages при підключенні додаткових джерел URL.
Як перевірити готову структуру?
Спочатку потрібно переконатися, що кожна сторінка, що індексується, має зрозуміле місце в дереві. Якщо документ не відноситься до жодного розділу і не отримує внутрішніх посилань, його роль слід переглянути. Окремо перевіряють сторінки, створені під однаковий інтент: вони можуть конкурувати одна з одною і ускладнювати архітектуру.
Потім дивляться на технічні сигнали. Сторінка повинна мати коректний статус відповіді, правильний canonical, місце в sitemap при необхідності і робочі внутрішні посилання. Корисно виконати crawl майбутньої структури на тестовому оточенні перед релізом, щоб знайти помилки раніше, ніж їх побачить Googlebot.
Як налаштувати URL для різних типів сторінок?
Однакове правило не можна механічно застосовувати до послуг, статей, товарів та фільтрів. Кожен тип сторінок має свою роль і життєвий цикл. Стаття може знаходитись у тематичному розділі блогу, товар – зберігати незалежну адресу після перенесення між категоріями, а регіональна сторінка – містити географічний сегмент.
Перед створенням шаблонів слід описати правила для кожного типу. У CMS ці правила краще закріпити системно, щоб редактор заповнював slug, а структура формувалася передбачувано. Це зменшує кількість ручних помилок та допомагає зберегти однаковість після оновлення шаблонів.
URL для послуг
Для послуг зазвичай вибирають короткі адреси, які відображають напрямок та конкретну послугу. Наприклад, /services/seo/ може бути розділом, а /services/seo/audit/ – окремою посадковою сторінкою. Якщо загальний розділ послуг не потрібен як документ, що індексується, архітектура може бути більш плоскою.
Не варто додавати в URL рекламні визначення на зразок best, cheap або кілька географічних маркерів без реальної причини. Семантичний URL повинен залишатися зрозумілим після зміни офера та тексту. Комерційні уточнення краще розкривати в контенті, мета-тегах та окремих посадкових сторінках.
URL для блогу
Для блогу підходять дві поширені моделі: /blog/article-name/ та /blog/category/article-name/. Перша простіша та стабільніша при перенесенні матеріалу між рубриками. Друга візуально показує тематичну приналежність і може бути зручною у великих редакційних проєктах.
Вибрану модель бажано застосовувати до всіх нових публікацій. Якщо існуючий блог вже використовує плоску структуру, перехід до вкладеної схеми лише заради слова категорії в URL зазвичай не потрібний. Тематичний зв'язок статті можна показати через хлібні крихти, рубрики та внутрішні посилання.
URL категорій та товарів інтернет-магазину
Категорії зручно організовувати ієрархічно: /catalog/notebooks/, /catalog/notebooks/gaming/. Для товару можлива адреса всередині категорії або окремий стабільний шлях, наприклад, /product/macbook-air/. Обидва варіанти можна застосовувати, якщо структура сайту і canonical налаштовані послідовно.
Незалежна URL-адреса зручна, коли товар може одночасно знаходитися в декількох категоріях. У такому разі не доводиться створювати різні адреси одного товару або змінювати URL-адресу після перенесення між розділами. Якщо категорію включено в шлях, CMS має гарантувати одну основну версію документа.
URL регіональних сторінок
Регіональні посадкові сторінки створюють, коли бізнес має реальний локальний інтент і окрему інформацію для конкретного міста чи регіону. Адреса може виглядати як /seo/kyiv/ або /kyiv/seo/. Вибір залежить від загальної архітектури та того, що є основним рівнем – послуга чи географія.
Не слід генерувати десятки однакових міських сторінок лише заради заміни назви населеного пункту. Кожна версія, що індексується, повинна мати власну цінність: умови, контакти, зону обслуговування, локальні кейси або інший релевантний контент. URL-адреса відображає структуру, але не замінює зміст.
URL мультимовного сайту
Для мовних версій зручно використовувати окремі каталоги: /uk/, /ru/, /en/. Така схема чітко поділяє документи і дозволяє зв'язати їх через hreflang. Кожна версія сторінки отримує власний URL, Title, Description, H1 та локалізований контент.
Canonical зазвичай вказує на поточну мовну сторінку, якщо вона є самостійною версією, що індексується. Hreflang пов'язує еквіваленти між мовами. Якщо slug локалізовано, потрібно стежити, щоб усі посилання використовували актуальні адреси та не створювали проміжні редиректи між мовними версіями.
Як працювати з GET-параметрами, фільтрами та сортуванням?
GET-параметри зустрічаються в інтернет-магазинах, пошуку, фільтрах, аналітиці та інтерфейсах сортування. Їхня наявність сама по собі не означає SEO-проблему. Помилки з'являються, коли кожен параметр створює окремий індексований URL з тим самим вмістом або генерує практично нескінченну кількість комбінацій.
Для кожного типу параметрів необхідно визначити правило. Одні адреси можуть брати участь у пошуковому просуванні, інші мають залишатися технічними. Окремо перевіряють пагінацію, сортування, фільтри за характеристиками, UTM-мітки та параметри внутрішнього пошуку.
Коли GET-параметри є нормальними?
Параметри корисні, коли вони керують станом інтерфейсу або передають дані застосунку. Наприклад, ?sort=price може змінювати порядок товарів, а ?page=2 відкривати наступну частину списку. Такі URL можуть існувати технічно, якщо їхня обробка не створює хаосу в індексації.
Проблема виникає за відсутності загального правила. Якщо той самий набір товарів доступний через десятки варіантів сортування, пошукова система отримує кілька адрес схожого документа. Тоді потрібно визначити канонічний URL та правильно налаштувати внутрішні посилання на основну версію.
Коли параметри створюють дублі?
Типовий приклад – /notebooks/, /notebooks/?sort=price та /notebooks/?utm_source=google. Якщо вміст сторінки відрізняється лише порядком товарів або рекламною позначкою, створювати окремі пошукові документи зазвичай немає причини. Такі варіанти здатні витрачати ресурси краулінгу та плутати технічні звіти.
Дублі також виникають через різні порядки параметрів, фільтрів, що повторюються, і технічних ідентифікаторів сесії. При аудиті важливо зібрати всі варіанти, порівняти контент та вибрати основну версію. Потім canonical, посилання і sitemap приводять до узгодженого стану.
Як працювати з фільтрами?
Фасетна навігація корисна користувачам, але здатна згенерувати тисячі поєднань кольору, бренду, розміру та інших характеристик. Частина таких комбінацій може відповідати реальному комерційному попиту, тому повністю відключати всі фільтри від SEO необов'язково.
Фільтри, що індексуються, вибирають на основі семантики і якості посадкової сторінки. Для них створюють стабільний URL, унікальні мета-теги та корисний вміст. Інші комбінації обробляють як технічні. Правило має враховувати canonical, внутрішні посилання та краулінг, щоб Google не витрачав ресурси на нескінченні варіанти.
Canonical, sitemap та внутрішні посилання в URL-структурі
Адреса сторінки працює разом із іншими технічними сигналами. Якщо внутрішні посилання ведуть на один URL, canonical вказує на другий, а sitemap містить третій, пошуковій системі доводиться самостійно вибирати основну версію. Чим послідовніше налаштовані сигнали, тим простіше підтримувати індексування.
Для кожної сторінки, що індексується, бажано визначити одну основну адресу. Саме вона використовується в меню, контентних посиланнях, BreadcrumbList, XML-карті та мовних зв'язках. Якщо є кілька технічних варіантів, вони мають оброблятися єдиним і зрозумілим способом.
Як вибрати канонічний URL?
Канонічний URL – версія сторінки, яку сайт вважає основною серед кількох схожих адрес. На самостійній сторінці, що індексується, зазвичай ставлять self-canonical. Якщо технічні параметри створюють дублі, canonical може вести на базову версію без параметрів.
Canonical не варто використовувати як універсальний засіб виправлення будь-якої структури. Якщо стару адресу повністю замінено на нову, частіше потрібен 301-редирект. Якщо сторінки мають різний контент і повинні індексуватися окремо, об'єднувати їх одним canonical не можна. Рішення залежить від зв'язків між документами.
Які URL-адреси додавати до sitemap.xml?
У sitemap.xml включають канонічні адреси, що індексуються, які сайт хоче передати пошуковій системі для обходу. Не слід додавати туди 404, URL з редиректом, дублі, технічні параметри та сторінки з noindex. Інакше мапа сайту суперечить іншим сигналам.
Після міграції sitemap потрібно оновити одночасно з внутрішніми посиланнями. Якщо новий сайт вже працює за новими адресами, старі URL-адреси не повинні залишатися місяцями в XML-карті. Регулярна перевірка sitemap через Google Search Console допомагає виявити помилки статусів та проблеми індексації.
Чому внутрішні посилання повинні вести відразу на кінцеву URL-адресу?
Якщо меню або стаття посилаються на стару адресу, яка потім перенаправляє користувача через 301, сайт створює зайвий крок. При масовій кількості таких посилань з'являються додаткові запити, складніше аналізувати структуру та легко отримати довгі redirect chains.
Після зміни URL внутрішнє перелінкування потрібно оновити. Посилання повинні вести безпосередньо на фінальну адресу зі статусом 200. Таку саму URL-адресу слід використовувати в canonical і sitemap. Для великої міграції перевірку зручно автоматизувати за допомогою crawler та звіту з redirecting internal links.
Що робити з фінальним слешем у URL?
Адреси /seo та /seo/ технічно можуть вважатися різними URL-адресами. На одному сервері вони автоматично об'єднуються, на іншому здатні відкрити дві однакові сторінки. Тому проєкту потрібний єдиний стандарт trailing slash, закріплений на рівні маршрутизації та генерації внутрішніх посилань.
Якщо основний варіант закінчується слешем, версія без нього має вести на неї постійним редиректом. Якщо вибрано зворотний принцип, редирект налаштовують в інший бік. Не потрібно залишати обидві версії зі статусом 200 і сподіватися, що canonical повністю вирішить проблему.
Внутрішні посилання, sitemap.xml, hreflang та BreadcrumbList повинні використовувати основний формат. Особливо корисна автоматична перевірка після оновлення CMS: нові шаблони іноді починають генерувати посилання без слеша, навіть якщо основна частина сайту використовує протилежний стандарт.
Чи варто змінювати URL-адресу вже працюючого сайту?
Красива нова адреса сама по собі рідко виправдовує міграцію сторінки, яка давно індексується та отримує трафік. При зміні URL-адреси пошуковій системі доводиться обробити новий документ, редирект і оновлені внутрішні сигнали. Додаткова робота з'являється і в команди сайту.
Спочатку потрібно визначити проблему поточної адреси. Якщо вона стабільна, унікальна, коректно індексується і не заважає масштабуванню структури, її можна залишити. SEO-оптимізація URL діючого сайту вимагає обережнішого підходу, ніж проєктування адрес на новому домені.
Провідний SEO-спеціаліст — Геннадій
Я не починаю оптимізацію URL із масового перейменування адрес. Спочатку перевіряю семантику, дерево сторінок та внутрішні зв'язки, а вже після цього визначаю формат URL. Якщо сторінка отримує органічний трафік і її адреса технічно нормальна, змінювати її тільки заради красивішого slug зазвичай не варто. Стабільний URL з правильними canonical і перелінкуванням цінніший косметичної міграції без реальної причини.
Коли зміна URL-адреси виправдана?
Зміна адреси виправдана, коли поточна структура заважає індексації, створює велику кількість дублів або не дозволяє нормально розвивати сайт. Причиною може бути перехід на нову CMS, об'єднання доменів, зміну мовної архітектури, виправлення системно неправильних параметрів або повну переробку каталогу.
Кожен випадок слід оцінювати окремо. Масова заміна транслітерації, регістру або назви папки для більш акуратного зовнішнього вигляду рідко дає достатньо користі. Чим більше сторінок, що індексуються, бере участь у міграції, тим важливіші карта відповідностей і контроль після релізу.
Як безпечно перенести сторінки на нові URL?
Перенесення починається з повного списку старих адрес, що індексуються. Їх збирають із crawler, sitemap, Google Search Console, аналітики та бази даних. Потім для кожної старої URL-адреси визначають нову кінцеву сторінку. Не можна покладатися лише на поточні посилання сайту, тому що частина старих документів може бути відсутня в навігації.
Після підготовки карти редиректів на тестовому оточенні перевіряють статуси відповідей, canonical, hreflang, sitemap і внутрішні посилання. Реліз краще проводити як єдину технічну операцію, щоб старі та нові сигнали не залишалися змішаними протягом тривалого періоду.
Скласти карту старий URL → новий URL
Для кожної старої адреси вказують кінцеву релевантну сторінку. Якщо зміст зберігся, відповідність зазвичай виходить один до одного. Якщо кілька документів об'єднуються, можна перенаправити їх на загальний новий матеріал, але лише при збігу пошукового інтенту та змісту.
Не можна автоматично надсилати всі видалені URL-адреси на головну. Такий редирект мало допомагає користувачеві та ускладнює розуміння структури. Якщо відповідної заміни немає, іноді коректніше повернути 404 або 410, ніж створювати штучну відповідність із нерелевантним розділу.
Налаштувати 301-редиректи
Для постійного перенесення використовують 301. Редирект повинен вести відразу на фінальну адресу, без ланцюжка A → B → C. Перед запуском корисно перевірити карту автоматично, щоб виявити цикли, переходи на 404 та правила, які перекривають один одного.
Після релізу старі URL-адреси можуть продовжувати отримувати переходи з пошукової видачі, зовнішніх посилань та закладок. Тому редиректи не варто видаляти одразу після оновлення індексу. Їх зберігають досить довго і періодично перевіряють за логами та даними аналітики.
Оновити внутрішні посилання
301 потрібен для старих зовнішніх адрес та збережених переходів, однак внутрішні посилання сайту повинні відразу вести на нові URL. Це стосується меню, карток, статей, хлібних крихт, блоків схожих матеріалів та посилань усередині шаблонів.
Після міграції crawler має показати мінімальну кількість внутрішніх посилань на редиректи. Якщо система продовжує масово генерувати старі адреси, причину слід виправити в шаблоні або даних, а не залишати редирект як постійний внутрішній прошарок.
Оновити canonical, sitemap і hreflang
Canonical після міграції повинен вказувати на нову основну адресу. У sitemap.xml також замінюють старі URL-адреси новими. На мультимовному сайті перевіряють кожен hreflang, тому що одне застаріле посилання здатне відправити пошукового робота через редирект або на вже видалений документ.
Додатково слід перевірити структуровані дані. BreadcrumbList, Article, Product та інші типи Schema.org можуть містити URL безпосередньо. Якщо розмітка залишилася старою, технічні сигнали сайту стають неузгодженими навіть за умови коректної роботи звичайних посилань.
Перевірити сайт після перенесення
Після публікації виконують повний crawl. У звіті перевіряють статуси 200, 301 та 404, redirect chains, canonical, noindex, глибину сторінки та внутрішні посилання. Окремо зіставляють кількість індексованих URL до і після міграції.
Через Google Search Console стежать за обходом та індексацією нових сторінок. Різкі зміни не завжди виявляються першого дня, тому контроль продовжують після релізу. При виявленні системної помилки її краще виправити одразу, поки пошукова система не обробила велику кількість неправильних URL.
Які помилки трапляються під час SEO-оптимізації URL?
Більшість проблем виникає через відсутність єдиного стандарту. Один шаблон створює адреси зі слешем, інший без нього, редактори використовують різні регістри, фільтри генерують параметри, а старі URL-адреси залишаються у внутрішніх посиланнях. Окремо кожна помилка здається невеликою, але на великому сайті вони складаються у тисячі технічних варіантів.
Перевіряти потрібно весь ланцюжок: генерацію URL, статус відповіді, canonical, sitemap, внутрішні посилання та фактичну індексованість. Таблиця нижче показує типові ситуації та безпечний напрямок виправлення.
| Помилка | Чому виникає проблема | Що зробити |
|---|---|---|
| Занадто складна URL | До адреси потрапляють технічні каталоги та повторювані сегменти | Прибрати елементи, які не відображають реальну структуру |
| Декілька URL одного документа | Параметри, регістр чи різні шляхи створюють дублі | Вибрати основну адресу і налаштувати canonical або 301 |
| Великі та малі версії | CMS приймає кілька варіантів регістру | Використовувати нижній регістр та єдине правило редиректу |
| Нижнє підкреслення | Структура створювалася без загального стандарту | Для нових URL-адрес використовувати дефіси без масової міграції старих сторінок |
| Переспам у slug | До адреси намагаються додати весь кластер запитів | Залишити коротку смислову назву сторінки |
| Безконтрольні фільтри | Кожна комбінація характеристик отримує URL | Відокремити цінні SEO-фільтри від технічних варіантів |
| Зміна URL без 301 | Старий документ видаляється після міграції | Підготувати карту відповідностей та постійні редиректи |
| Старі внутрішні посилання | Шаблони продовжують використовувати попередні адреси | Оновити посилання безпосередньо на кінцеві URL |
| Дві версії зі слешем | Сервер віддає /page та /page/ зі статусом 200 | Вибрати єдиний trailing slash та налаштувати редирект |
| Неузгоджені canonical і hreflang | Технічні теги оновлювалися окремо від URL | Синхронізувати всі сигнали після міграції |
Після виправлення помилок необхідно повторити crawl. Перевірка підтверджує, що зміни дійсно працюють у браузері та на серверному рівні, а не тільки виглядають правильно в налаштуваннях CMS.
Чек-лист правильної SEO-ієрархії URL
Перед запуском нового розділу або після зміни архітектури корисно пройти єдиний чек-лист. Він допомагає знайти розбіжності між структурою, адресами та технічними сигналами. Перевірку краще виконувати на тестовому оточенні, потім повторити на бойовому сайті після публікації.
Основні пункти контролю:
- Для кожної сторінки, що індексується, визначено тип, батьківський розділ і місце в загальній архітектурі.
- Важливі сторінки доступні через звичайні HTML-посилання та не залежать лише від форми пошуку або JavaScript-сценарію.
- URL коротко описує зміст та не містить непотрібних технічних сегментів.
- Каталоги в адресі відповідають реальним розділам і не створюються лише задля ключового слова.
- Для нових сторінок використовується єдиний нижній регістр.
- Слова у slug поділяються однаковим способом, без змішування дефісів та підкреслень.
- Для trailing slash вибрано один стандарт, який застосовується у всіх шаблонах.
- GET-параметри і фасетна навігація не створюють безконтрольні дублі, що індексуються.
- Канонічний URL відповідає основній версії документа та використовується послідовно.
- Sitemap.xml містить лише робочі канонічні сторінки, призначені для індексації.
- Hreflang пов'язує реальні URL мовних версій без проміжних редиректів.
- Внутрішні посилання ведуть безпосередньо до кінцевих сторінок зі статусом 200.
- На сайті відсутні важливі orphan pages без нормальної внутрішньої перелінковки.
- Старі адреси після міграції мають коректну відповідність через 301-редирект.
- Після впровадження виконаний повний crawl і перевірені коди відповіді, canonical, посилання та індексованість.
Такий чек-лист зручно додати до регламенту розробки. Тоді вимоги до URL контролюються під час створення кожної нової сторінки, а технічний борг не накопичується до наступного великого SEO-аудиту.
Ієрархія сайту починається з семантики, типів сторінок та зв'язків між розділами. URL фіксує цю логіку в адресах, але пошуковому роботу також потрібні зрозумілі внутрішні зв'язки, доступна навігація, узгоджені canonical, sitemap і hreflang. Тому скорочення чи перейменування slug без перевірки всієї архітектури рідко вирішує системну проблему.
На новому сайті правила URL краще визначити до розробки шаблонів. На діючому проєкті спочатку проводять crawl, збирають сторінки, що індексуються, і оцінюють наслідки змін. Такий підхід зберігає стабільні адреси там, де вони працюють, та виправляє лише ті ділянки, які заважають індексації чи подальшому масштабуванню.
Якщо структура сайту вже розрослася, з'явилися дублі, складні фільтри або неузгоджені URL-адреси, замовте технічний SEO-аудит у Seo-Gen. Ми перевіримо архітектуру, рівні вкладеності, canonical, редиректи та внутрішню перелінковку, після чого підготуємо готове ТЗ на виправлення для розробника.


